Verze Zabbix 8.0 je zde!
Nová verze Zabbix 8.0 LTS přináší řadu zajímavých novinek. Mezi největší patří APM s OpenTelemetry a nový korelační engine CEP. Změny se týkají také monitoringu, uživatelského rozhraní a zabezpečení. Níže najdete přehled hlavních funkcí a jejich praktického využití.
| Kontaktujte nás pro konzultaci zdarma | KONTAKTUJTE NÁS PRO KONZULTACI A UKÁZKU ZDARMA |
|
Připravili jsme pro vás tematické webináře |
|
| Školení pro poslední LTS verzi (Zabbix 8.0) | VÍCE INFORMACÍ O ŠKOLENÍ |
| Prohlédněte si naše DEMO Zabbixu jako host, bez registrace. | PŘIHLÁSIT SE DO DEMO ZABBIXU |
APM a OpenTelemetry: traces, metriky a logy přímo v Zabbixu
Největší architektonická novinka 8.0 se dá shrnout jednou větou: Zabbix začíná přijímat OpenTelemetry data. Aplikace instrumentované OpenTelemetry SDK nebo OpenTelemetry Collector posílají traces, metriky a logy do Zabbix proxy, která zajišťuje vestavěný příjem OTLP/gRPC a ukládá data do ClickHouse. Zabbix server vlastní OTLP collector nemá: uložená data čte pomocí položek Telemetry query a vytváří z nich hodnoty pro triggery, grafy a upozornění. Frontend data prohlíží v pohledech Traces, Metrics a Logs. Zabbix tím vstupuje do oblasti APM (Application Performance Monitoring), kde dosud bylo potřeba sáhnout po Jaegeru, Tempu nebo komerčních nástrojích.
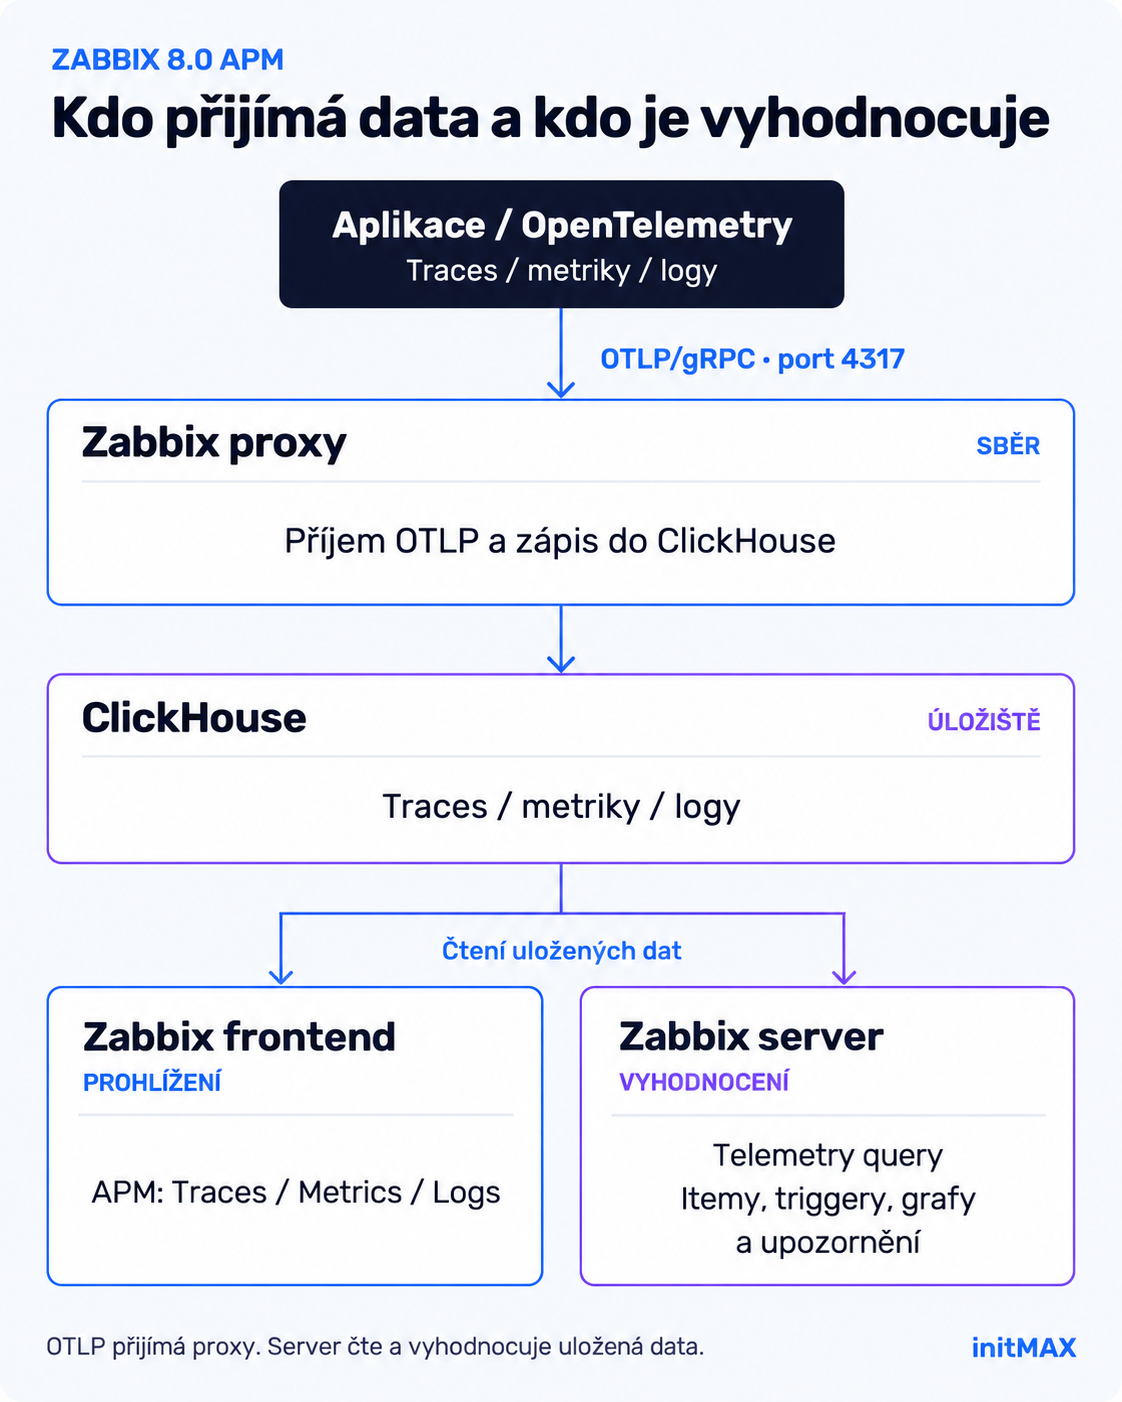
Proxy je tedy potřeba pro vestavěný příjem OTLP, nikoli pro samotné čtení telemetrie serverem. Může běžet na stejném stroji jako Zabbix server; samostatný server nebo virtuální stroj není podmínkou. Pokud data do kompatibilních telemetrických tabulek ClickHouse zapisuje jiný collector, Zabbix server je může číst i bez sběru přes Zabbix proxy. Položky Telemetry query umí vykonávat i proxy.
Trace zachycuje průchod jednoho požadavku aplikací. Skládá se ze spanů, tedy jednotlivých operací, například zpracování HTTP požadavku, dotazu do databáze nebo volání platební brány. Společné Trace ID a vazby mezi rodičovskými a podřízenými spany spojují tyto operace do jednoho průchodu. Aby se data sbírala, aplikace musí používat OpenTelemetry instrumentaci nebo jiný zdroj OTLP dat; samotná instalace Zabbixu trace nevytvoří.
Skládá se to ze tří částí, které dohromady tvoří jeden řetězec:
- Sběr: OTLP/gRPC collector v Zabbix proxy (výchozí port
4317). - Prohlížení: nová sekce hlavního menu APM s pohledy Traces, Metrics a Logs nad globálním APM datovým zdrojem.
- Zpracování: nový typ itemu Telemetry query, který z telemetrických dat dělá hodnoty pro triggery, grafy a dashboardy.
Sběr: OpenTelemetry collector v Zabbix proxy
Vestavěný příjem OpenTelemetry dat zajišťuje výhradně proxy. Zabbix server žádný collector nemá a v zabbix_server.conf pro něj nejsou žádné volby; i v prostředí, kde jste dosud proxy nepotřebovali, tedy pro vestavěný sběr jednu nasadíte. Proxy dostává nový proces APM manager s OTLP/gRPC rozhraním a zapisuje přijatá data do ClickHouse. APM úložiště a volitelný ClickHouse backend pro běžnou historii položek jsou přitom dvě samostatná nastavení. Konfigurace je v zabbix_proxy.conf:
StartAPMCollector=1
APMListenIP=0.0.0.0
APMListenPort=4317
TelemetryProvider=clickhouse;url=http://clickhouse:8123,db=zabbix,username=zabbix,password=zabbix
# TLS pro OTLP klienty: APMTLSCAFile, APMTLSCertFile, APMTLSKeyFile
Heslo k ClickHouse lze uložit do HashiCorp Vault (vault_path=). Oficiální proxy balíčky pro Debian 12+ a Ubuntu 24.04+ obsahují podporu APM, není nutné kvůli ní automaticky překládat Zabbix. U RHEL 10 a odvozených systémů se používá samostatný APM balíček a odpovídající repozitáře. Pokud sestavujete proxy ze zdrojů, zůstává volba --enable-proxy --with-apm a knihovny gRPC/protobuf. Podporu ověřte pro konkrétní distribuci a balíček.
Vestavěný collector přijímá OTLP/gRPC, standardně na portu 4317. OTLP/HTTP na portu 4318 není jeho druhé rozhraní: exporter musí používat gRPC, případně mezi aplikaci a proxy zařadíte OpenTelemetry Collector, který data předá podporovaným protokolem.
APM nastavení proxy ve frontendu
Vedle konfigurace collectoru přibývá ve formuláři proxy nová záložka APM. Zde se povoluje příjem dat, nastavuje limit exportních zpráv a doplňují atributy prostředí či lokality. Nastavení má dvě části, Input a Process:
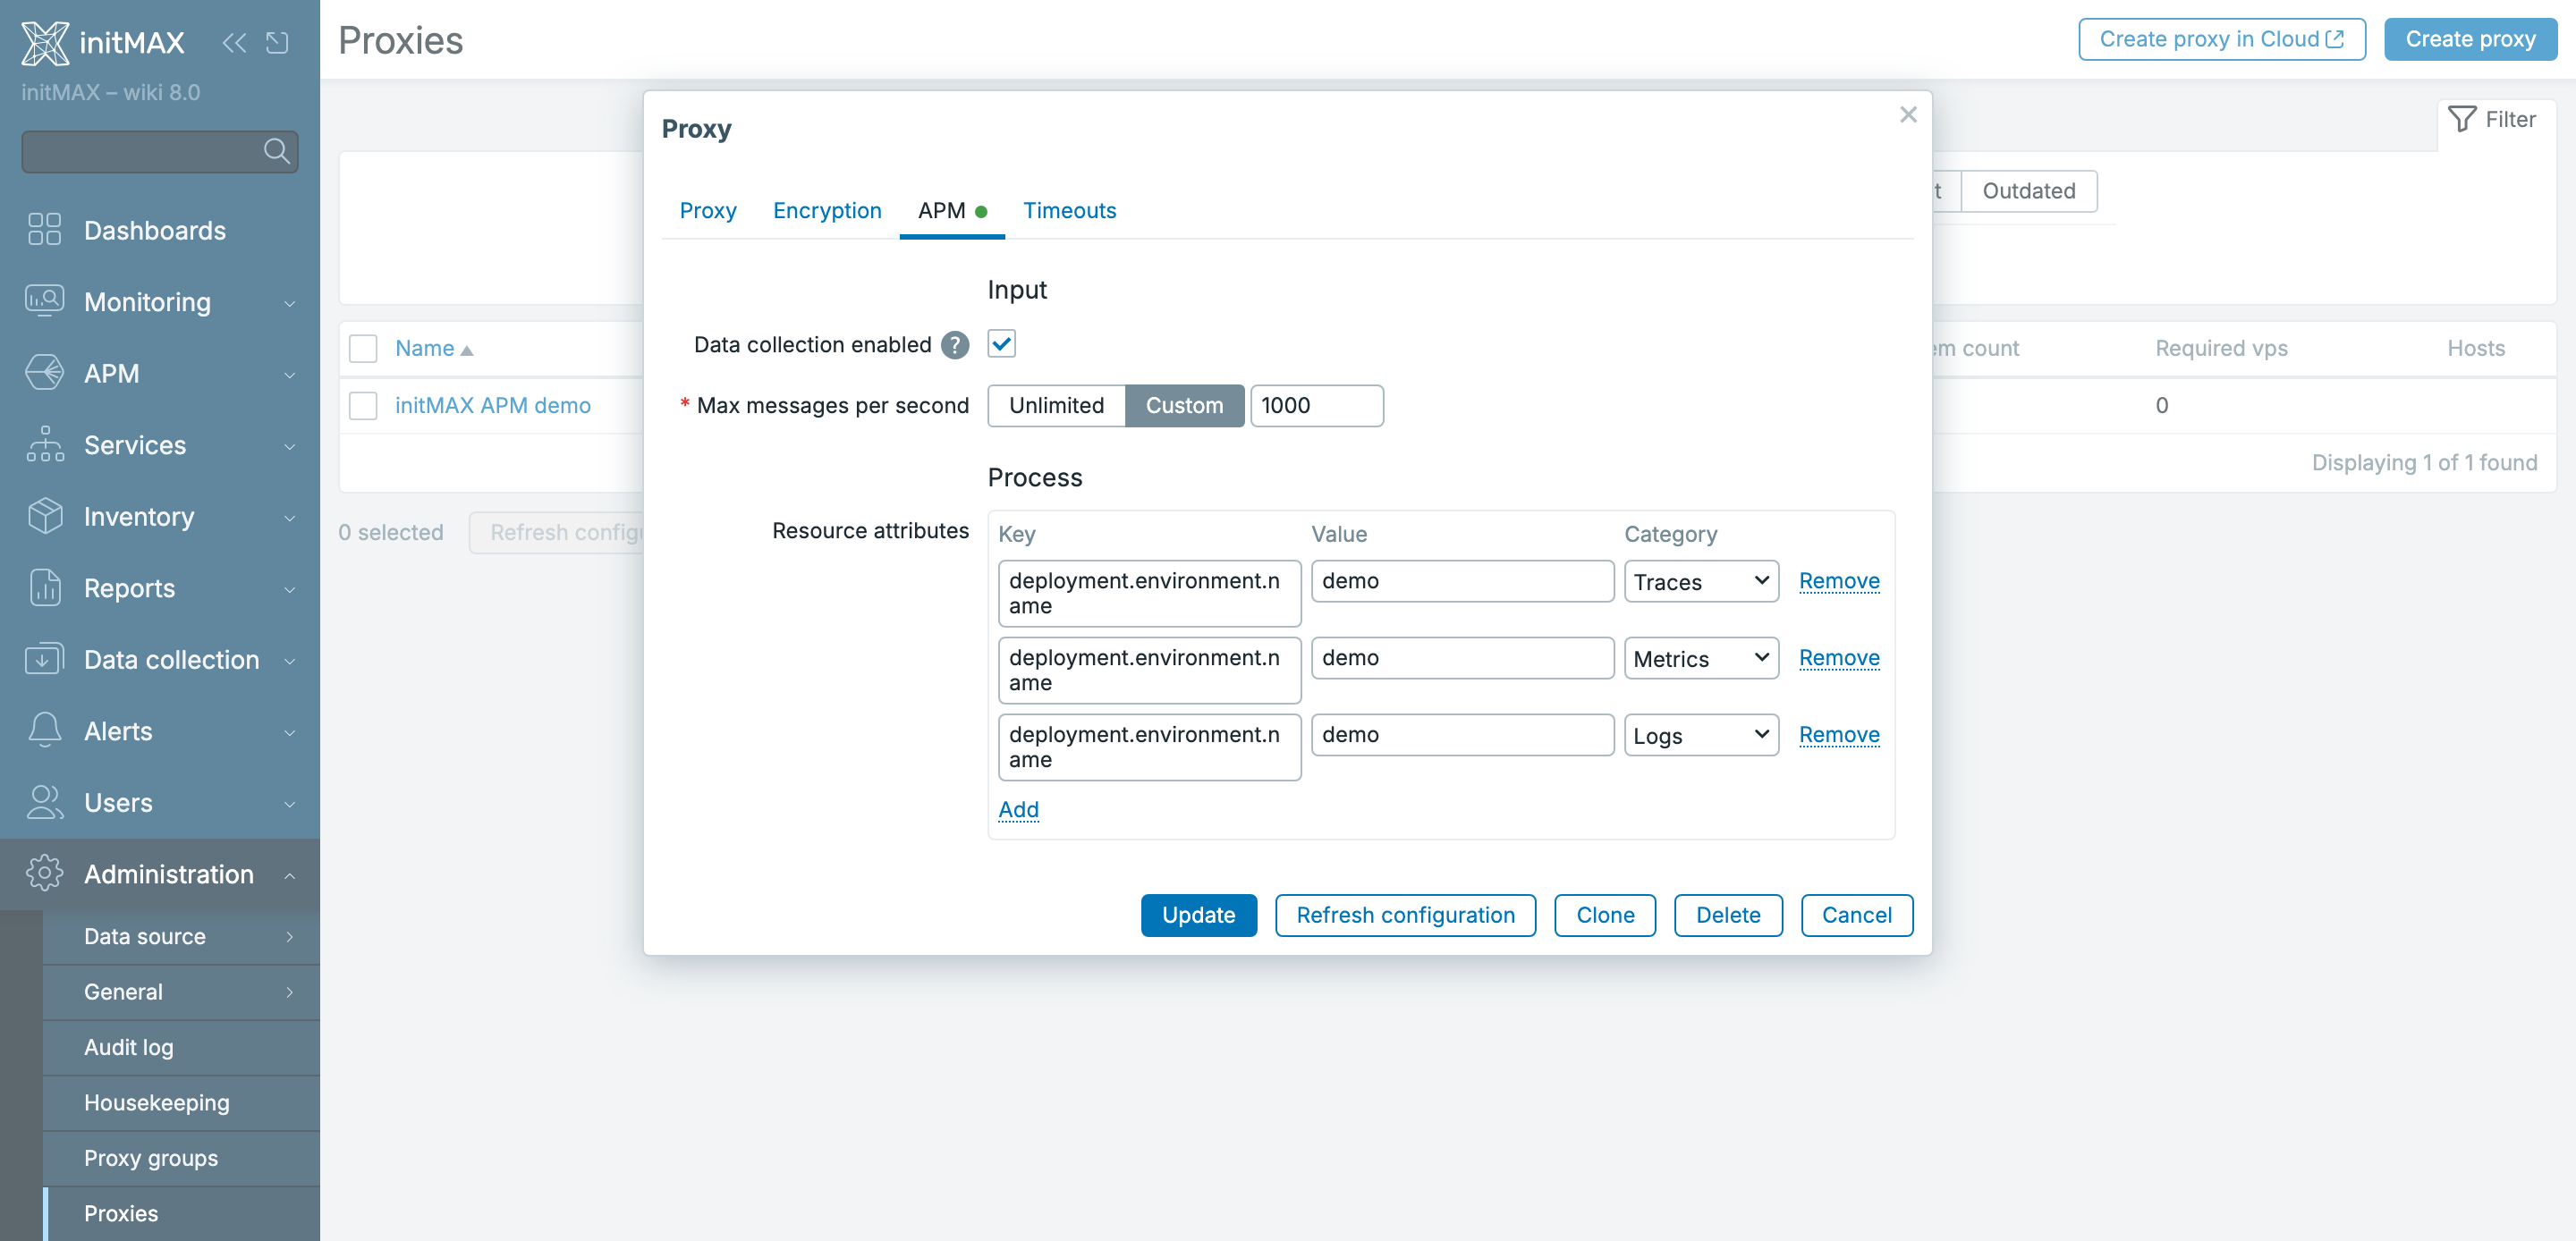
Ve frontendu má proxy nový tab APM rozdělený na dvě části. Input: přepínač Data collection enabled a limit Max messages per second (Unlimited / Custom), aby jedna upovídaná aplikace nezahltila úložiště. Process: tabulka Resource attributes, tedy atributy, které proxy doplní ke všem přijatým datům (například prostředí nebo lokalita), aniž by se musely nastavovat v každé aplikaci. Pokud proxy nemá collector v konfiguračním souboru zapnutý, frontend na to upozorní přímo ve formuláři.
Max messages per second omezuje exportní zprávy, ne počet spanů uvnitř zprávy. Po překročení limitu collector požadavek odmítne; opakování pak závisí na exporteru. Povolení sběru v této záložce a spuštění collectoru v konfiguraci proxy jsou dvě samostatné podmínky.
Prohlížení: Traces, Metrics a Logs
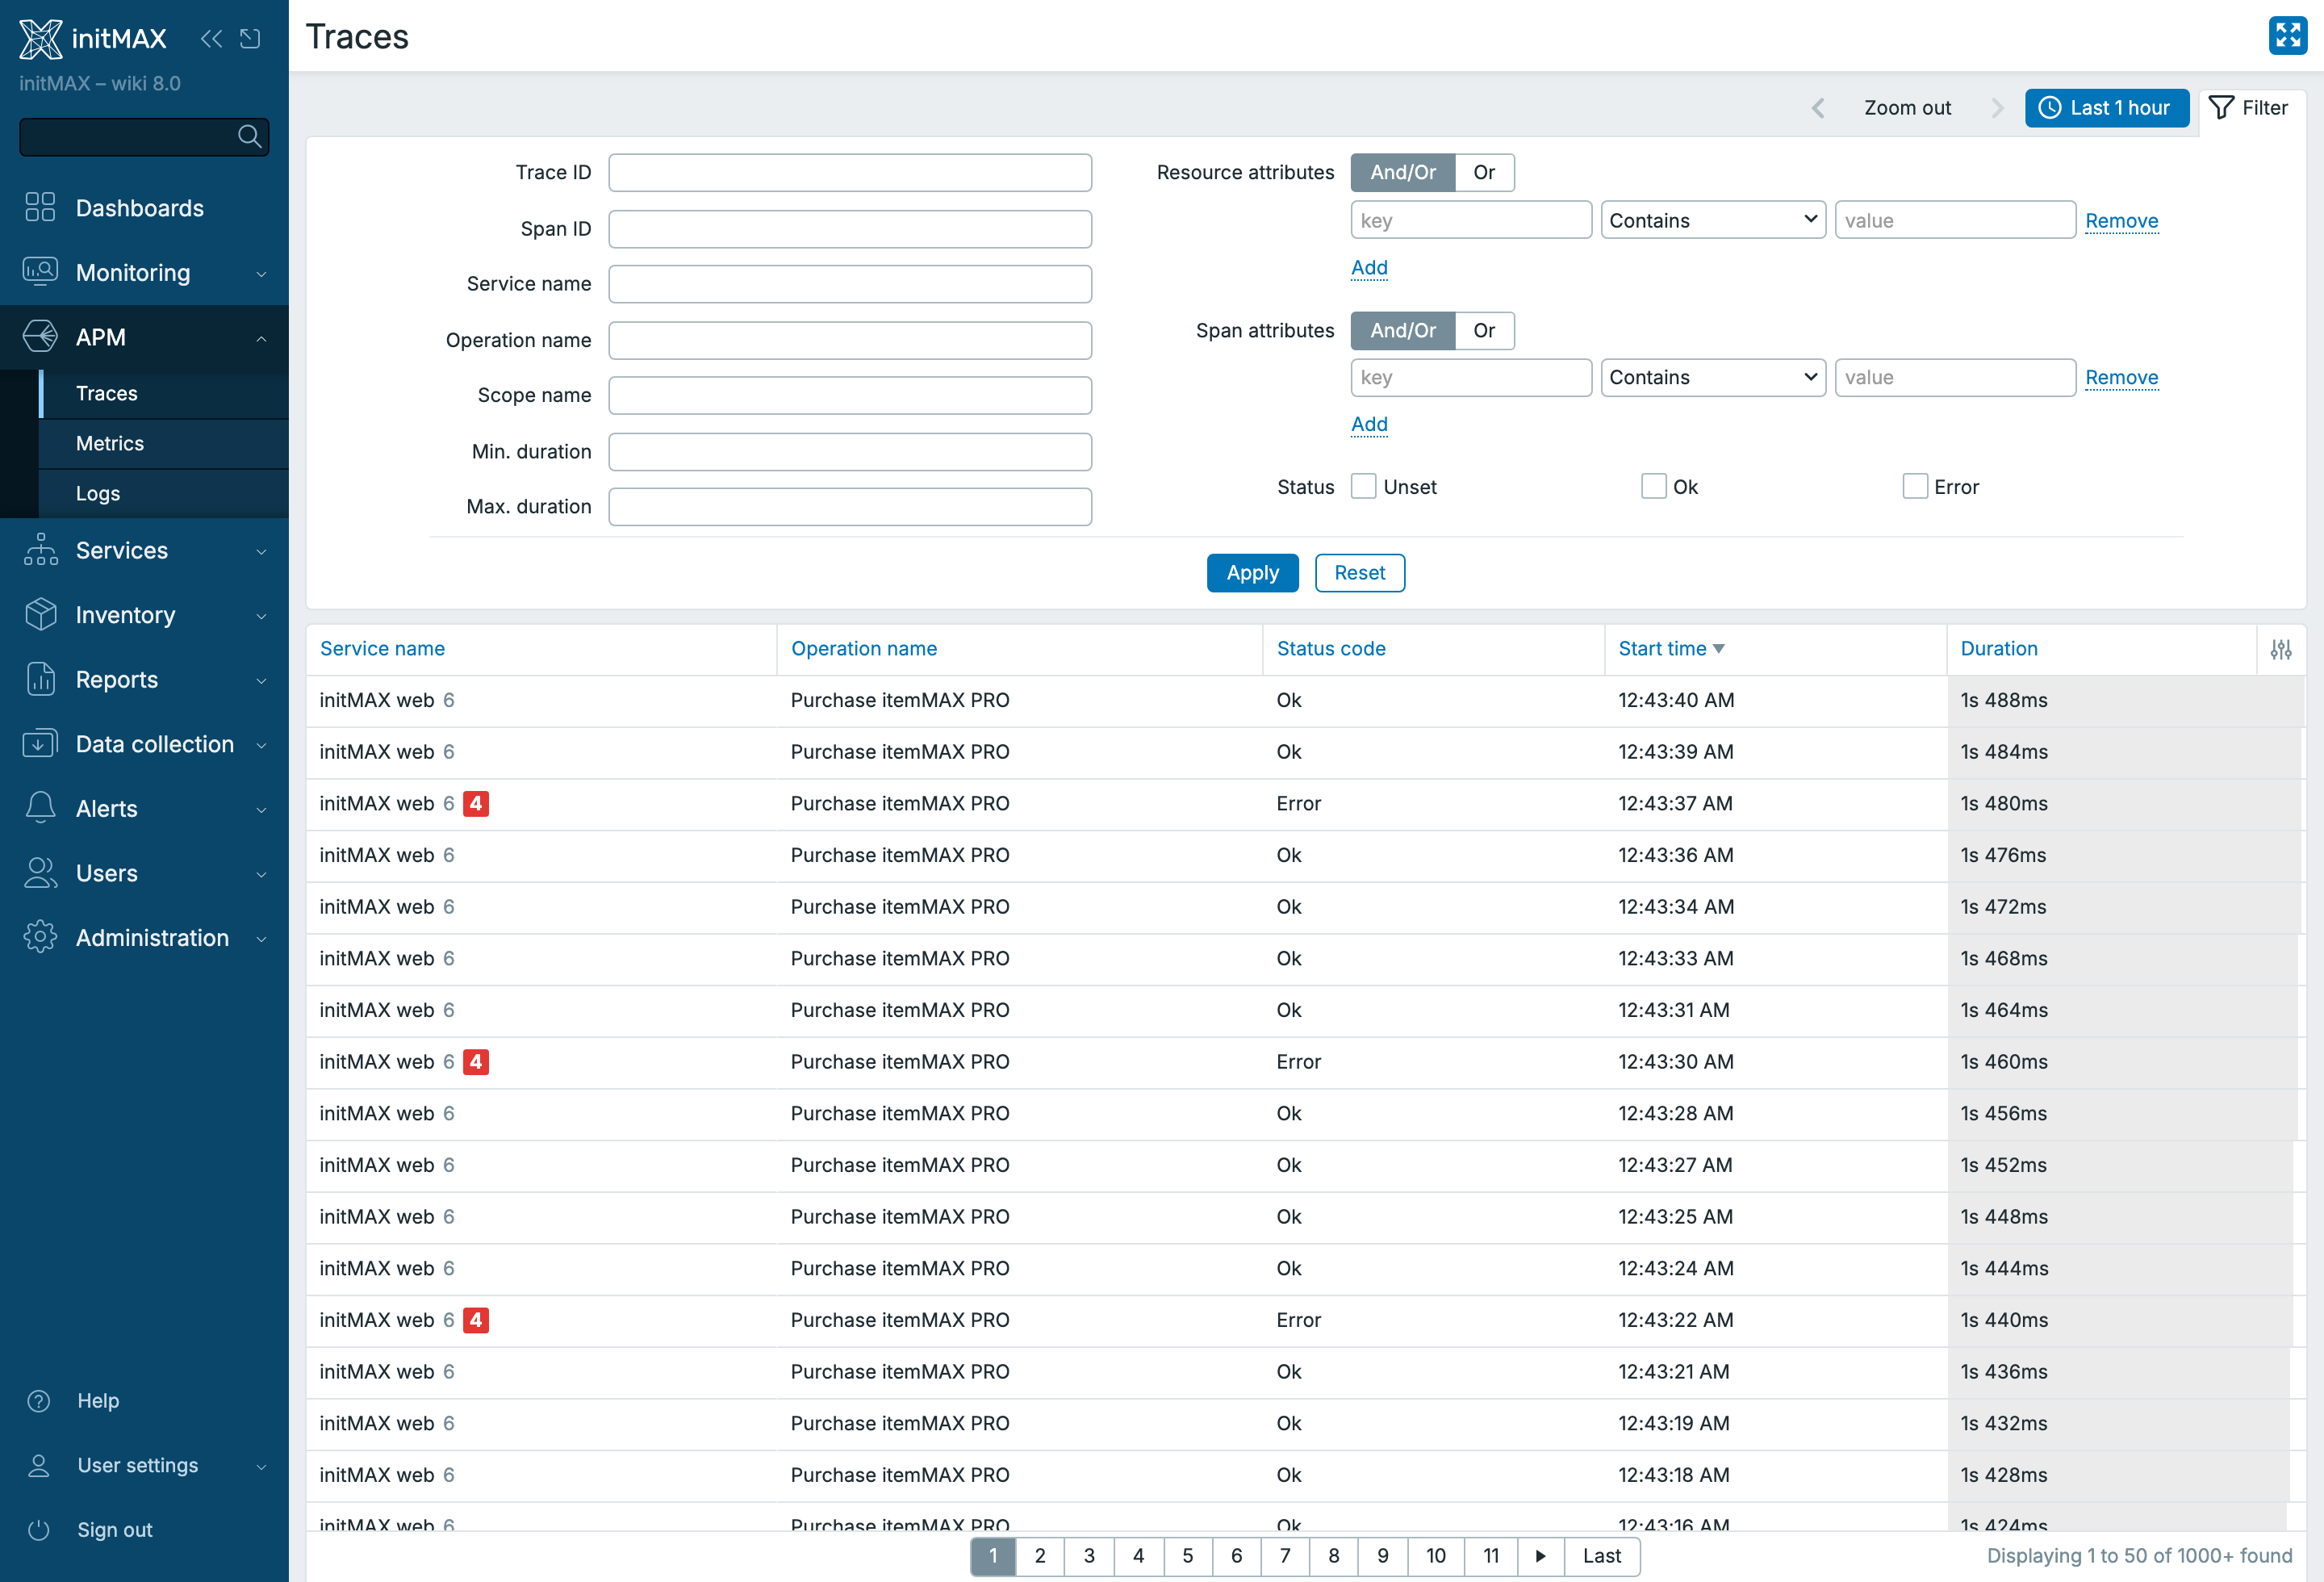
V hlavním menu přibývá hned pod Monitoring nová sekce APM se třemi pohledy. Traces filtruje podle Trace ID, Span ID, názvu služby a operace, scope, délky trvání (min/max), stavu (Ok / Error / Unset) a libovolných atributů s logikou And/Or a vypisuje celé traces s počtem spanů, chybami, časem startu a dobou trvání. První snímek ukazuje seznam traces modelového nákupu itemMAX PRO na webu initMAX a následující snímek stejný pohled zúžený na pomalá volání platební brány. Logs hledá v těle záznamu, podle severity (Trace až Fatal) a atributů a přes Trace ID / Span ID propojí log se související trace. Metrics filtruje metriky podle názvu, typu, služby a scope. Všechny tři pohledy používají stejný časový výběr jako zbytek Zabbixu.
Ukázka vychází z našich služeb: itemMAX na webu initMAX, e-shopu a portálu initMAX. Modelový požadavek propojuje přípravu objednávky, ověření produktu v katalogu portálu a testovací platbu. Jde o simulovaná OpenTelemetry data, nikoli záznam skutečného nákupu, výpadku nebo přesný popis produkční architektury.
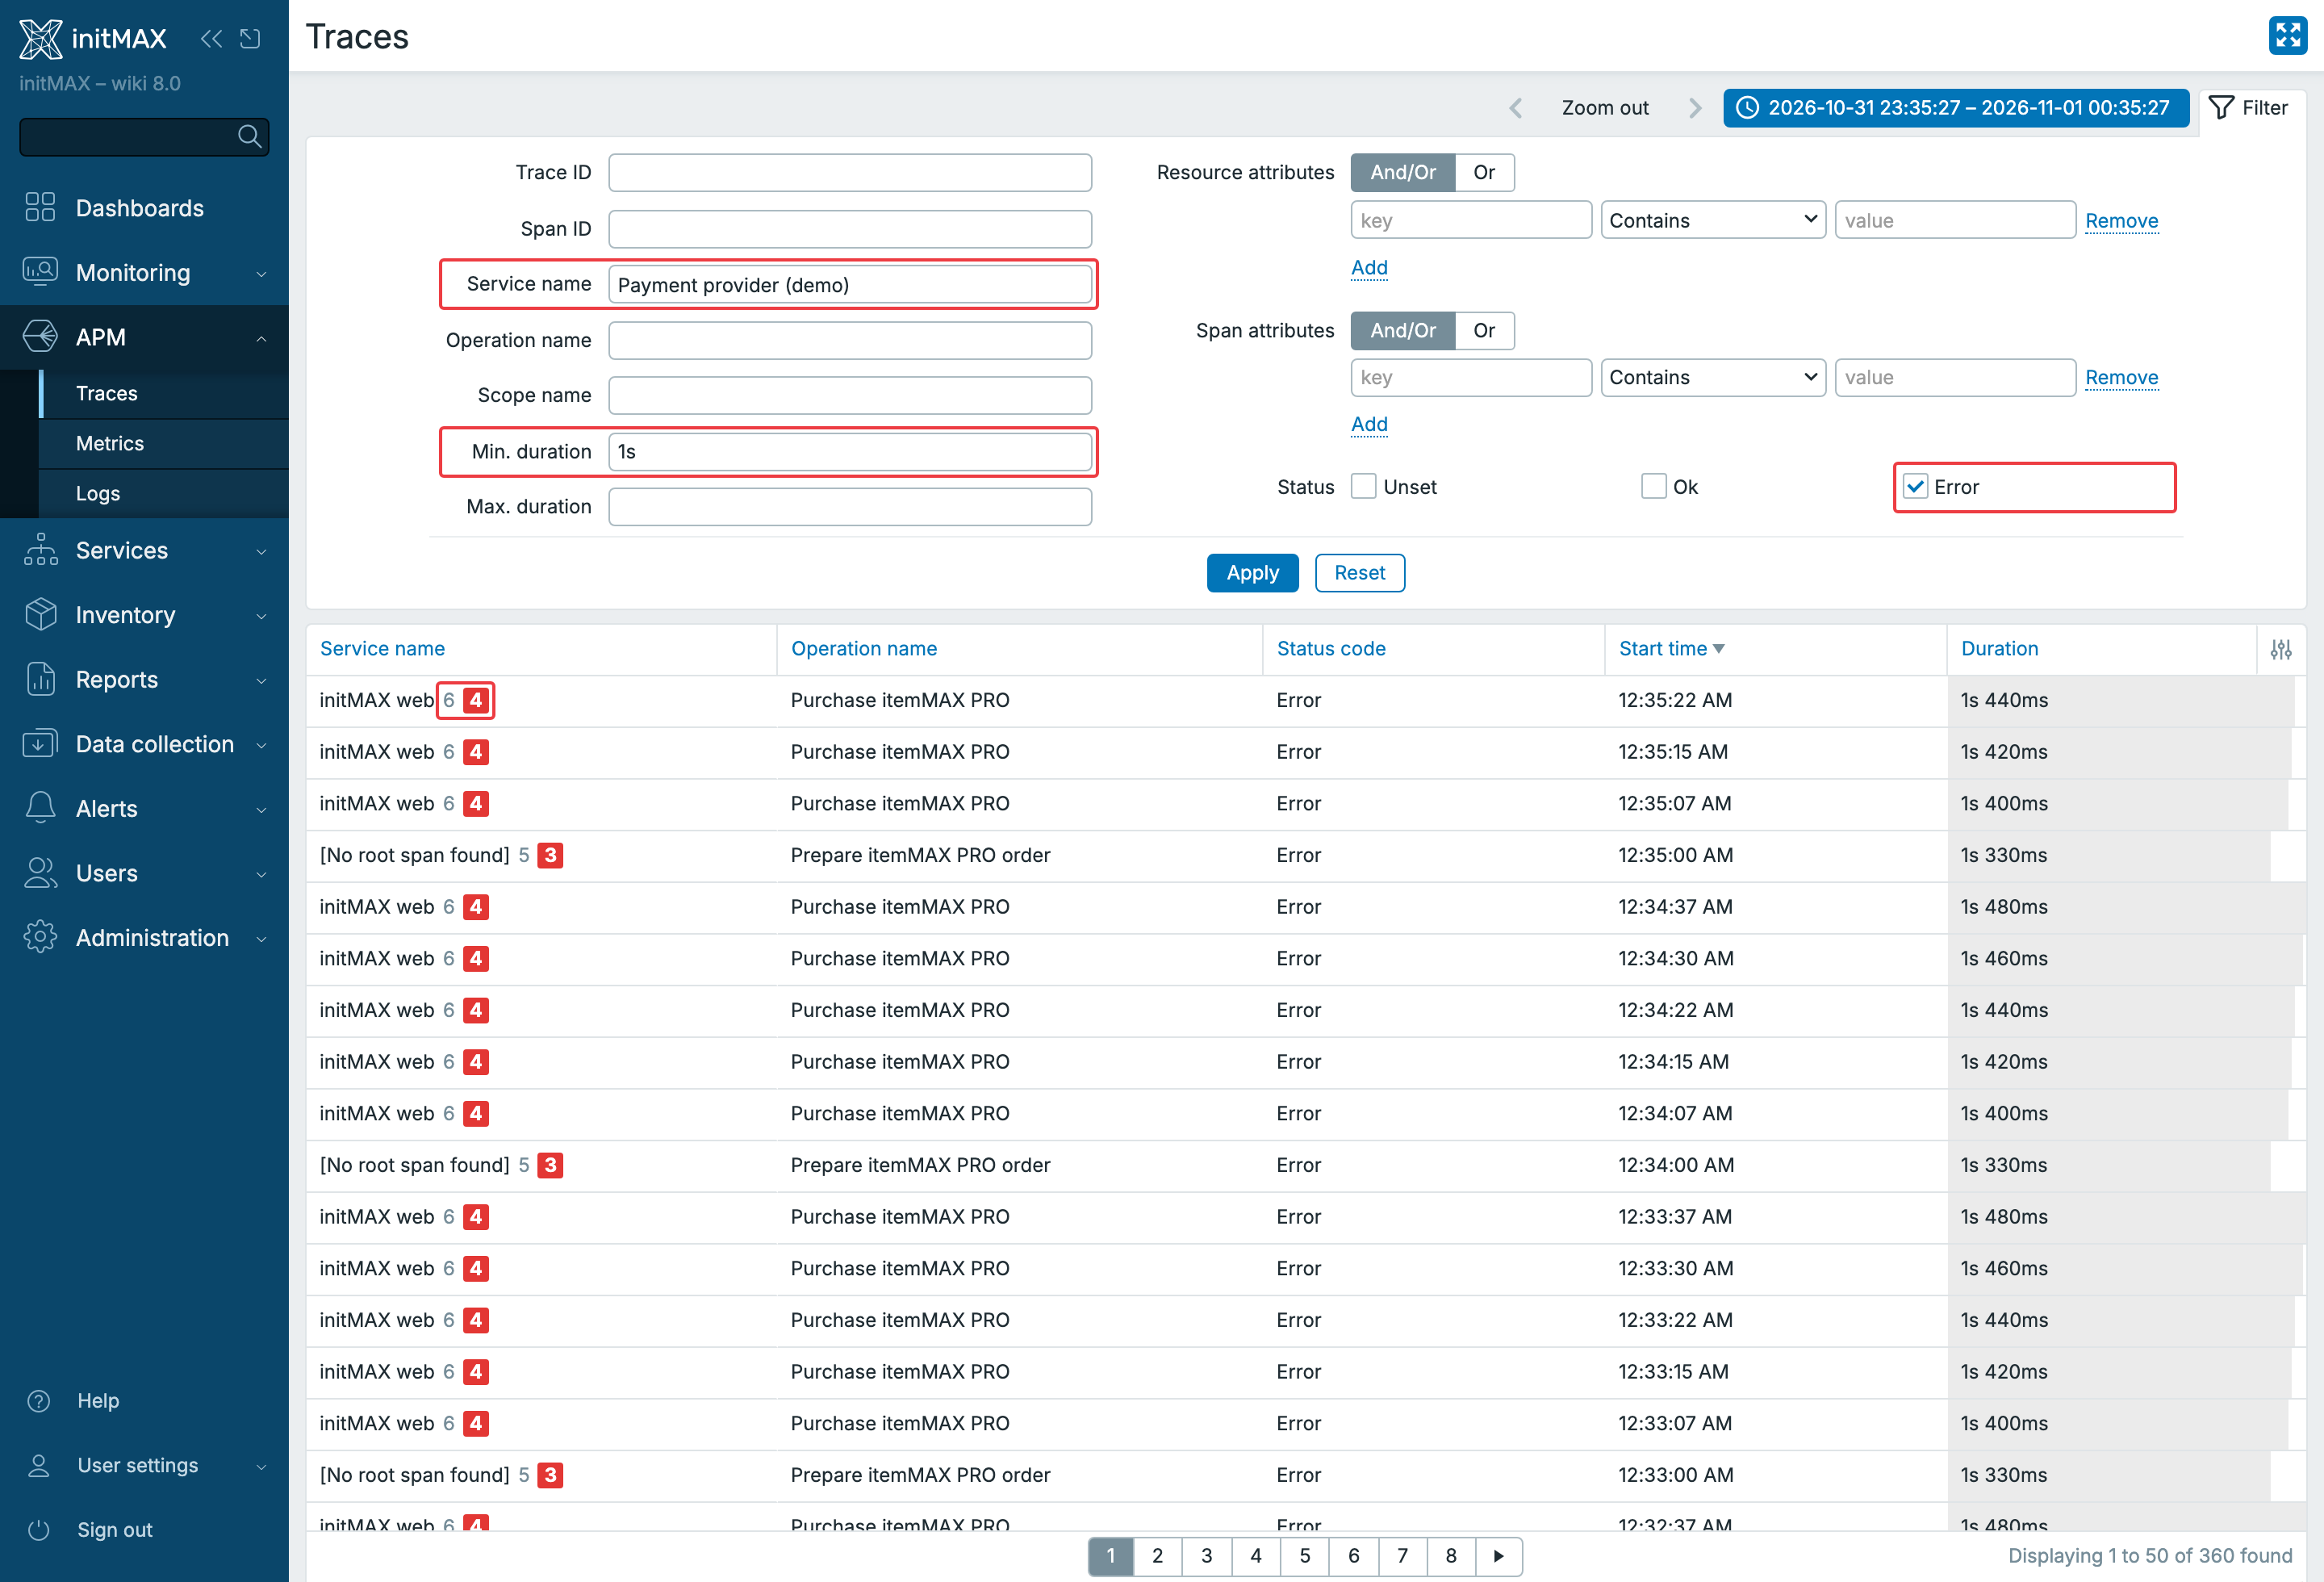
Filtr služby hledá i uvnitř trace, seznam ale ukazuje celý požadavek. Proto při filtru Service name = Payment provider (demo) a Min. duration = 1s vidíte řádky služby initMAX web: právě tam modelový požadavek začal. Číslo 6 označuje počet spanů v trace, červené 4 počet chybových spanů. Detail ukáže, kde čekání na testovací platební službu prodloužilo nákup itemMAX PRO.
Trace bez kořenového spanu
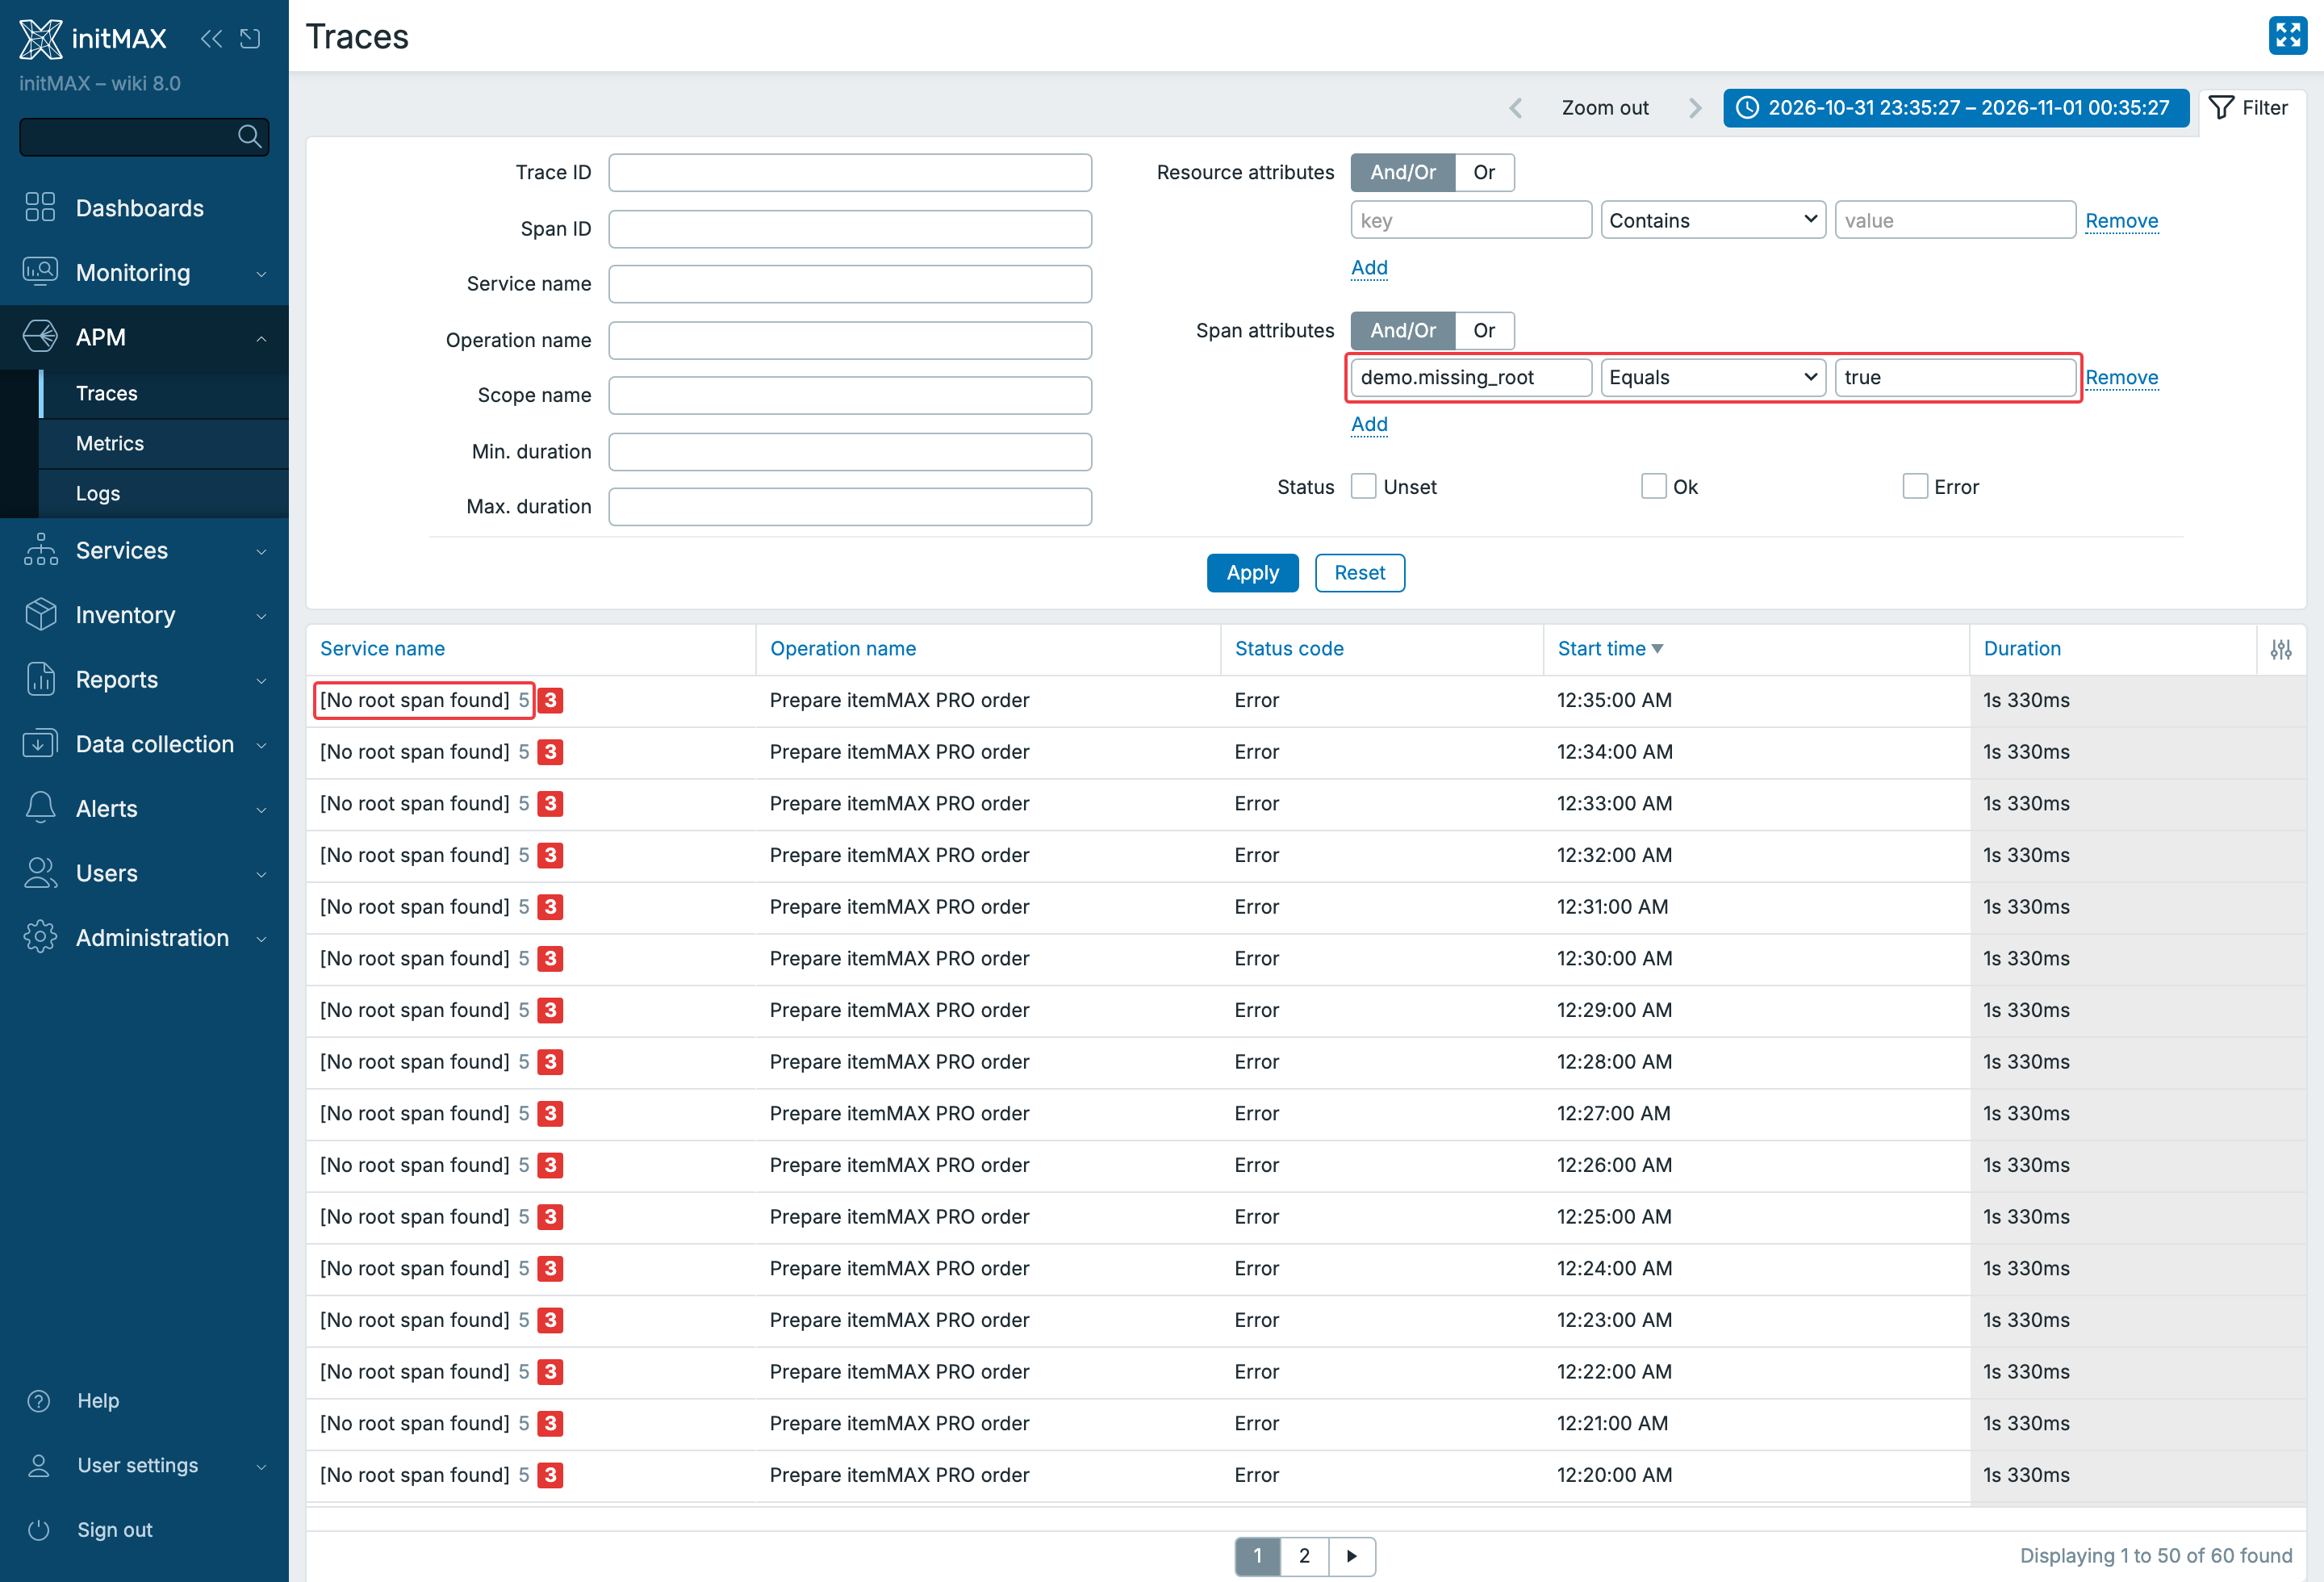
Trace může dorazit nekompletní, například kvůli chybějící instrumentaci vstupní služby nebo ztracené exportní dávce. Zabbix ho zobrazí s označením No root span found. V našem syntetickém příkladu záměrně chybí první span z webu; zbývá pět spanů e-shopu, portálu a testovací platby. Chybějící část si Zabbix nedomýšlí a naměřený úsek nelze vydávat za úplnou odezvu od vstupu zákazníka.
Detail trace: strom spanů a časová osa
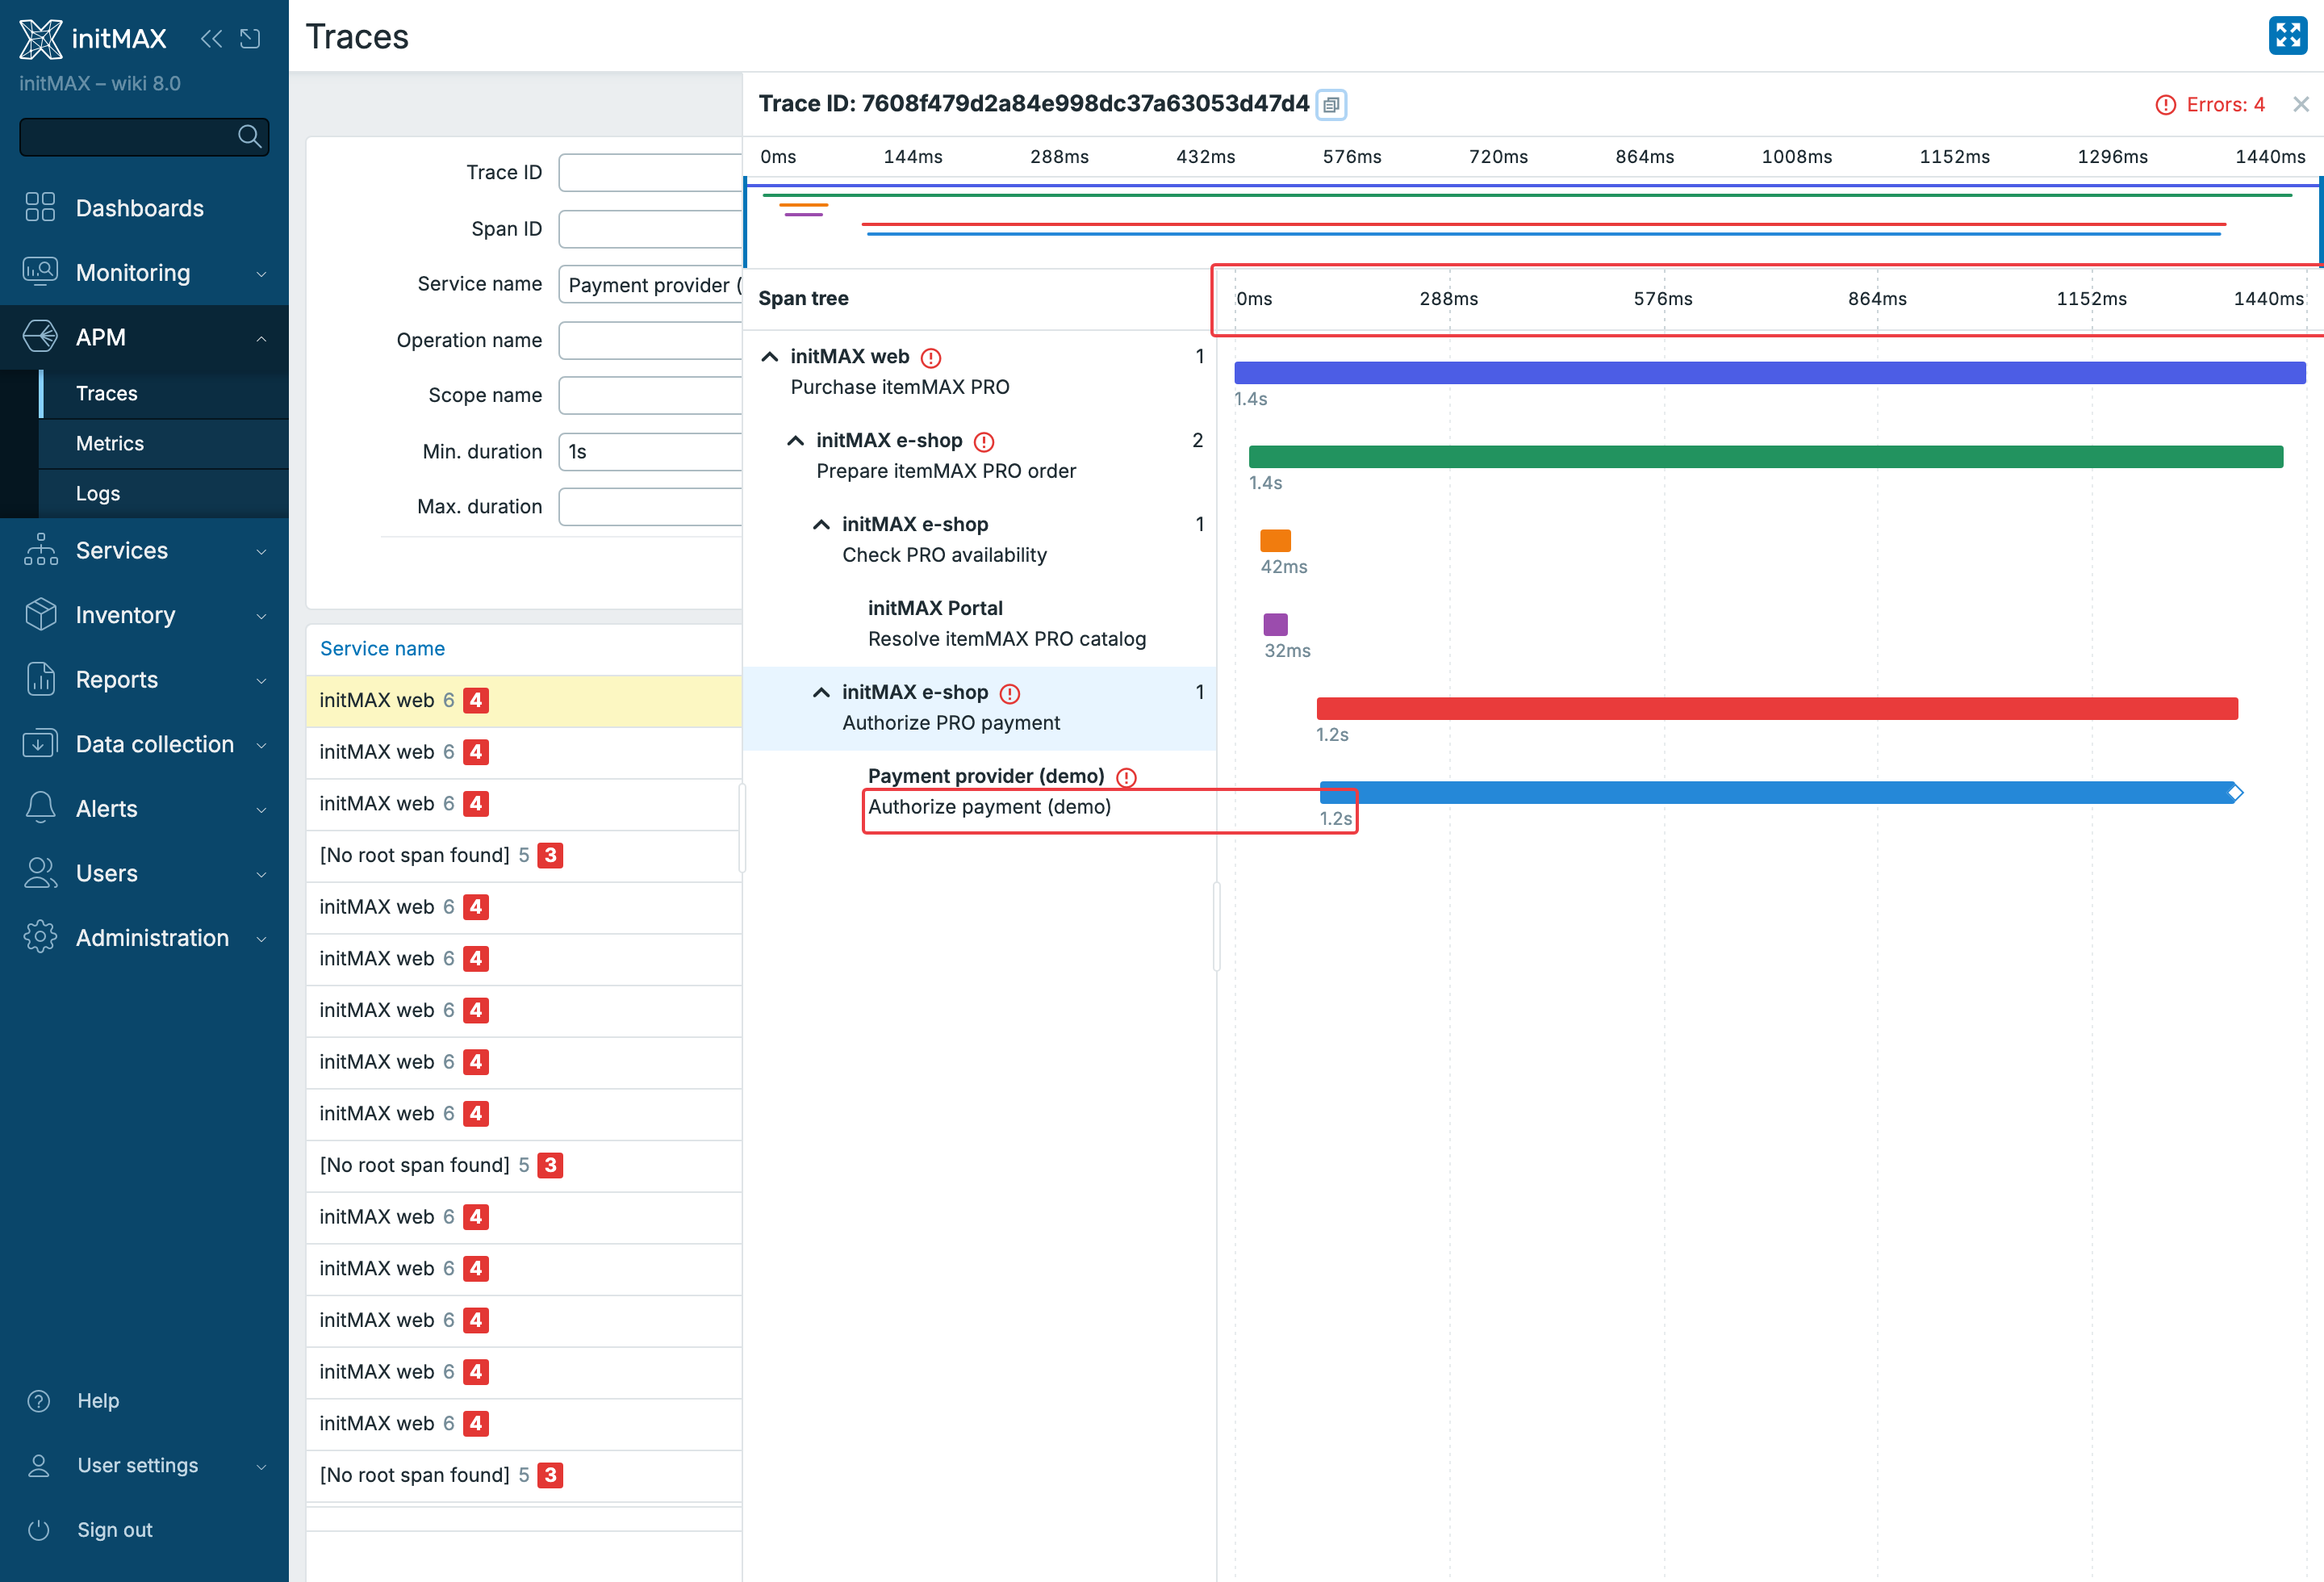
V APM > Traces lze otevřít i detail celého trace. Místo samostatných řádků dostanete strom spanů a waterfall časovou osu: vlevo vidíte návaznost operací, vpravo jejich začátek a délku. Rozbalením větve se dostanete k podřízeným voláním a výběrem rozsahu na časové ose se zaměříte na konkrétní část požadavku.
- Span tree zobrazuje vztahy rodičovských a podřízených operací. Jeden požadavek tak můžete sledovat napříč službami, pokud instrumentace předává trace kontext.
- Waterfall ukazuje, které operace běžely za sebou a které současně. Délky všech spanů proto nelze jednoduše sečíst jako celkovou dobu požadavku.
- Span details obsahuje název operace, službu, scope, čas a délku spanu. Dále ukazuje resource a span attributes a případné události zaznamenané uvnitř spanu.
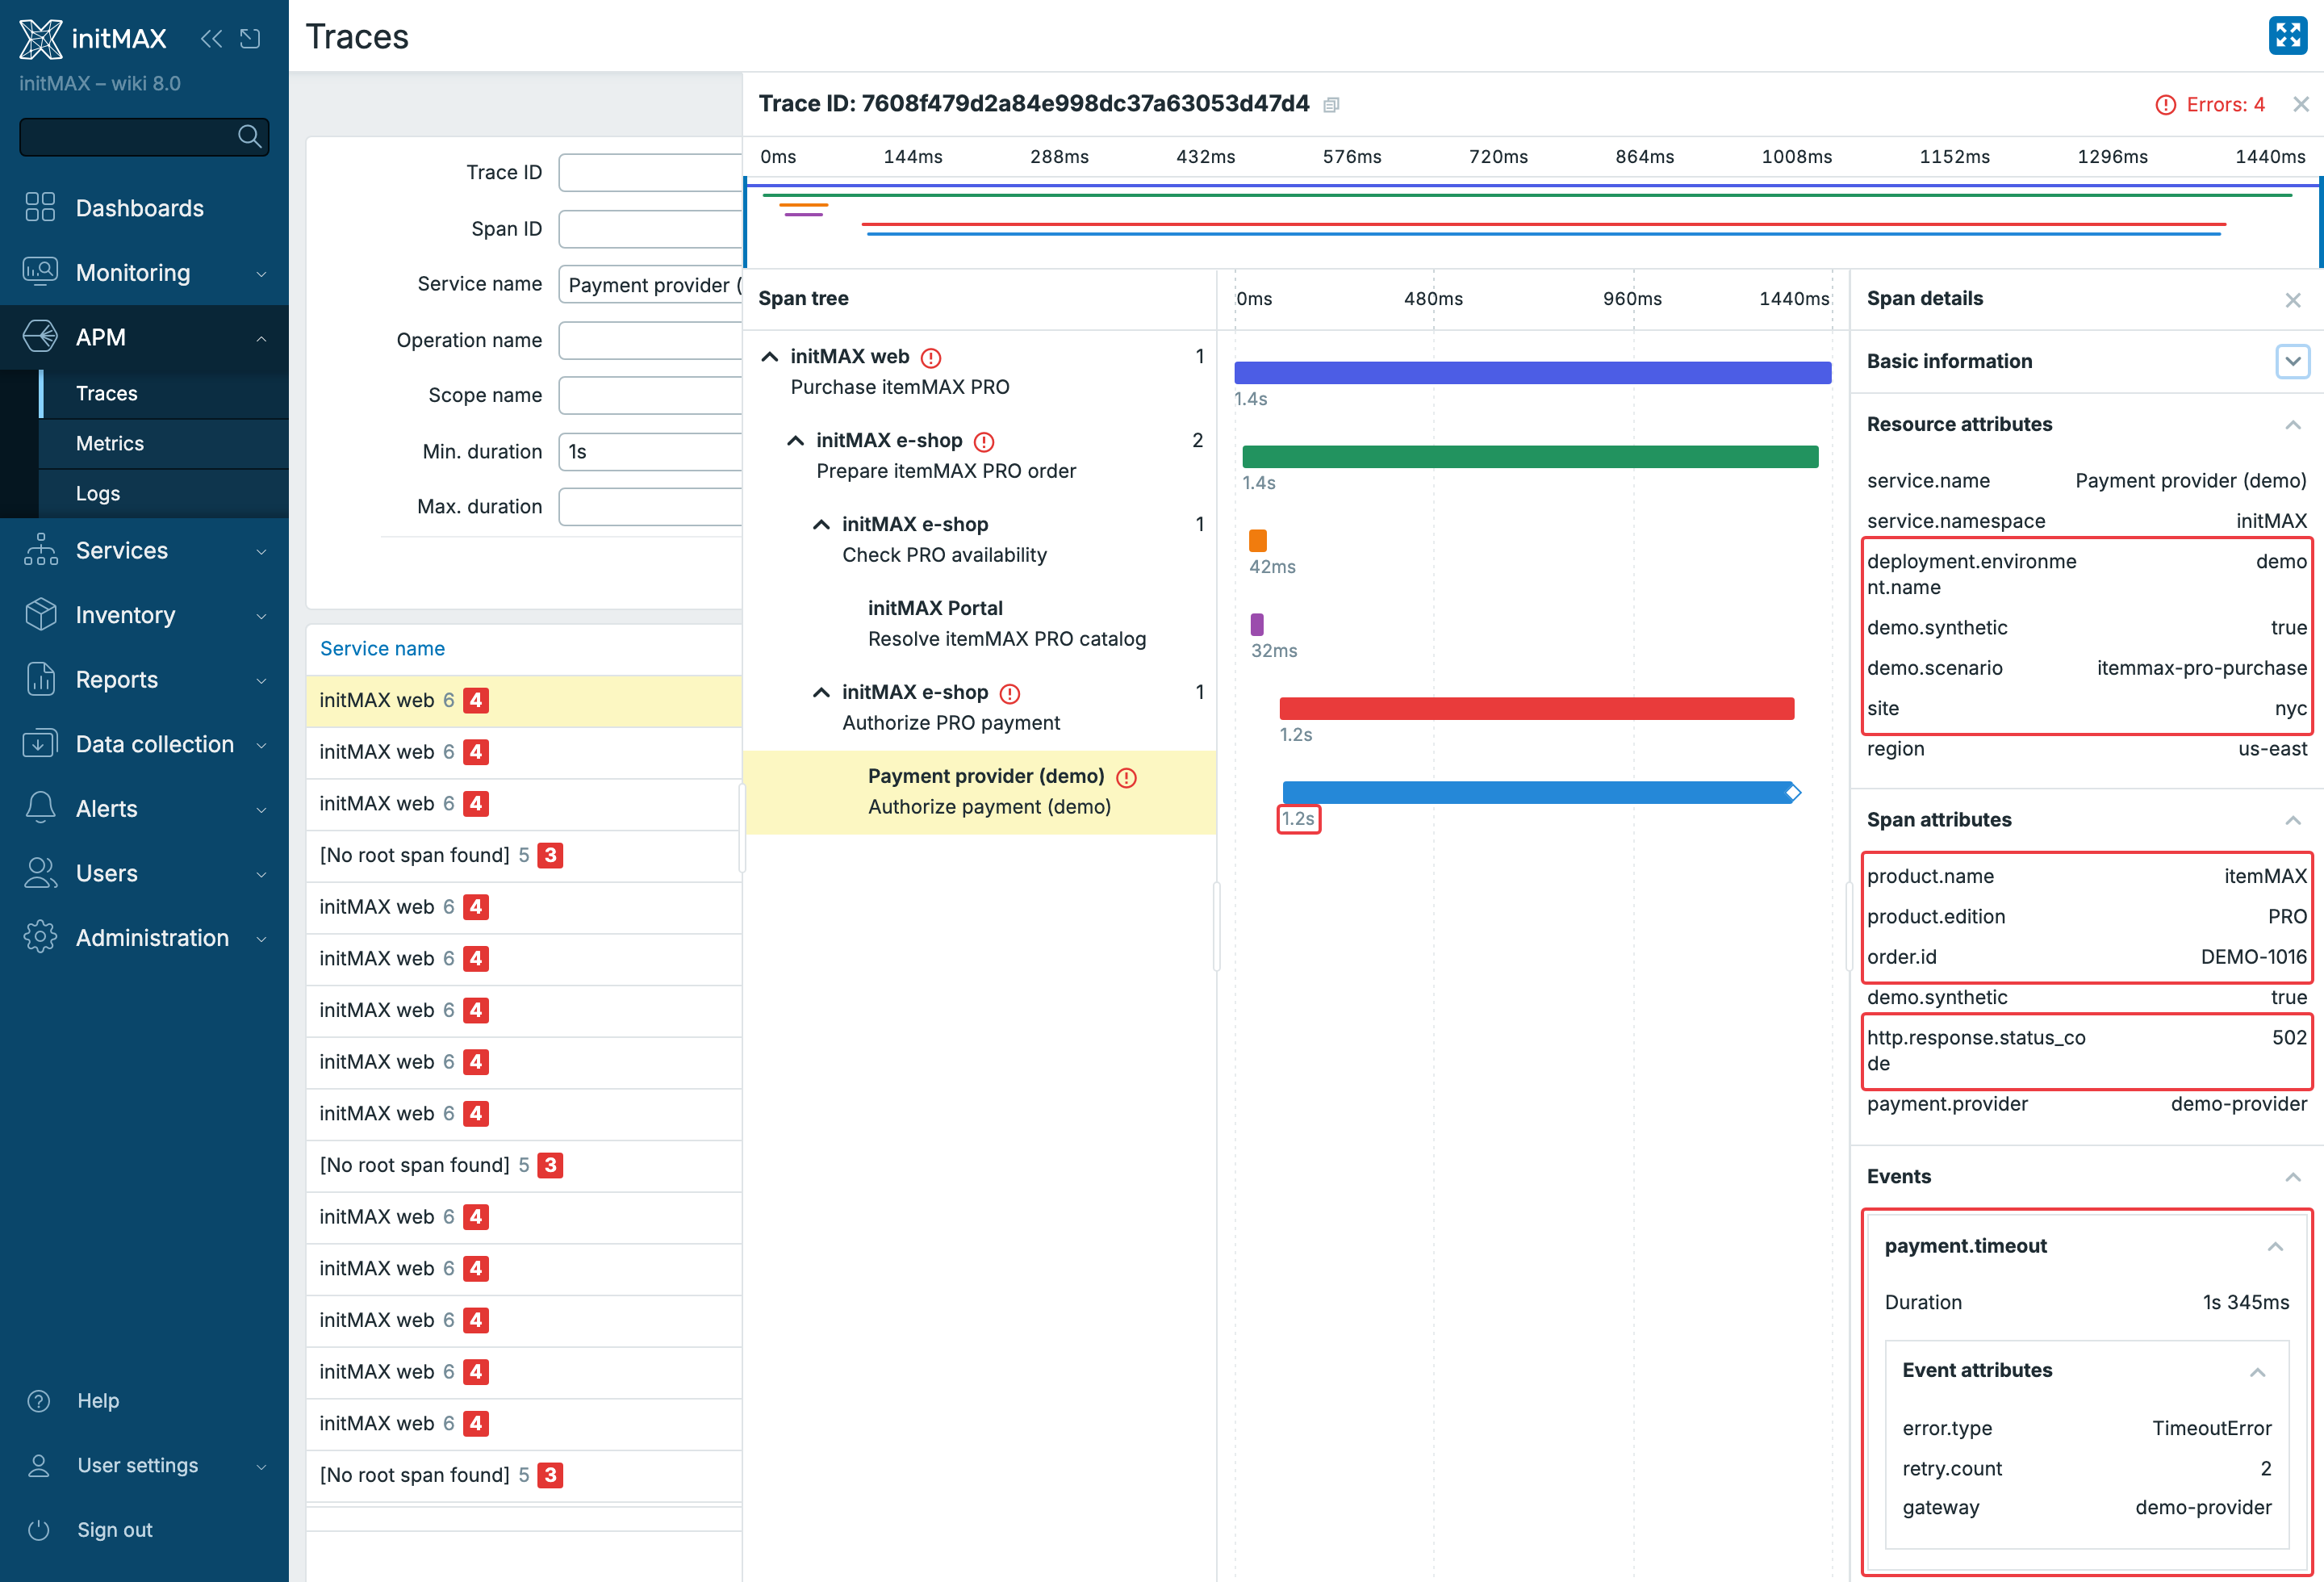
Ve vybraném spanu Payment provider (demo) / Authorize payment (demo) je kromě délky volání vidět HTTP stav 502 a událost payment.timeout. Resource attributes popisují službu a prostředí, například deployment.environment.name=demo a lokalitu nyc. Span attributes patří konkrétní operaci: zde produkt itemMAX, edice PRO a testovací objednávka. Events doplňují události uvnitř spanu, zde TimeoutError, retry.count=2 a gateway=demo-provider. Tyto údaje dodává instrumentace, Zabbix je z délky požadavku neodvozuje.
U pomalého checkoutu nejprve vyfiltrujete službu a delší trvání. V detailu trace pak zjistíte, zda většinu času zabral dotaz do databáze, čekání na platební bránu, nebo vlastní zpracování aplikace. Atributy a události vybraného spanu doplní konkrétní kontext chyby; samotná časová osa příčinu neurčí automaticky.
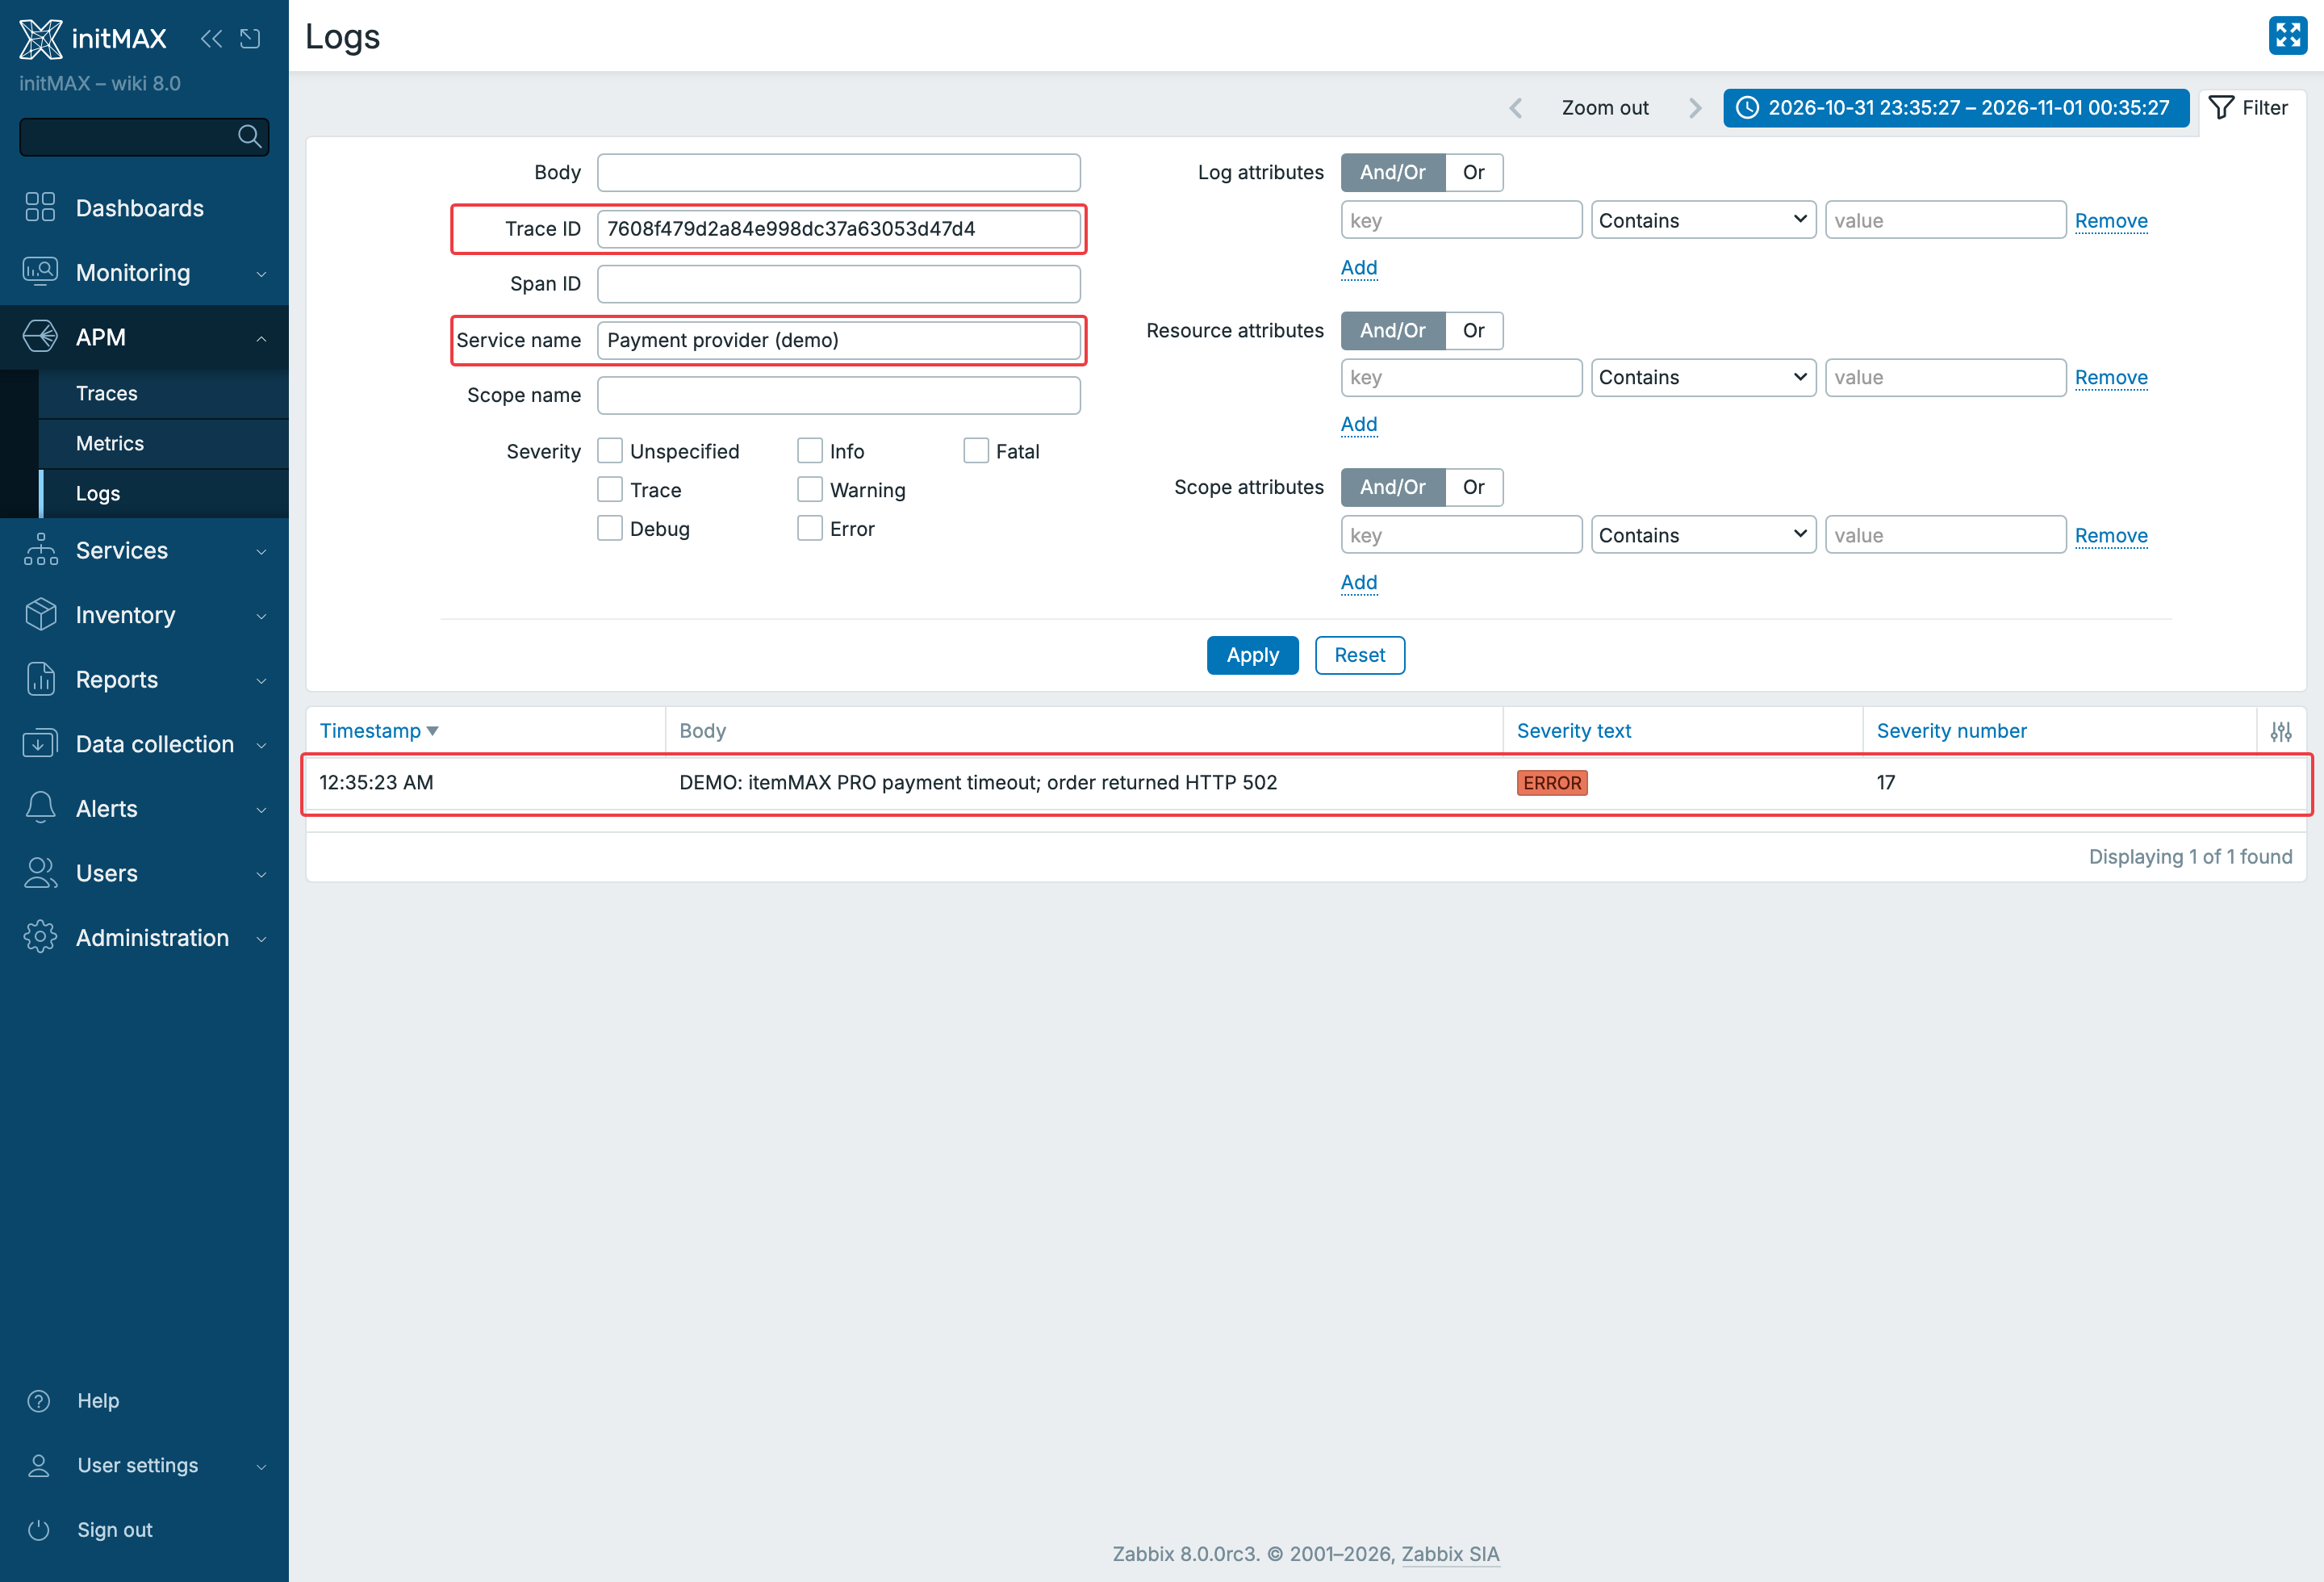
V APM > Logs stejným Trace ID dohledáte zprávu testovací platební služby: DEMO: itemMAX PRO payment timeout; order returned HTTP 502. Filtr propojí konkrétní průchod webem a e-shopem s jeho aplikačním logem. Severity, tělo zprávy a atributy pomáhají upřesnit, co během požadavku nastalo.
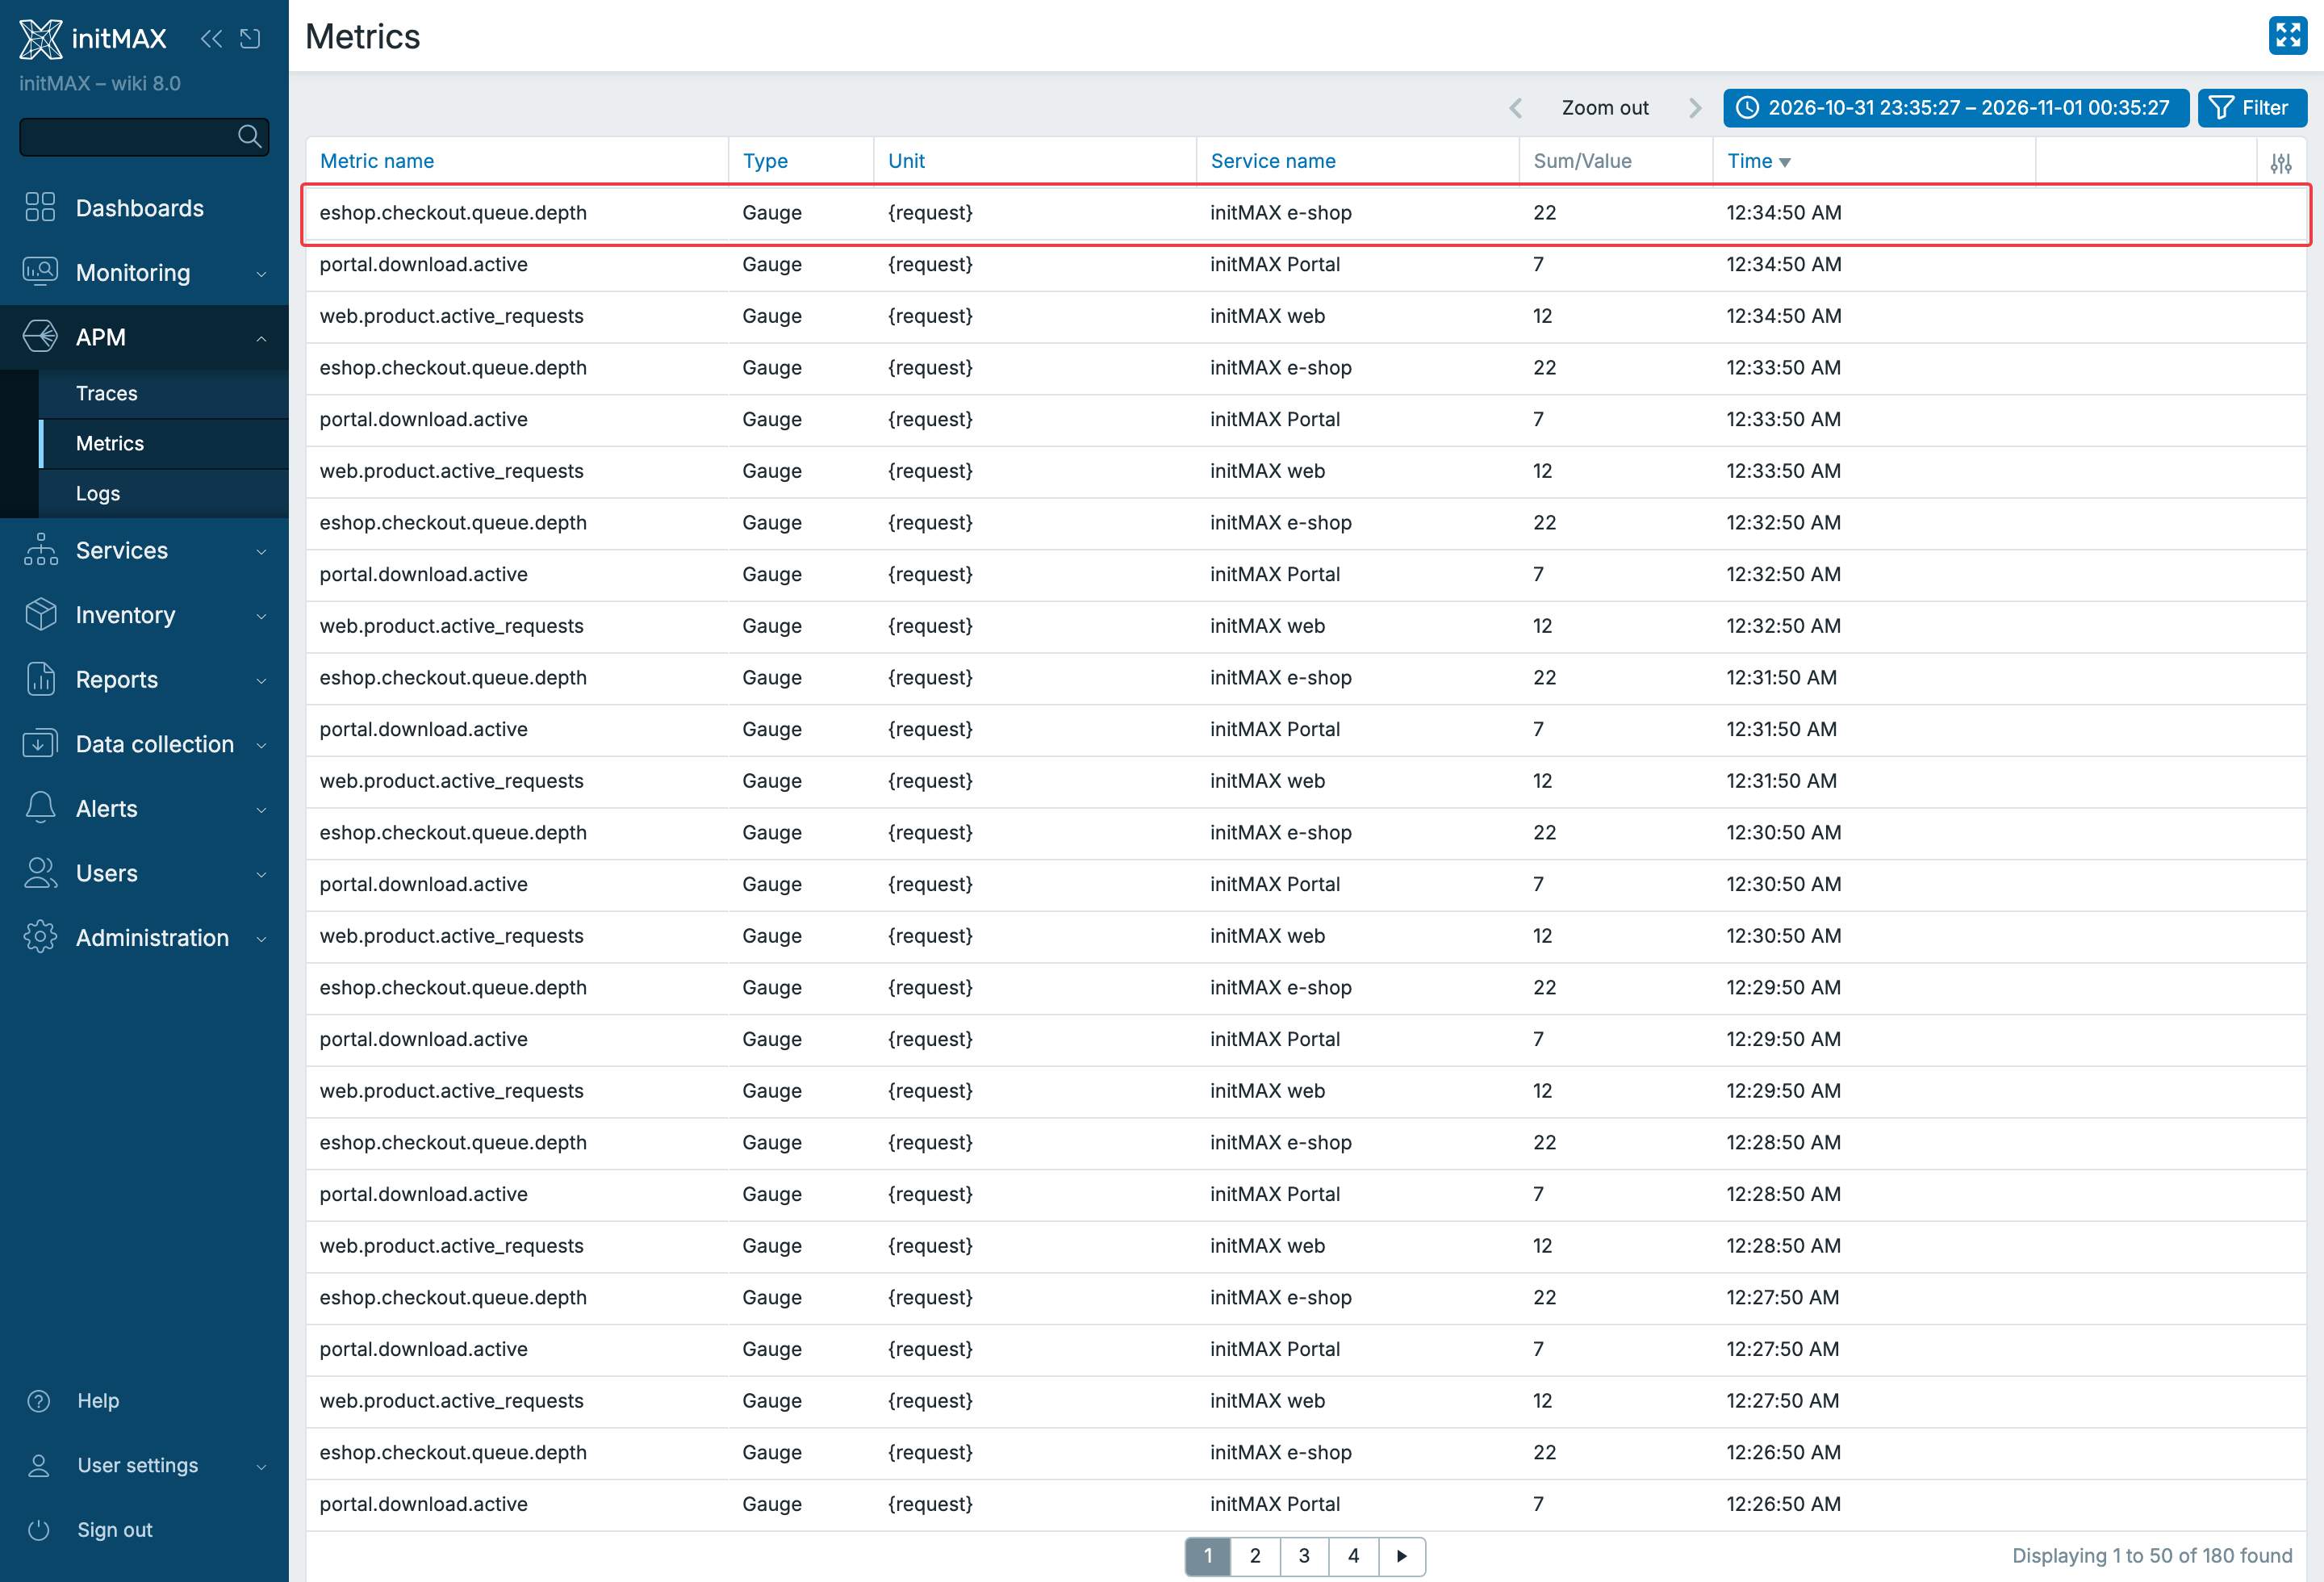
Pohled APM > Metrics doplňuje provozní kontext. Metrika eshop.checkout.queue.depth typu Gauge udává počet čekajících objednávek; vedle ní jsou modelové metriky aktivních požadavků na produktové stránky a stahování z portálu. Na rozdíl od trace popisují stav služby v čase, ne cestu jednoho požadavku. Název metriky, služba a atributy umožní vybrat správnou časovou řadu.
Datový zdroj APM: připojení k telemetrii v ClickHouse
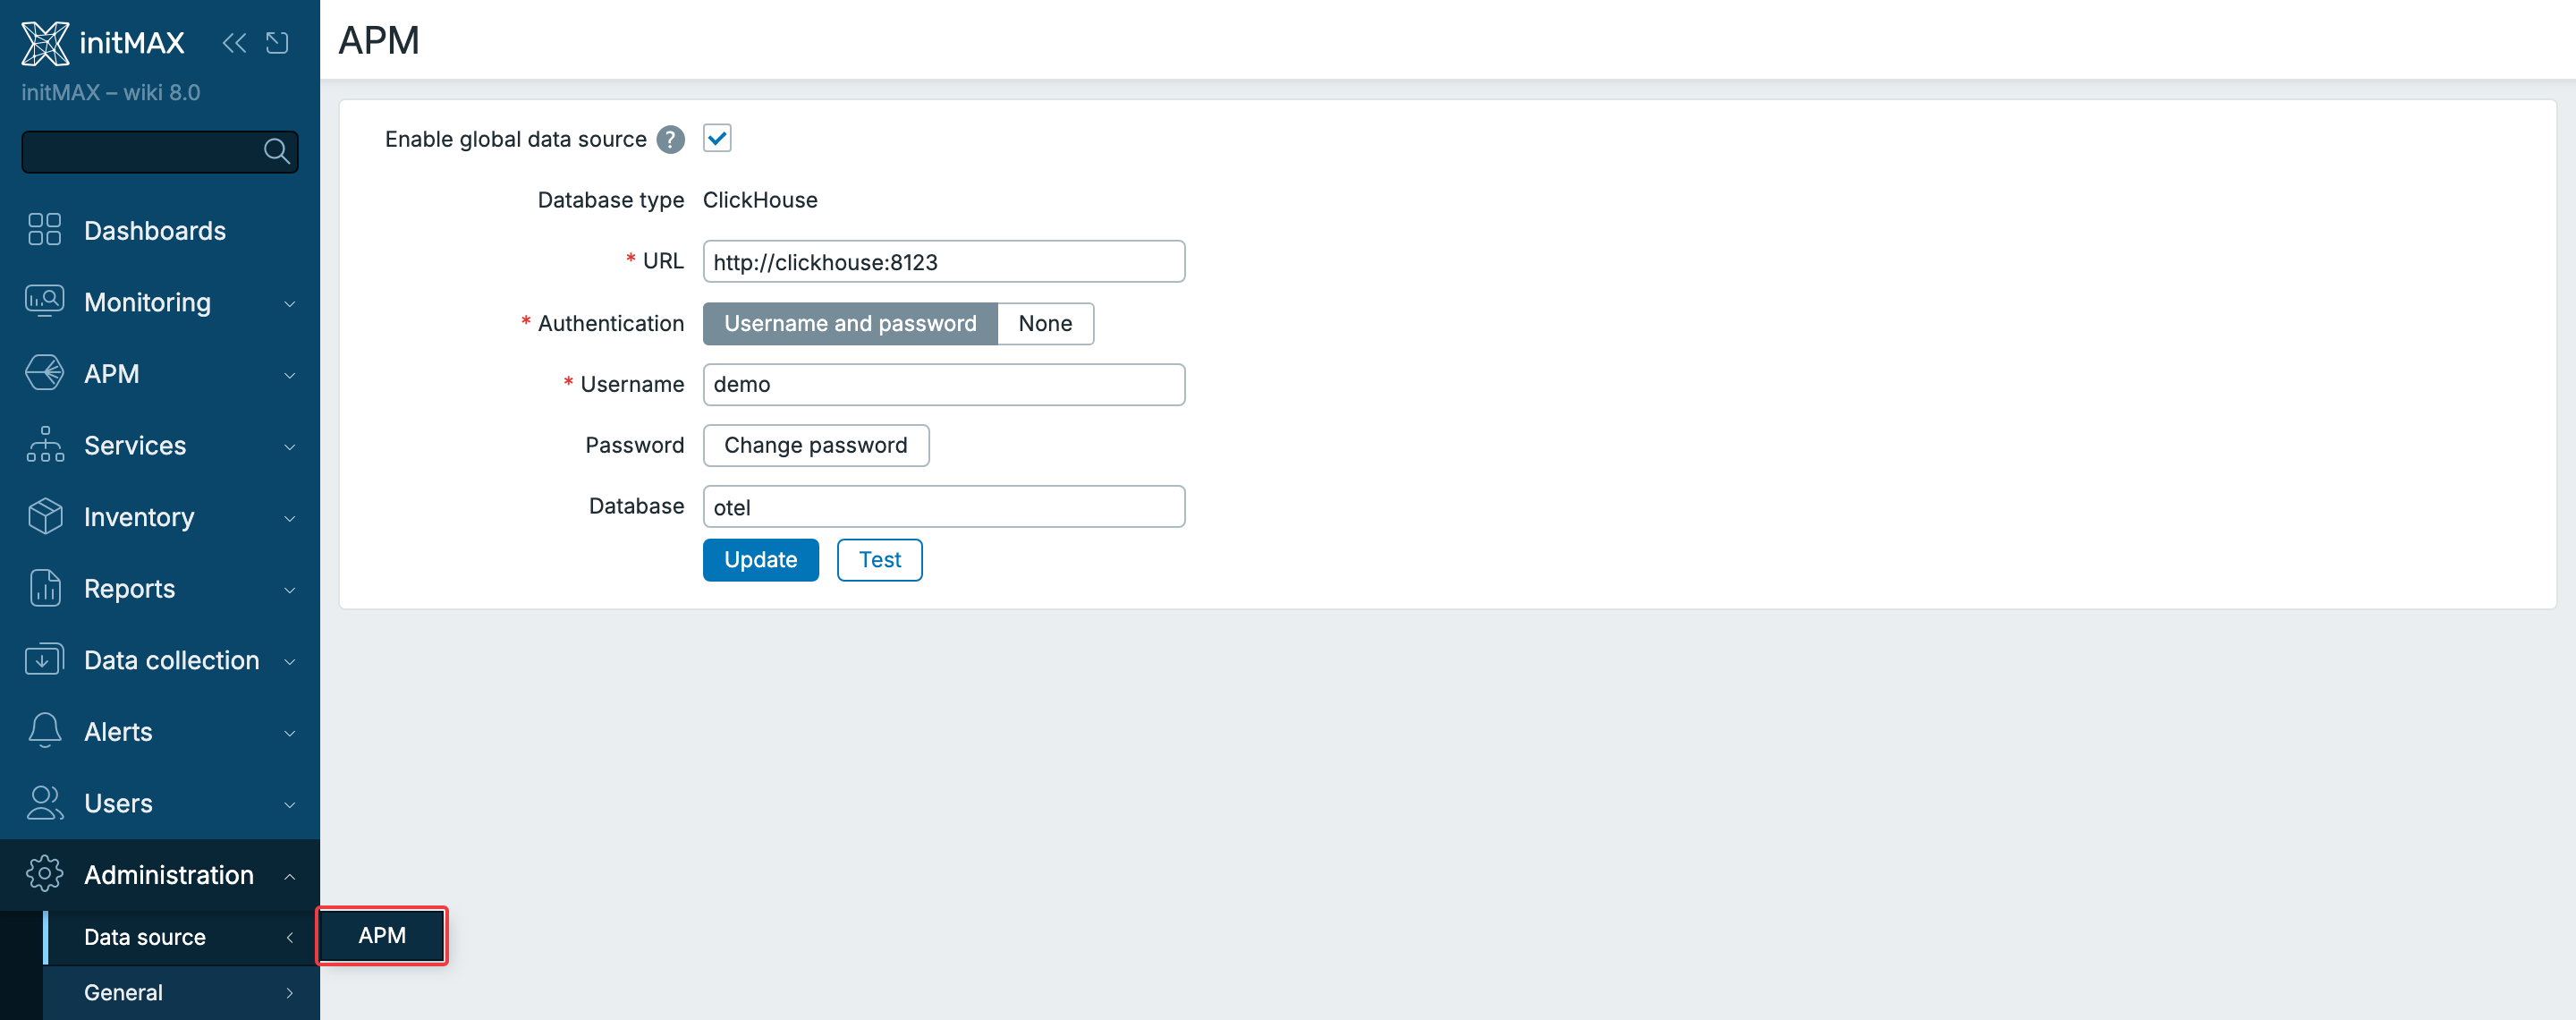
Pohledy čtou z globálního APM datového zdroje, který se nastavuje v Administration > Data source > APM: typ databáze (ClickHouse), URL, přihlášení (jméno a heslo, nebo bez autentizace), název databáze a u HTTPS ověření certifikátu a hostname. Je to stejný ClickHouse, do kterého zapisuje proxy, jen z pohledu frontendu; data jsou ve standardních tabulkách OpenTelemetry ClickHouse exporteru (otel_traces, otel_logs a otel_metrics_*), takže se dají číst i jinými nástroji.
Globální konfiguraci APM může využívat i server a proxy. Pokud proces nemá vlastní TelemetryProvider, použije globální nastavení telemetrické databáze; lokální TelemetryProvider má přednost. U oddělených prostředí proto zkontrolujte, do kterého ClickHouse proxy zapisuje a odkud čtou položky Telemetry query i frontend. Samotný ClickHouse history backend a jeho tabulky history* telemetrické úložiště nenahrazují.
Toto je nastavení ClickHouse pro APM, nikoli backend běžné historie položek. History backend popisujeme samostatně v kapitole ClickHouse backend a výrazná vylepšení pro Elastic. Oba způsoby mohou využívat stejný databázový cluster, ale mají vlastní konfiguraci a jiné tabulky.
APM filter: přístup podle atributů služby
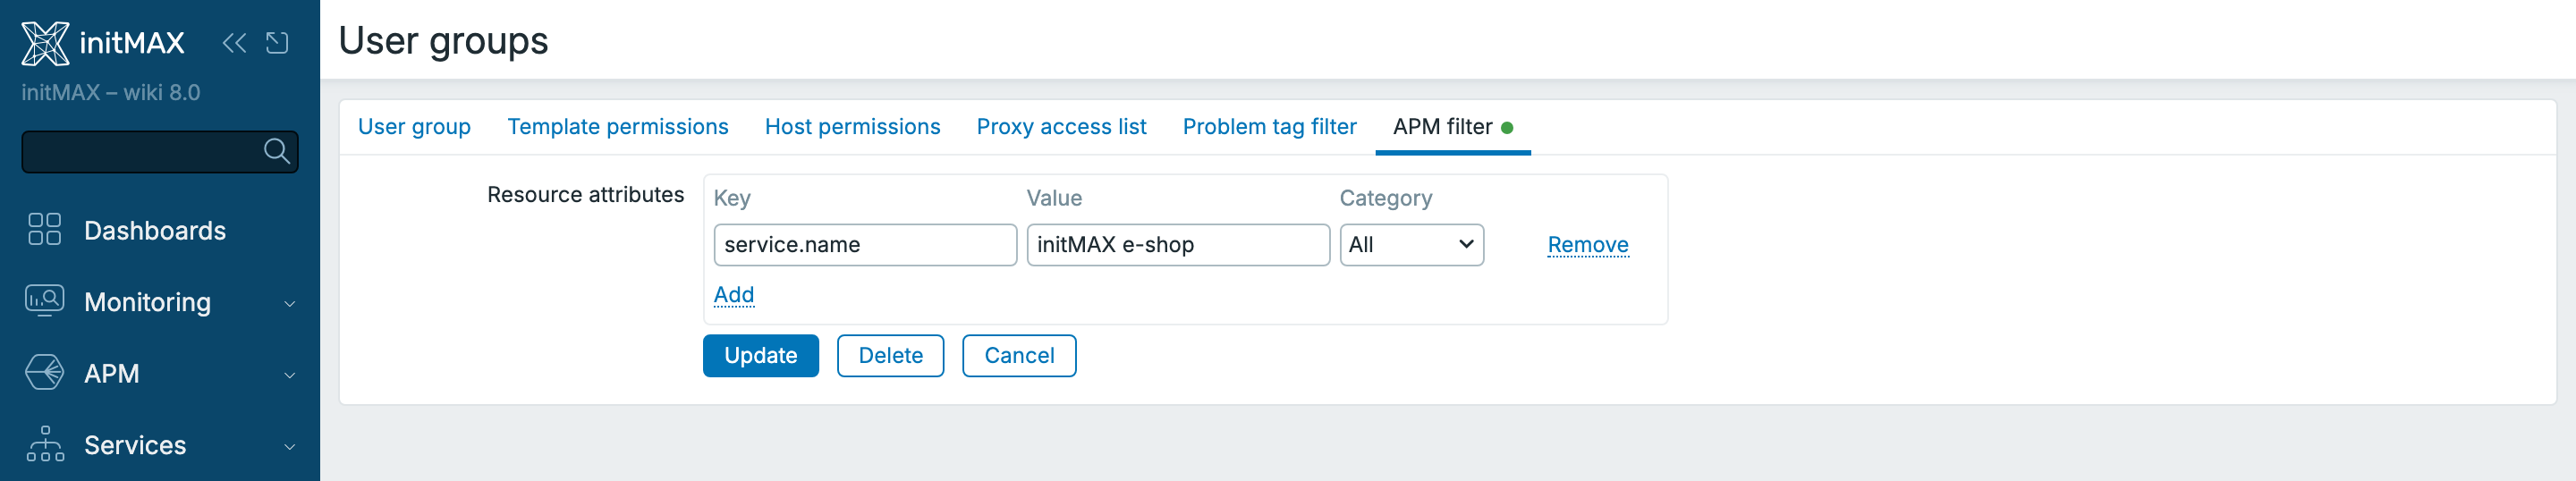
V Users > User groups přibývá záložka APM filter. Omezení pracuje s Resource attributes, například service.name=initMAX e-shop, a lze ho nastavit pro Traces, Metrics, Logs nebo všechny signály. Nejde jen o filtr tabulky: podmínky se uplatňují také v příslušném APM API. Oprávnění k běžným hostům tím nenahrazujeme.
Filtry ze skupin uživatele se spojují logikou OR. Přidání skupiny s přístupem k portálu tedy zpřístupní e-shop i Portal, nikoli průnik obou podmínek. Pokud uživatel nemá žádné APM filtry, toto atributové omezení se neuplatní; Super admin je obchází. Proto nepovažujte samotné přidání jednoho řádku za hotovou izolaci zákazníků a prověřte všechna členství i oprávnění role.
Zpracování: item typu Telemetry query
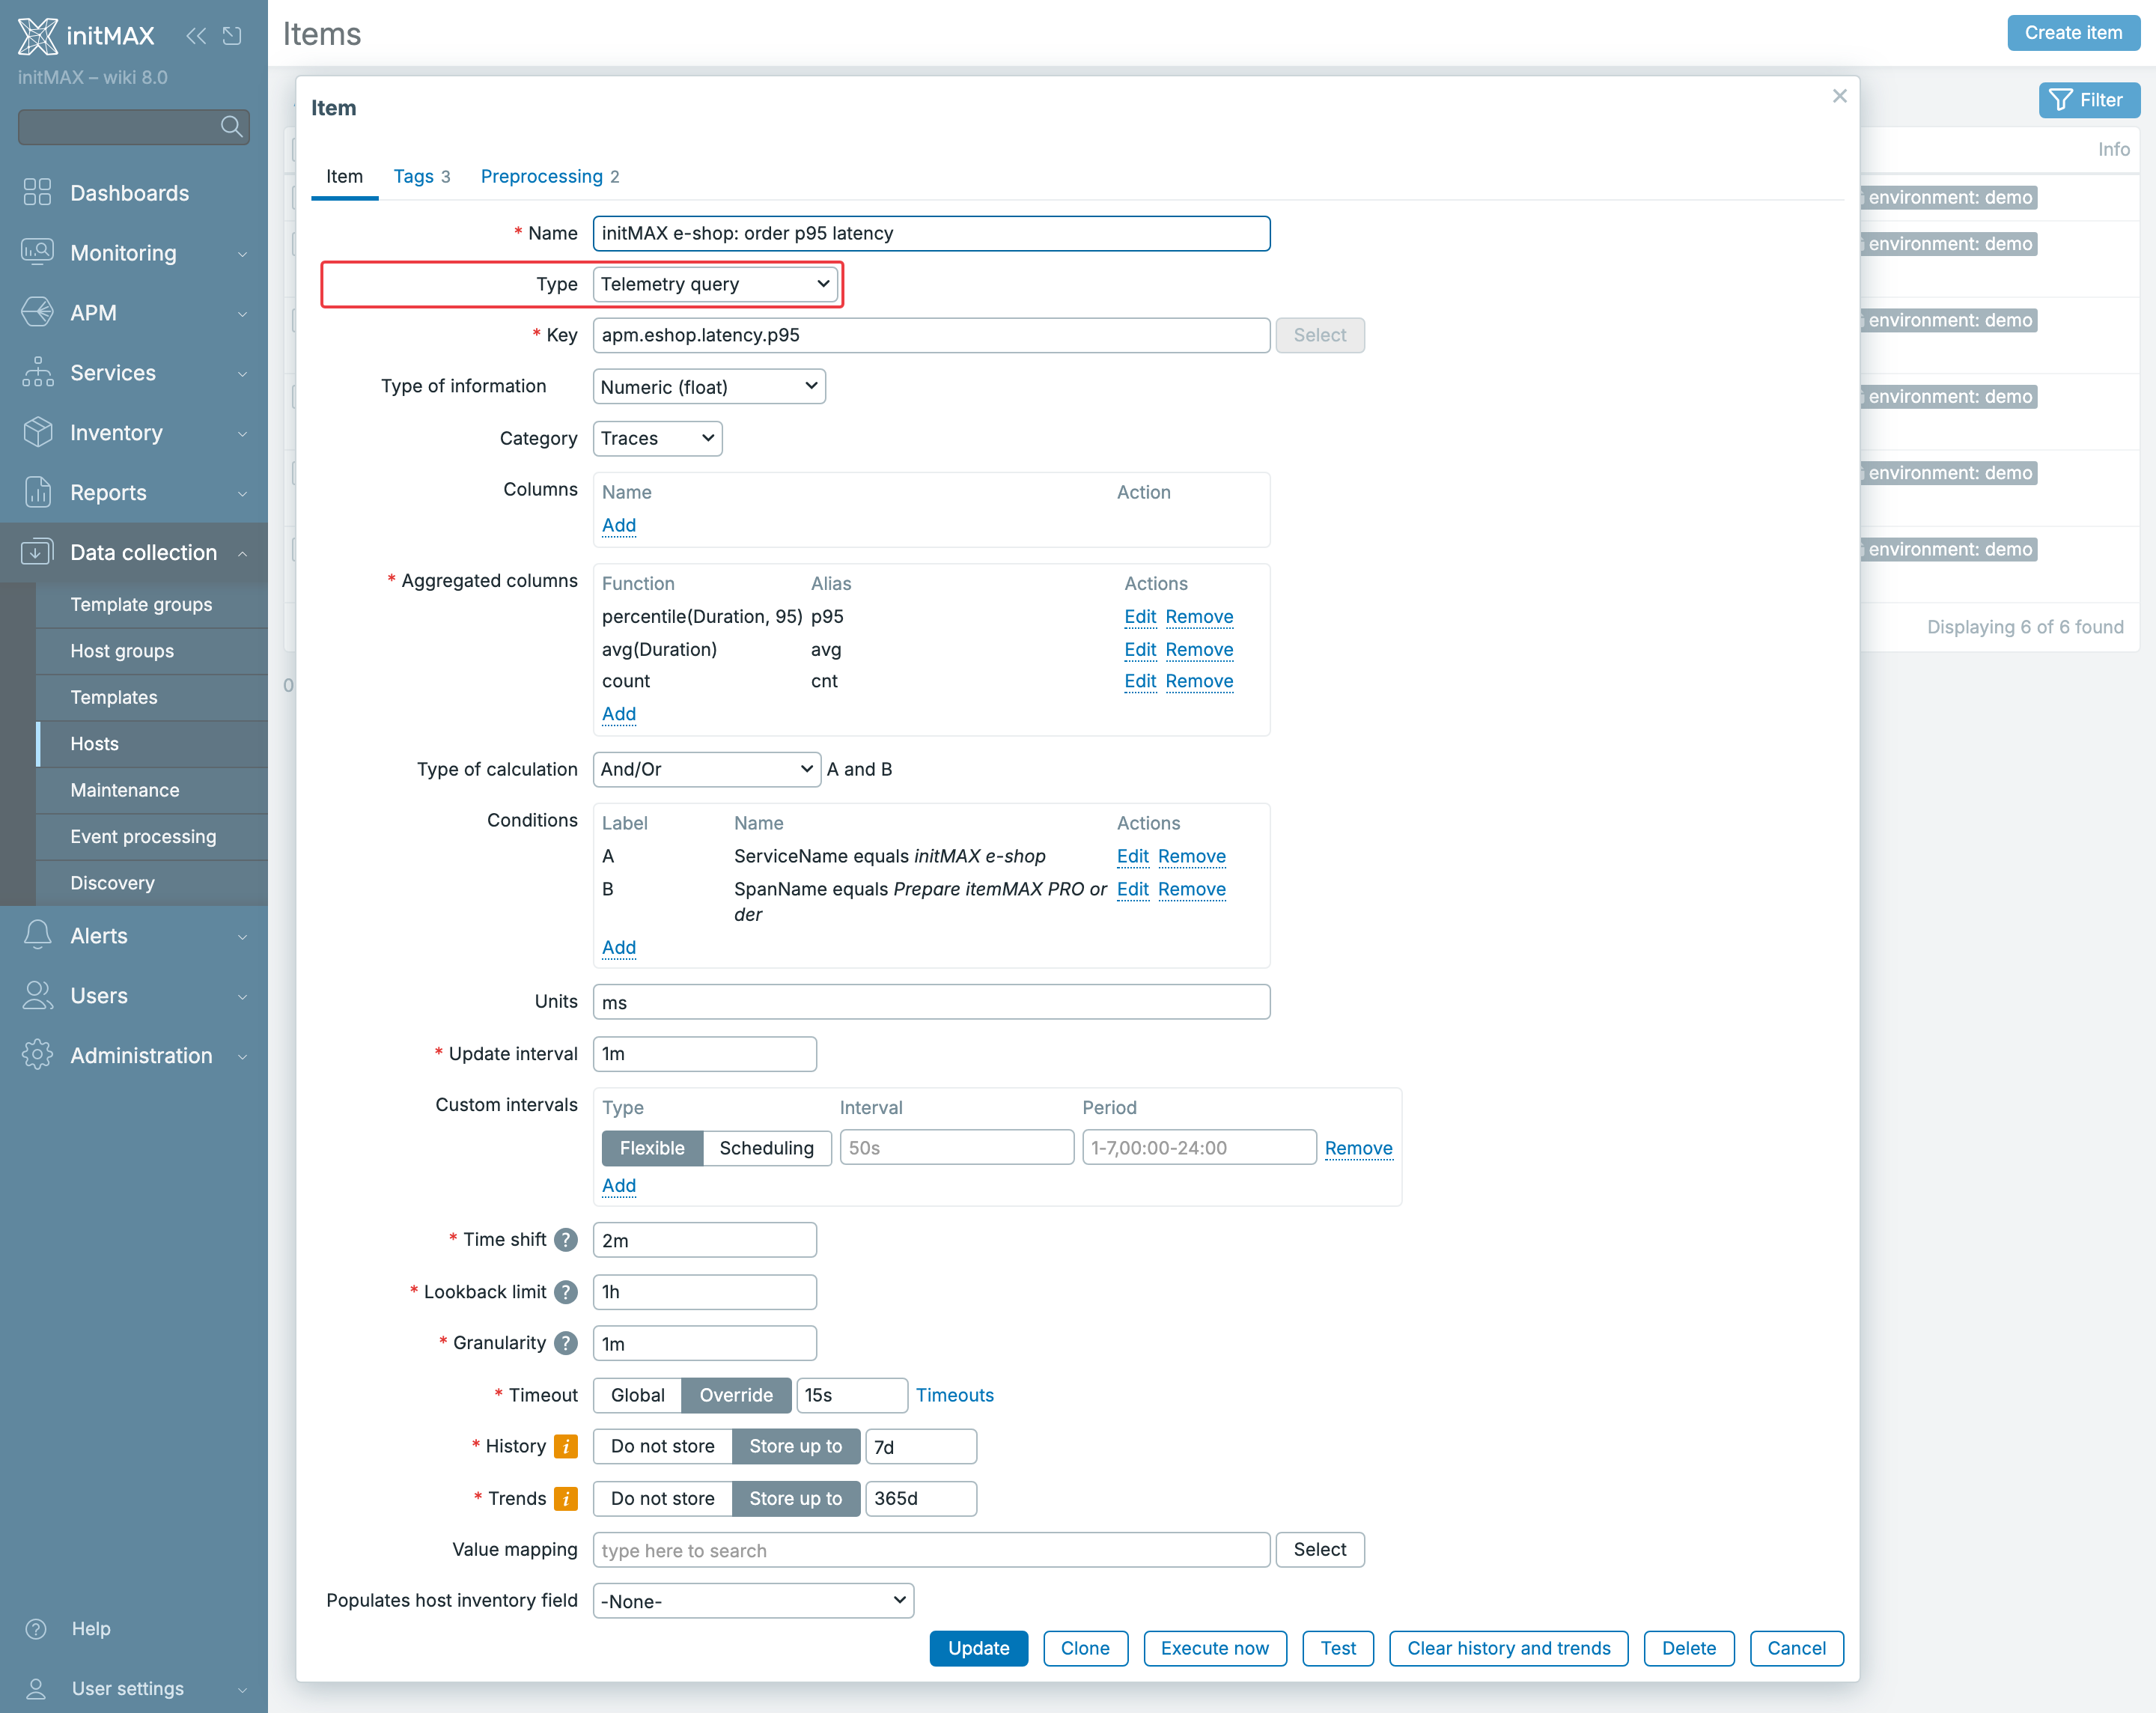
Nový typ itemu Telemetry query spojuje svět OpenTelemetry s klasickým Zabbixem. Vedle klíče položky se skládá dotaz: kategorie (Traces, Metrics, Logs), u metrik jejich typ (Sum, Gauge, Histogram nebo Exponential histogram), sloupce, které se mají číst, agregované sloupce s funkcí a aliasem a podmínky nad atributy s logikou And/Or nebo vlastním výrazem. Tři časové parametry určují, jak se dotaz vyhodnocuje: Granularity (velikost agregačního bucketu), Time shift (posun okna zpět) a Lookback limit (jak daleko do minulosti dohánět dosud nezpracované intervaly).
Výsledek se ukládá jako hodnota itemu. Pro číselný graf nebo trigger je třeba z vráceného JSON vybrat požadované číslo, například p95 latence služby initMAX e-shop v minutových intervalech. Dotaz vykonává server nebo proxy nad globální APM konfigurací, případně nad vlastním TelemetryProvider. Pro tyto dotazy je samostatný timeout timeout_telemetry_query.
- Granularity je velikost agregačního intervalu. Hodnota
1mdává minutové výsledky, i když se položka kontroluje každých30s. - Time shift posouvá vyhodnocovaný interval do minulosti. Například
15snechá prostor datům, která do ClickHouse dorazí s krátkým zpožděním. - Lookback limit určuje, jak hluboko do minulosti se dohánějí dosud nezpracované intervaly. Není to retence dat v ClickHouse.
Telemetry query lze použít také v LLD pravidlech a discovery prototypech. Namísto ručního zakládání položek pro každou službu tak lze služby objevit z telemetrie a pomocí maker vytvořit odpovídající položky. Podmínky dotazu podporují uživatelská makra a v prototypech i LLD makra; číselné podmínky zahrnují také >= a <=. Pole výsledků obsahuje vybrané sloupce přímo v jednotlivých objektech, což je důležité i pro mapování LLD maker.
Dotazy vykonávají samostatné procesy řízené parametrem StartTelemetryQueryPollers. Jejich vytížení lze sledovat stejně jako u dalších procesů Zabbixu.
Granularity sama nezaručuje kompletní uzavřený interval. Když je interval kontroly kratší než granularita, vyhodnocovaná okna se mohou překrývat; formulář na to upozorňuje. Příliš krátký Time shift navíc může zahrnout jen část dat, která už do úložiště dorazila. U počtů a percentilů proto nastavte časování podle skutečného zpoždění sběru, ne jen podle požadované rychlosti grafu.
Ukázka: od traces k triggeru
Vyzkoušeli jsme celý řetězec na modelovém nákupu itemMAX PRO: data procházejí OTLP/gRPC collectorem Zabbix proxy do ClickHouse a server nad nimi počítá položky Telemetry query. Pro p95 přípravy objednávky zvolíme kategorii Traces, agregace percentile(Duration, 95), avg(Duration) a count a podmínky ServiceName equals initMAX e-shop a SpanName equals Prepare itemMAX PRO order. Granularita i interval kontroly jsou 1m, Time shift je 2m, aby zůstala rezerva pro data přicházející v exportních dávkách. Další spany stejné služby se tak do latence ani počtu objednávek nepletou.
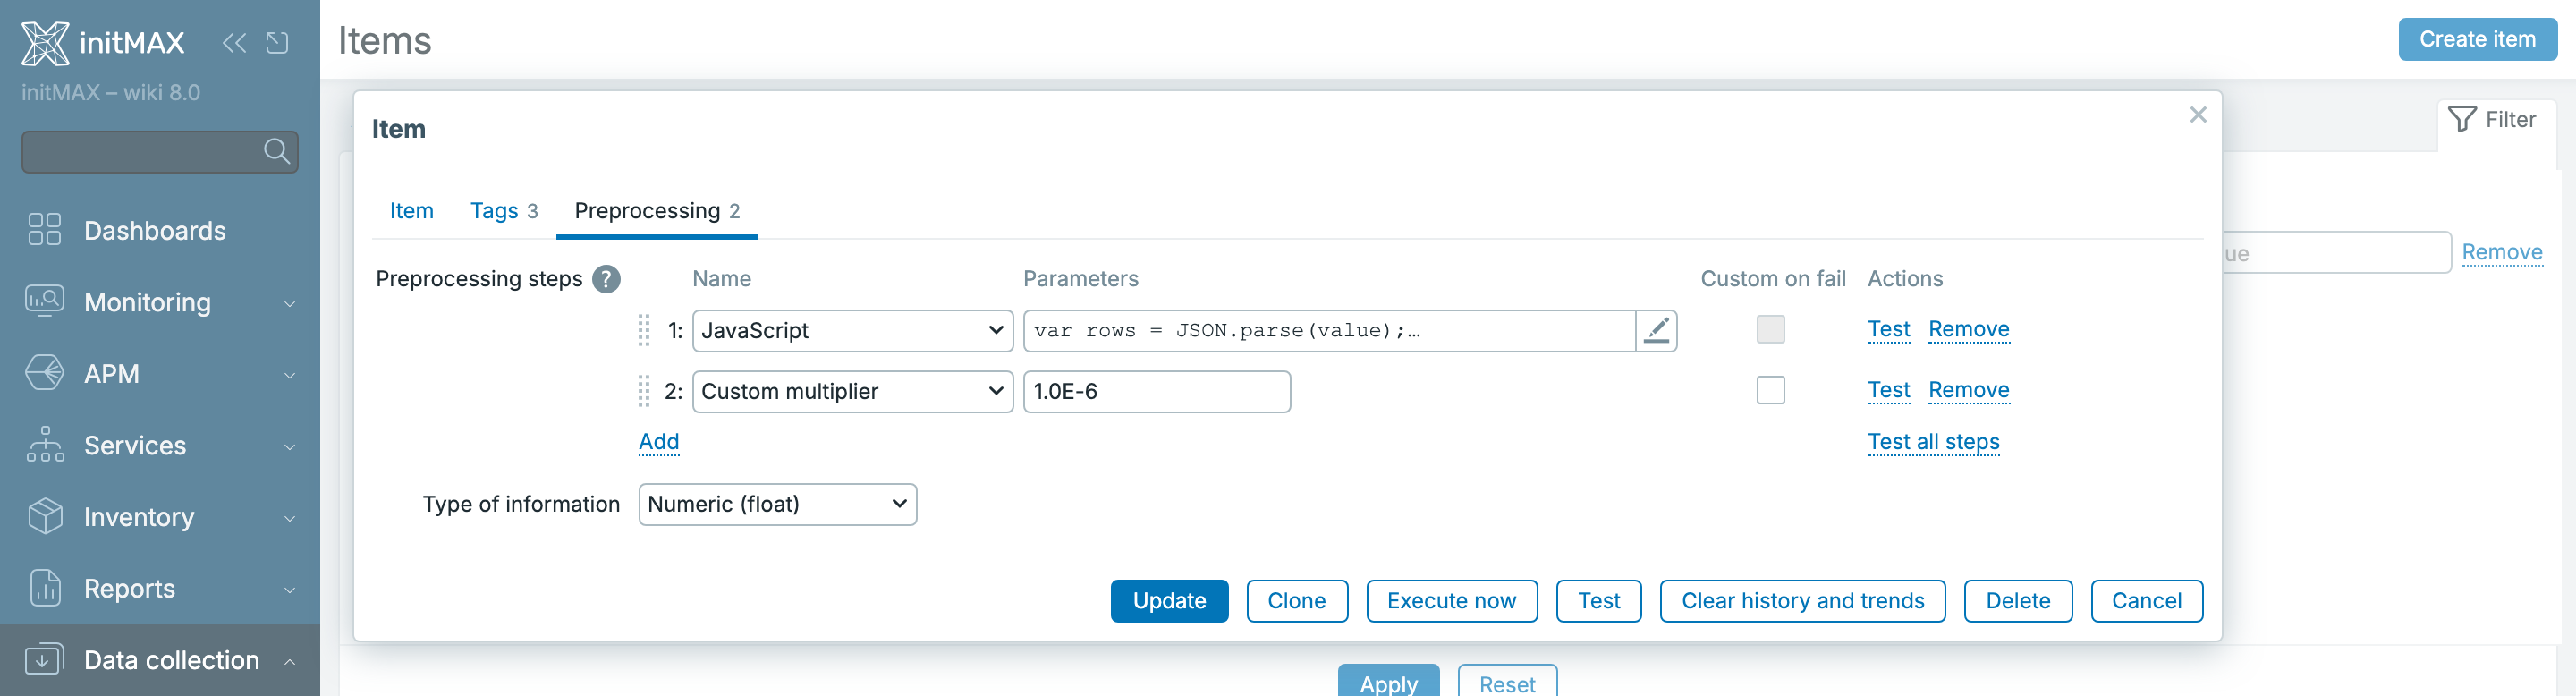
Server přeloží dotaz do ClickHouse SQL a vrátí JSON pole výsledných intervalů. Každý řádek má clock a agregace přímo ve svém objektu, například [{"clock":1793452094,"p95":1438000000,"avg":1386000000,"cnt":29}]. Při dohánění starších intervalů může pole obsahovat více řádků. Pro náš číselný item vybíráme JavaScriptem hodnotu p95 z řádku s nejvyšším clock; prázdný výsledek zahodíme:
var rows = JSON.parse(value);
if (rows.length === 0) return null;
var latest = rows[0];
for (var index = 1; index < rows.length; index++) {
    if (Number(rows[index].clock) > Number(latest.clock)) latest = rows[index];
}
if (latest.p95 === null) return null;
return latest.p95;
Duration je v nanosekundách. Následující Custom multiplier 1.0E-6 převede p95 na milisekundy a item používá jednotku ms. Pro další položky vybíráme alias avg nebo cnt. Jedno pole s více intervaly se samo nerozpadne na více bodů číselné historie. Náš příklad ukládá poslední vrácený interval jako aktuální hodnotu položky. Pro analýzu všech intervalů lze uchovat i nezpracovaný JSON v textovém itemu.
Samotný count nad traces počítá spany, ne automaticky unikátní objednávky. Služba initMAX e-shop má v jednom průchodu tři spany. Proto v příkladu vybíráme také SpanName equals Prepare itemMAX PRO order, tedy právě jeden span přípravy objednávky. Pro chyby přidáme StatusCode equals Error. Bez podmínky na operaci by se do počtu zahrnula i interní volání katalogu a platební služby.
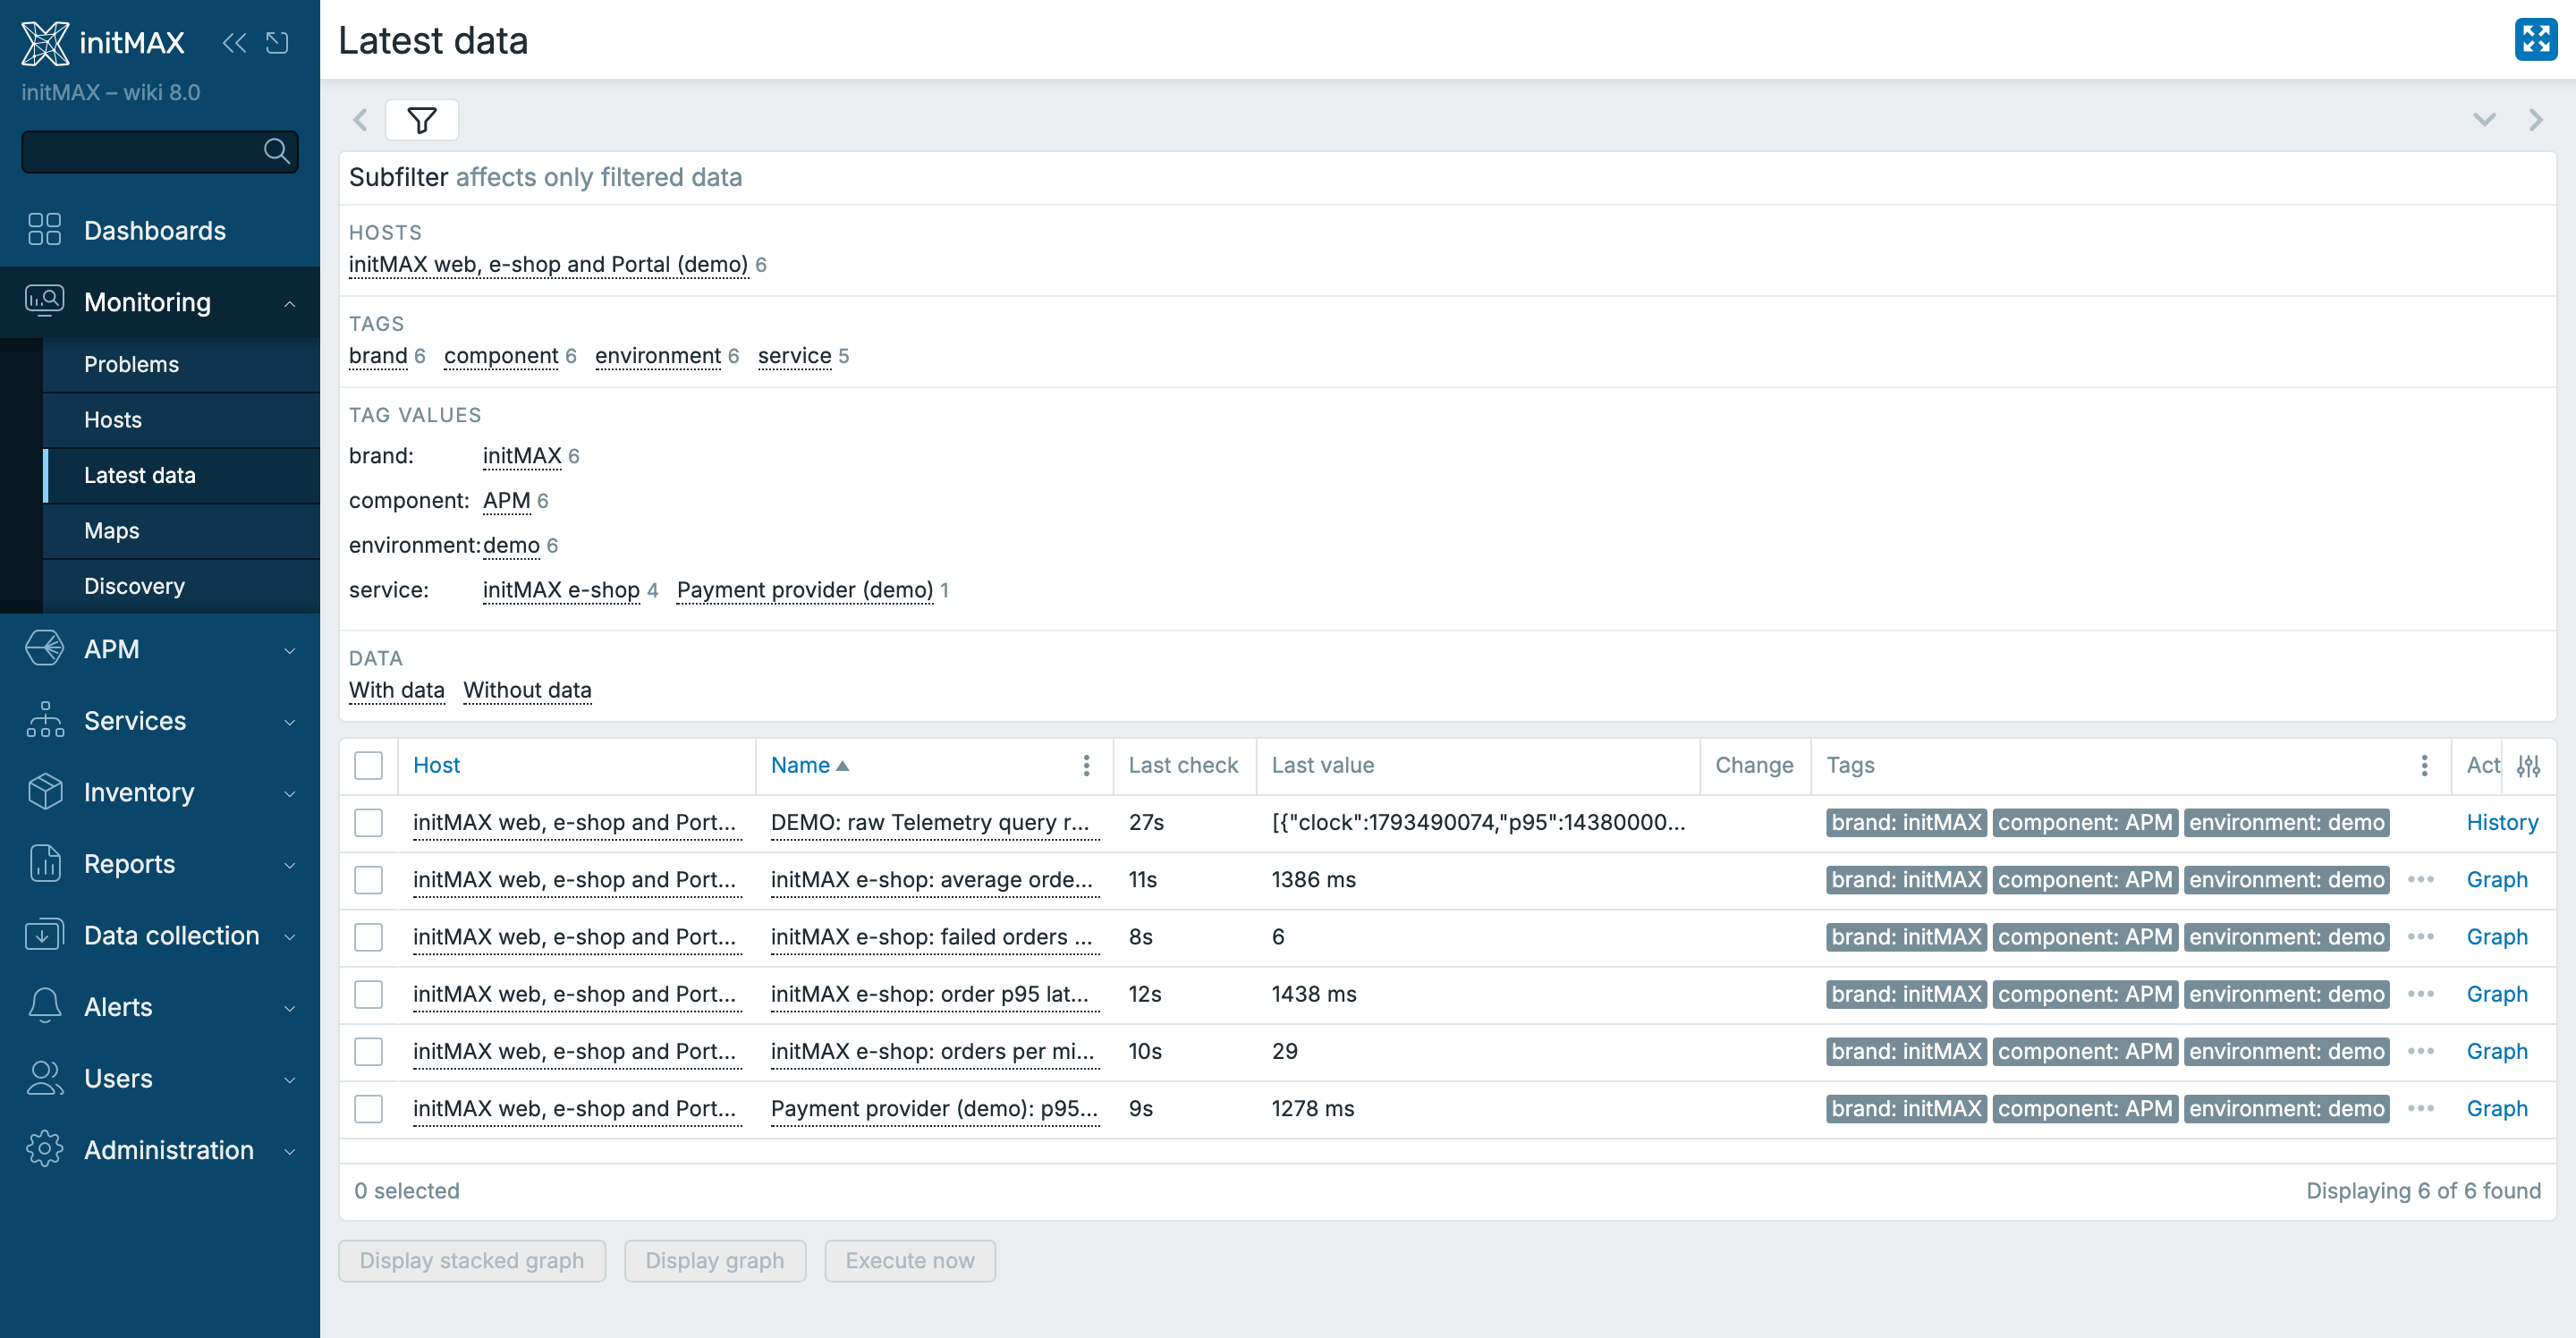
V Monitoring > Latest data už vidíme výsledky jako běžné hodnoty položek: p95 a průměrnou latenci v milisekundách a počty objednávek za vyhodnocený interval. Nejde o seznam surových spanů; ty zůstávají v APM.
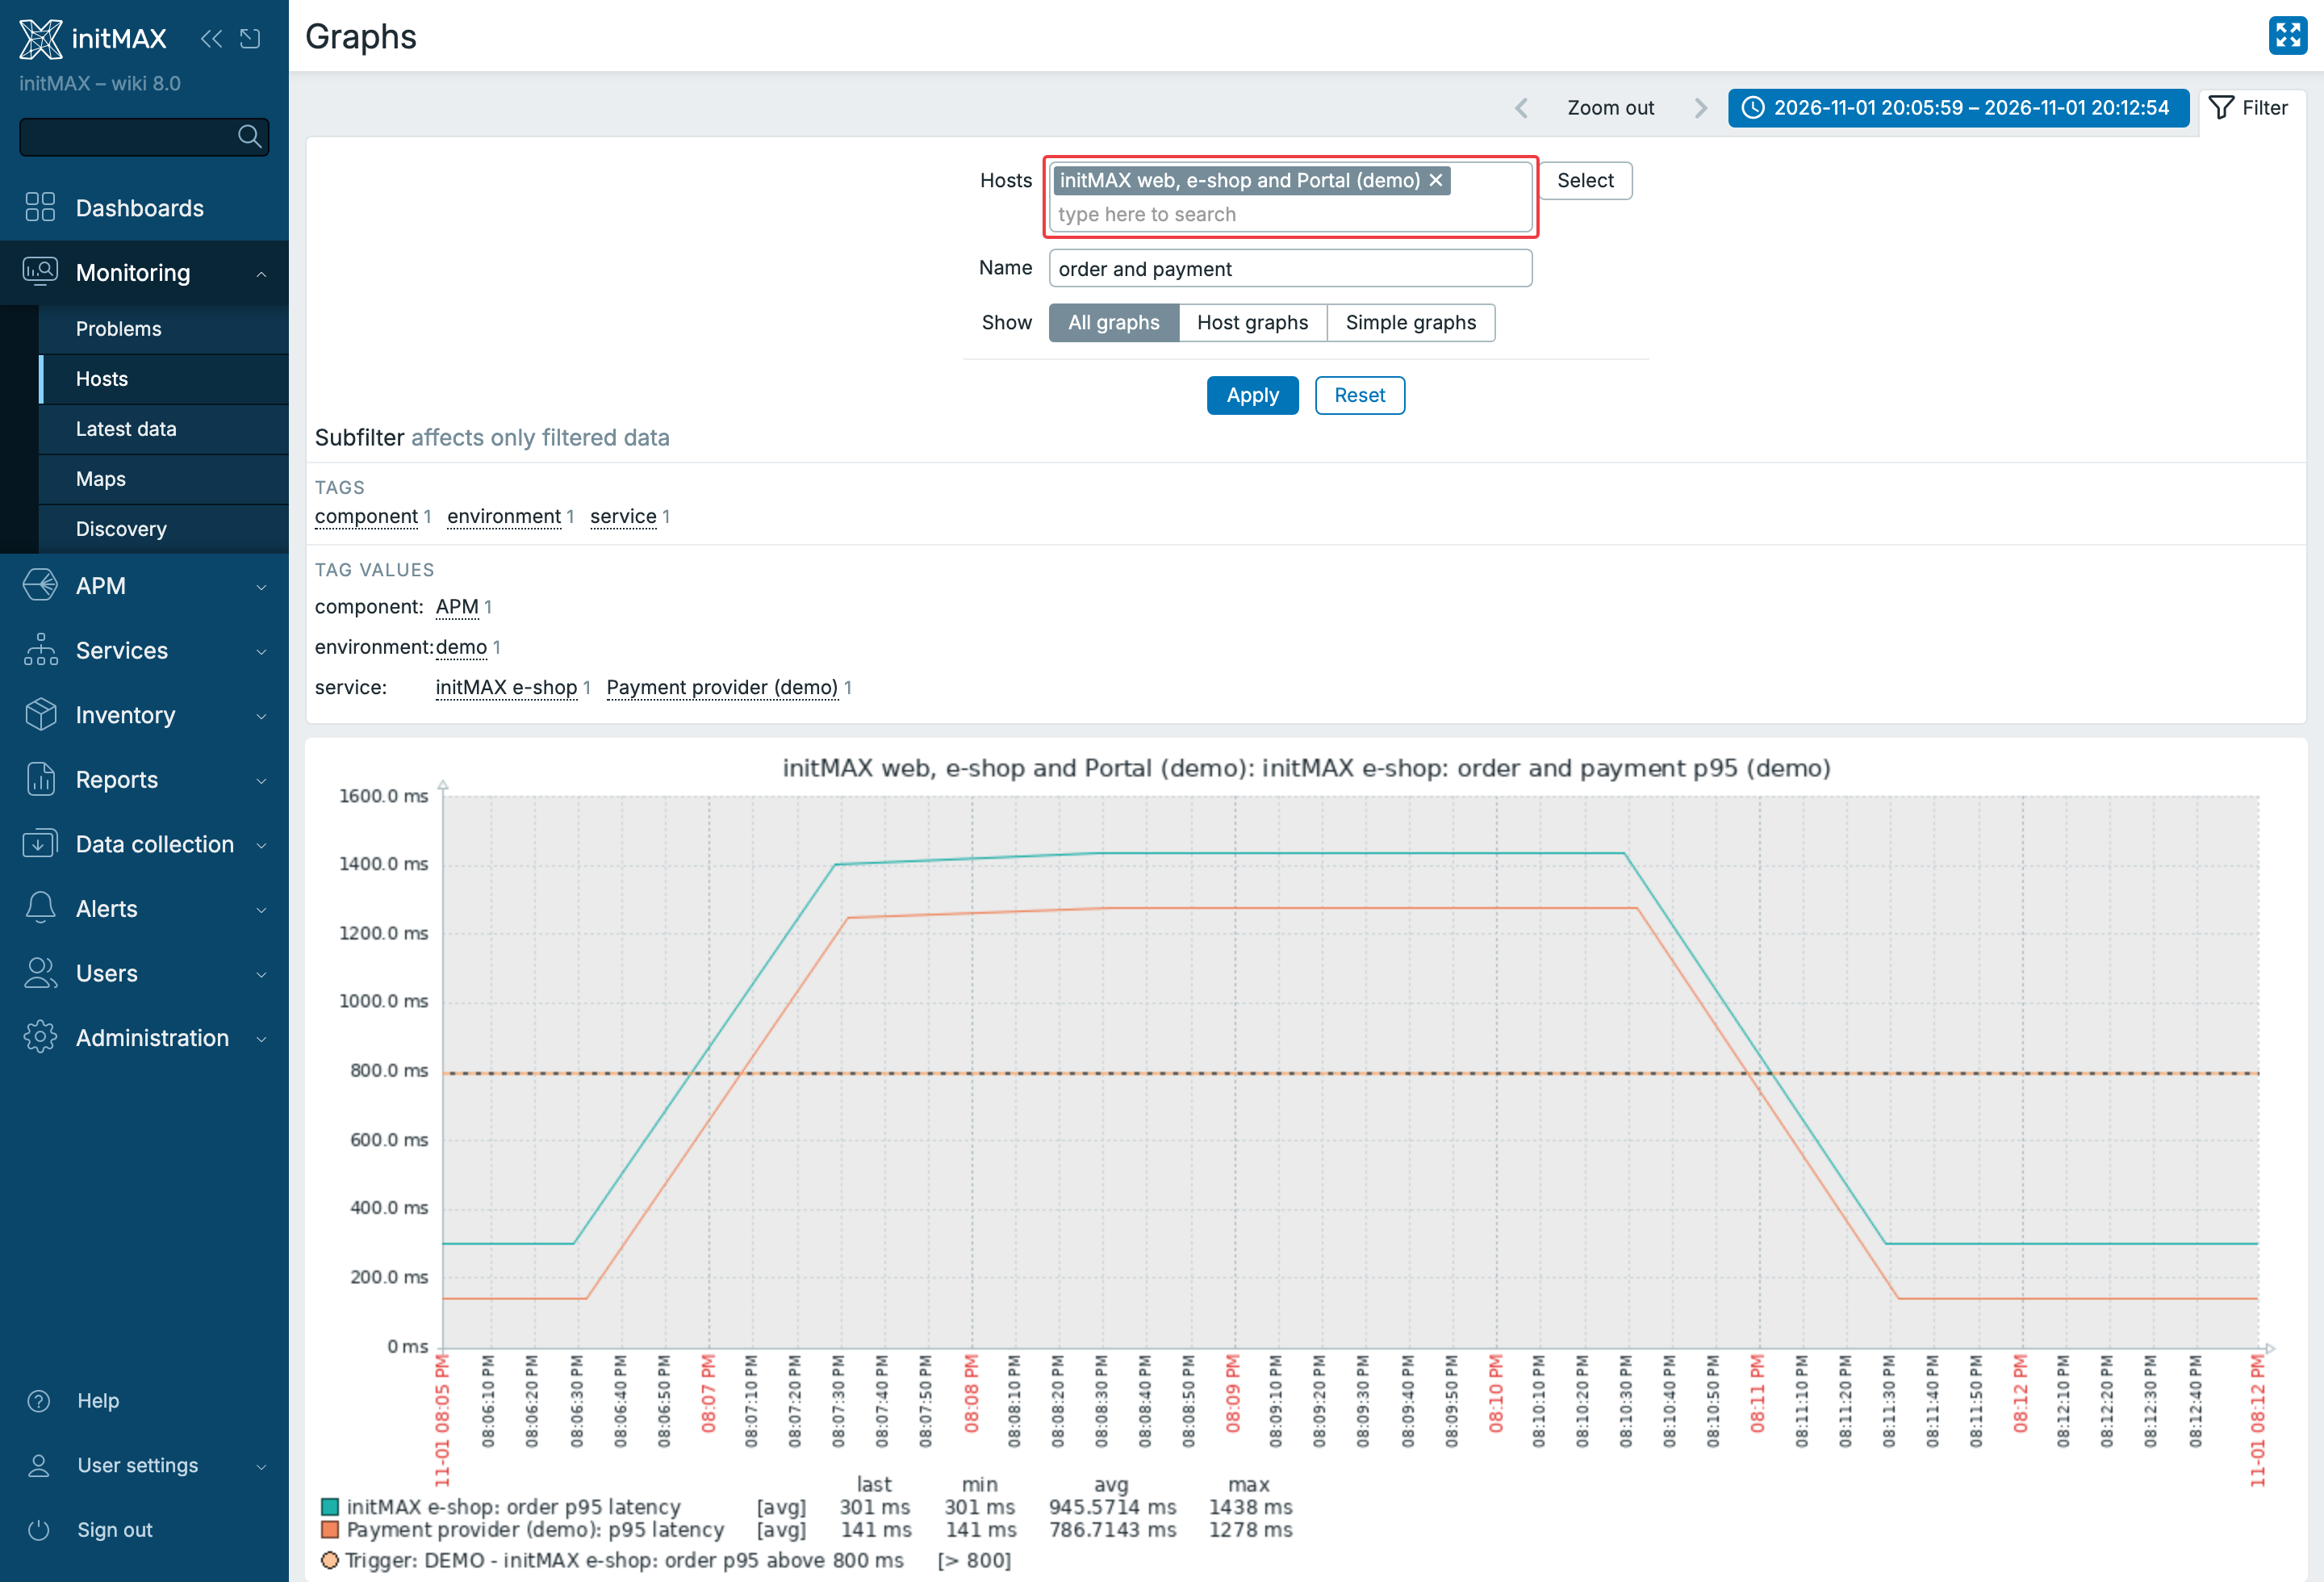
V Monitoring > Hosts otevřeme grafy našeho demonstračního hosta. Graf porovnává p95 přípravy objednávky a testovací platební služby. Nejprve je objednávka vyřízená přibližně za 300 ms, během simulovaného zpomalení p95 přesáhne 1,4 s a hranici triggeru 800 ms; po zotavení se vrátí pod tuto hranici. Křivky jsou výsledkem stejných položek Telemetry query, nikoli ručně vložených hodnot.
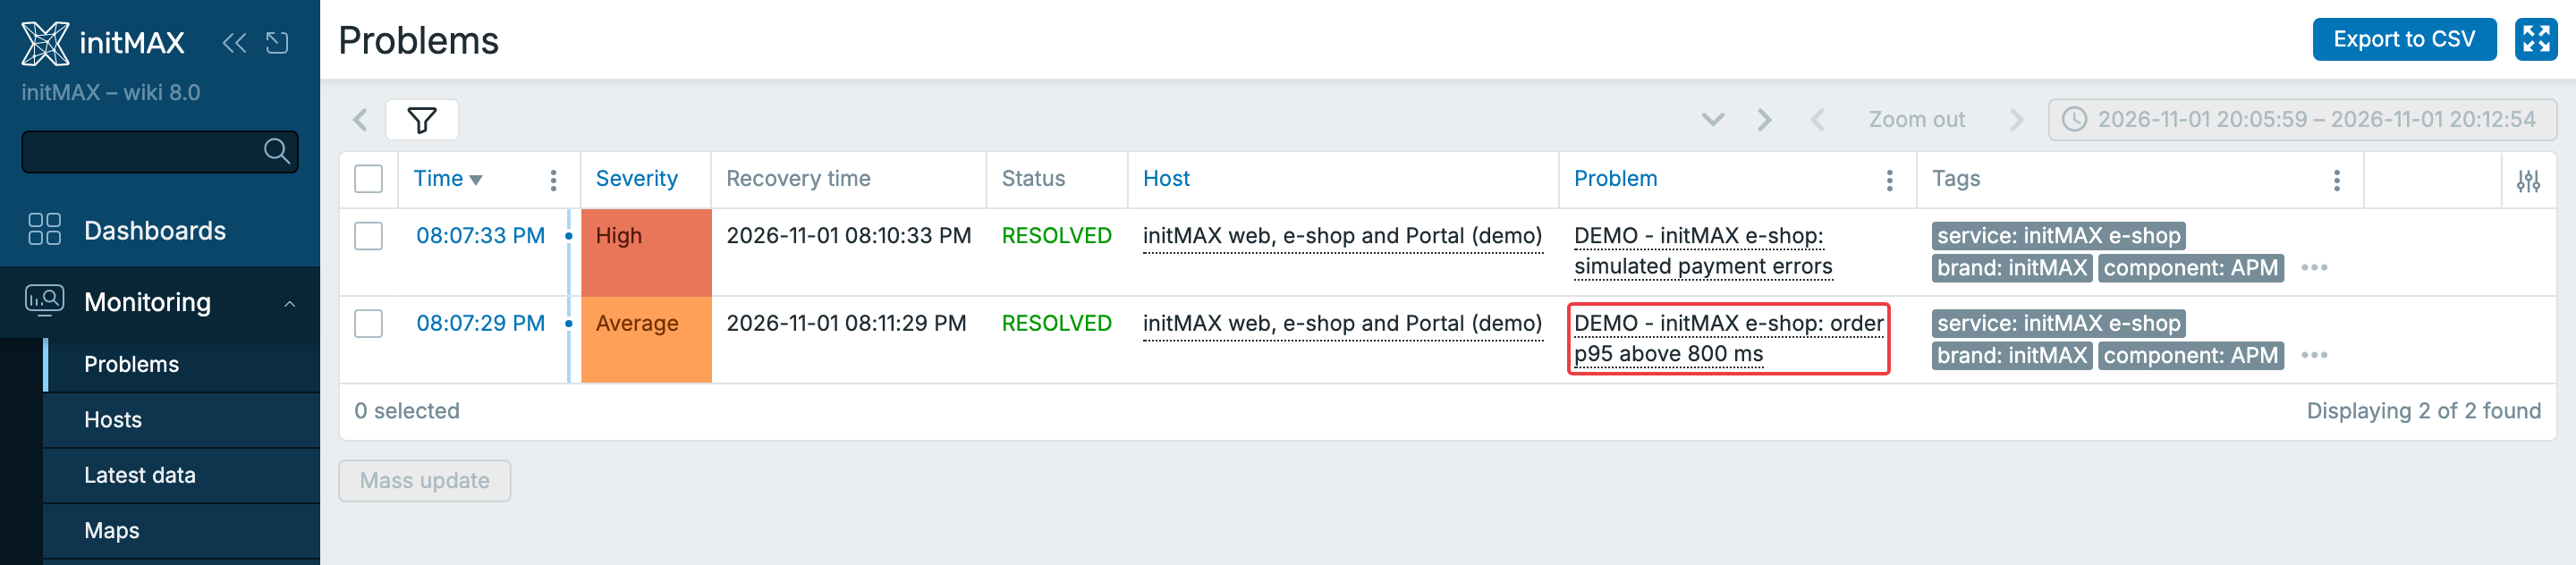
V historii pohledu Monitoring > Problems vidíme vznik obou demonstračních problémů i jejich automatické vyřešení po zotavení. Jde o stejné časové okno jako v grafu; sloupce Recovery time a Status ukazují čas obnovy a stav RESOLVED.
Nad itemy fungují triggery jako u čehokoli jiného: last(/initMAX digital experience demo/apm.eshop.latency.p95)>800 hlídá p95 latenci přípravy objednávky, last(/initMAX digital experience demo/apm.eshop.errors)>=3 počet chybových objednávek v minutovém intervalu. Když v modelovém provozu zpomalí testovací platební služba, objeví se zvýšená latence v grafu a problém v Problems s tagem service=initMAX e-shop. Konkrétní požadavek pak dohledáte v APM > Traces podle času, služby nebo Trace ID. Samotný tag problému automatický odkaz na konkrétní trace nevytváří.
Co to znamená v praxi
Pro týmy, které už mají aplikace instrumentované OpenTelemetry, znamená 8.0 možnost mít infrastrukturní monitoring a APM v jednom nástroji, se stejnými uživateli, oprávněními a notifikacemi. Počítejte s tím, že to přináší nový stavební kámen pro APM, ClickHouse, a s tím i nároky na disk a provoz. Rozumný začátek je jedna proxy s collectorem pro jedno prostředí a několik Telemetry query itemů na klíčové služby; pohledy Traces a Logs pak slouží k dohledání příčiny, když se trigger aktivuje.
ClickHouse není povinný pro celý Zabbix, ale pro tuto telemetrickou část. Pro APM počítejte s ClickHouse 26.8.17.4 nebo novějším v podporovaném rozsahu a se synchronizovaným časem komponent. Ve zdrojích jsou skripty database/clickhouse/otel_all.sh a dílčí schémata pro traces, metriky a logy. Vytvoří potřebné telemetrické tabulky; nenahrazují návrh retence, kapacity ani migraci již uložených dat. Citlivé atributy omezujte už v instrumentaci nebo v OpenTelemetry Collectoru.
ClickHouse pro produkční APM navrhněte předem, včetně vysoké dostupnosti. Proxy do něj zapisuje a server, případně proxy, i frontend z něj čtou; výpadek úložiště tak zasáhne sběr, dotazy i prohlížení. U kritického provozu počítejte s replikovanými tabulkami, dostupnou koordinační službou ClickHouse Keeper a stabilním přístupovým bodem s přepnutím při výpadku. Samotné spuštění dvou databázových uzlů HA nezajistí.
Předem navrhněte také síťové prostupy, TLS, oprávnění a kapacitu. Aplikace nebo OpenTelemetry Collector potřebují přístup k proxy přes OTLP/gRPC (standardně TCP 4317); proxy, server a frontend potřebují své HTTP(S) spojení do ClickHouse. Přidejte interní komunikaci replik a Keeperu, zálohy, retenci a ověření chování při výpadku. Vysoká dostupnost sama o sobě není záloha ani záruka nulové ztráty telemetrie; záleží také na nastavení zápisů, replikace a front exportérů.
Nový korelační engine CEP (Complex Event Processing)
Jednou z hlavních novinek Zabbixu 8.0 je nový korelační engine CEP, tedy Complex Event Processing. Navazuje na dosavadní práci s událostmi, ale posouvá ji o úroveň dál: místo jednoduchého posuzování jednotlivých problémů umožňuje vyhodnocovat souvislosti mezi více událostmi, pracovat s časovým oknem, tagy, skupinami hostů a následnými operacemi.
V praxi to řeší jeden z nejčastějších problémů monitoringu. Jeden reálný incident často vygeneruje desítky až stovky událostí. Výpadek sítě, databáze, storage nebo centrální služby se může projevit na mnoha hostech a aplikacích najednou. Bez další logiky pak administrátor neřeší jeden incident, ale dlouhý seznam problémů, které spolu souvisí. CEP má pomoct z těchto událostí vytvořit srozumitelnější obraz.
Smyslem CEP není jen zobrazit, že vznikl problém. Cílem je umožnit nad proudem událostí dělat pokročilejší logiku: seskupovat související problémy, vyhodnocovat je v časovém okně, doplňovat jim tagy, měnit závažnost, potlačovat méně důležité události nebo rozlišovat mezi příčinou a následky.
Konfigurační pravidla najdete v Data collection > Event processing. Ve stejném seznamu jsou vedle nových CEP pravidel i původní event correlation pravidla, filtr Type je umí oddělit. Sloupec Info ukazuje chybu pravidla za běhu a tlačítko Reset time windows zahodí rozpracovaná časová okna po změně pravidla.
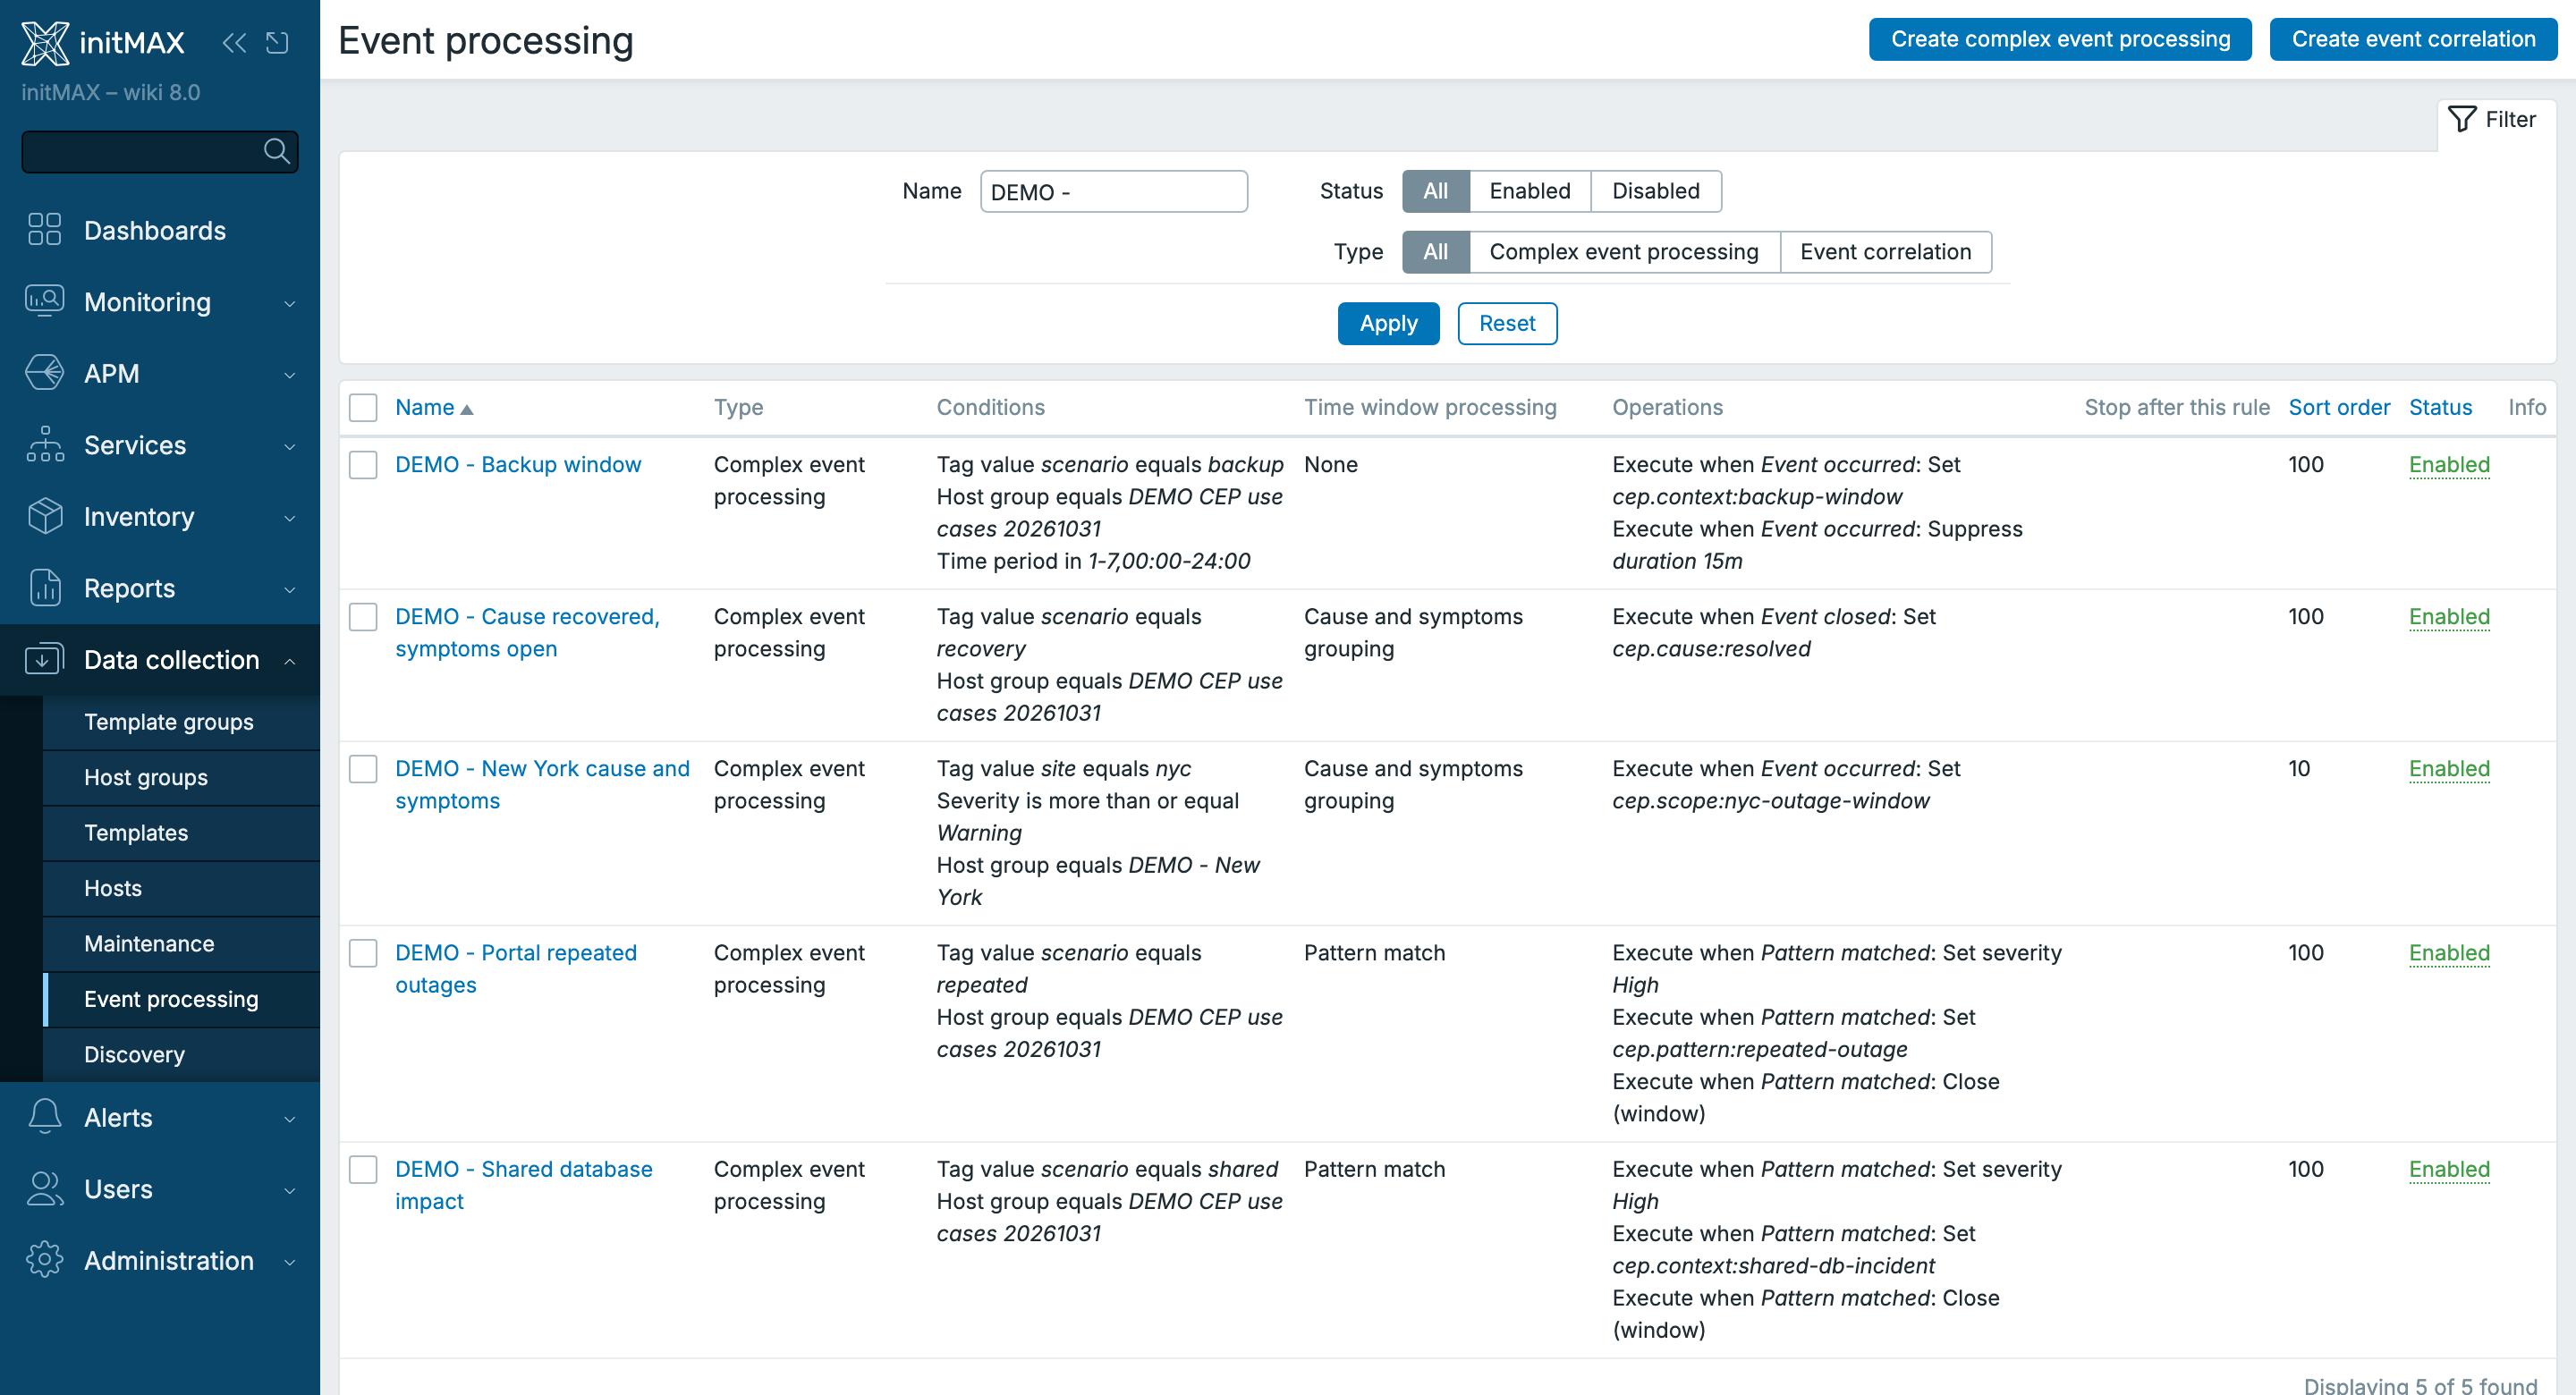
Detail nastavení CEP pravidla.
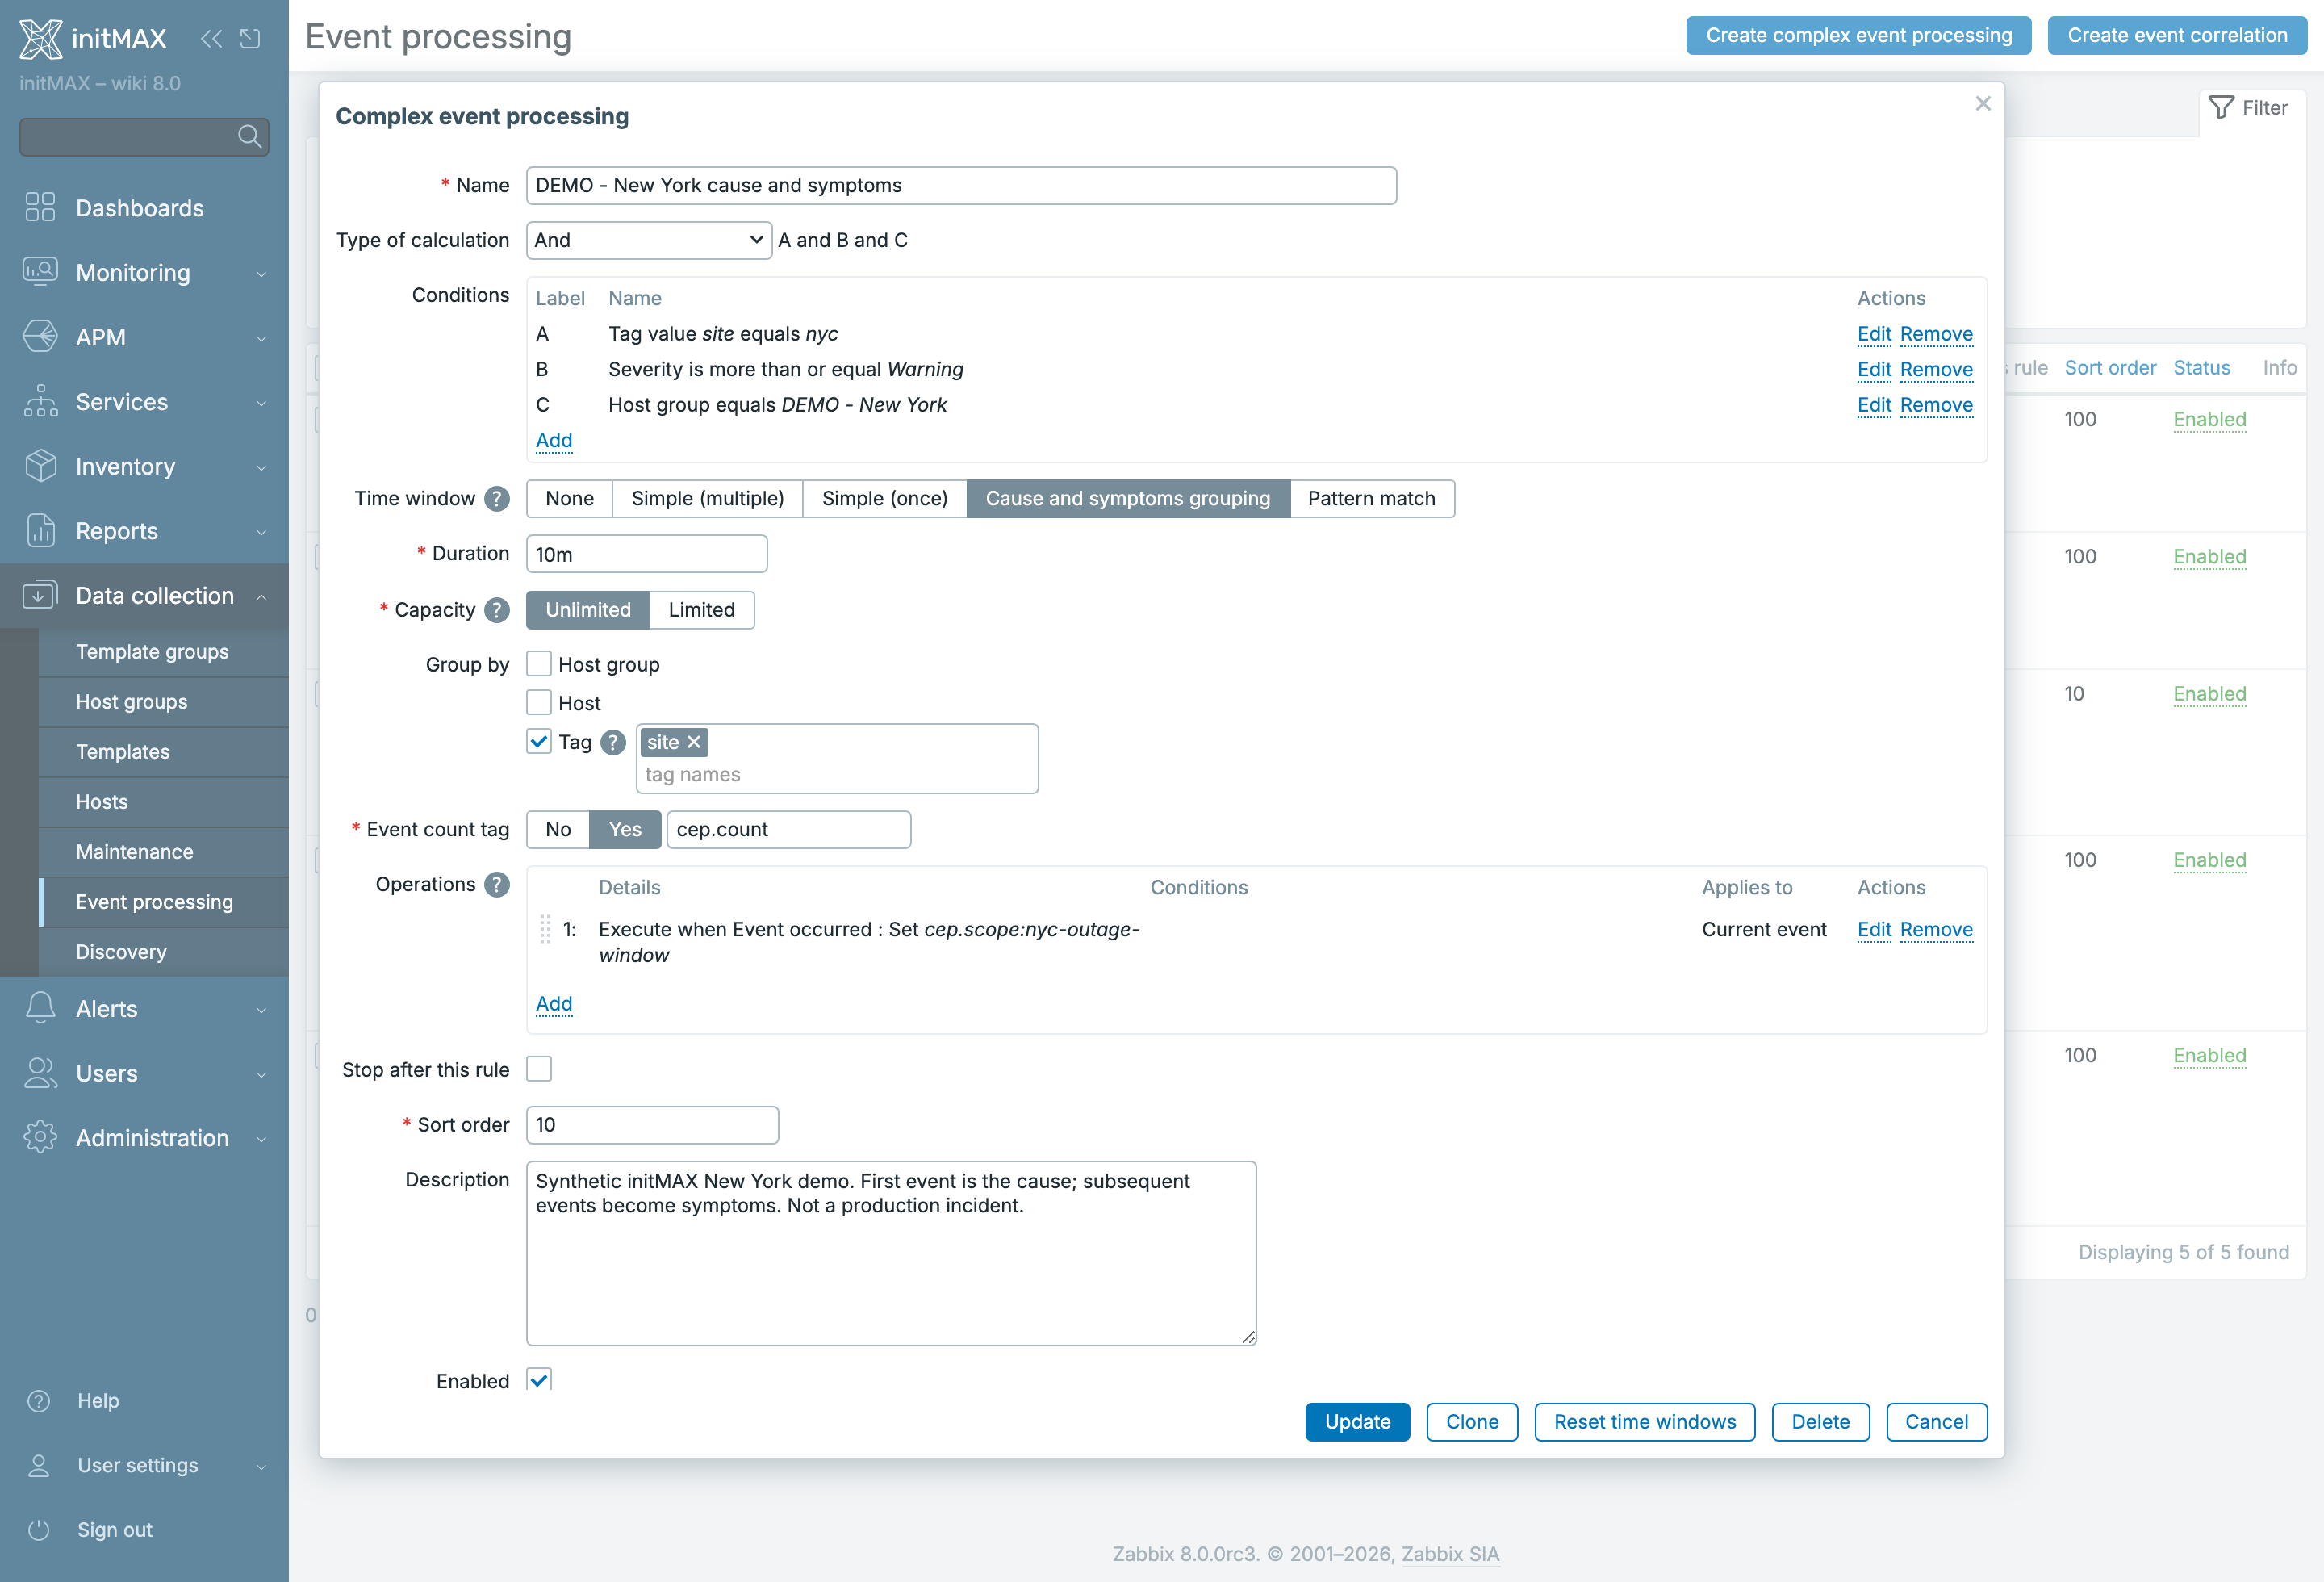
Na obrázku je detail CEP pravidla. V horní části se nastavuje, jaké eventy má pravidlo zachytit, uprostřed je logika časového okna a seskupování a ve spodní části jsou operace, které Zabbix nad odpovídajícími eventy provede.
- Name je provozní identifikace pravidla. U větších instalací dává smysl do názvu dostat účel pravidla, například lokalitu, službu, typ incidentu nebo očekávaný výsledek korelace.
- Type of calculation a Conditions tvoří vstupní filtr. Pravidlo může eventy vybírat podle Event name, Tag name, Tag value, Severity, Host, Host group a nově také Time period. Tag name a Tag value jsou samostatné podmínky s operátory Equals, Does not equal, Contains a Does not contain, u severity je k dispozici Is more than or equal. V příkladu se pracuje s host group pro New York, tagem lokality a minimální severity. Právě tady se rozhoduje, které eventy se do korelační logiky vůbec dostanou.
- Time window vybírá způsob práce v čase: None zpracuje event bez okna. U Simple (multiple) může event zpracovat více odpovídajících pravidel; Simple (once) ho předá jen prvnímu odpovídajícímu pravidlu tohoto režimu. Cause and symptoms grouping seskupuje příčinu a symptomy, Pattern match vyhodnocuje vzor událostí pomocí JavaScriptu v poli Script. Seskupování podle tagů se nastavuje samostatně v Group by.
- Duration definuje délku okna. Hodnota
10mznamená, že se související eventy sledují v desetiminutovém intervalu a mohou být vyhodnocené jako jeden korelační kontext. V poli lze použít i uživatelské makro. - Capacity omezuje počet eventů v okně. Přepínač Unlimited / Limited a číslo nebo makro určuje, kolik eventů se v okně drží. Pokud přidání eventu překročí kapacitu okna, je právě přidaný event z okna vyřazen. Na takovou situaci pak mohou navazovat operace spouštěné při Event evicted, například změna severity nebo doplnění tagu.
- Group by říká, jak se eventy uvnitř okna rozdělí do skupin. Jsou to tři nezávislé checkboxy Host group, Host a Tag, které jde kombinovat, a u tagů lze zadat více názvů najednou, například lokalitu a službu. U tagů je potřeba počítat s přesným názvem včetně velikosti písmen. U režimu Cause and symptoms grouping není Group by povinné.
- Event count tag patří k režimu Cause and symptoms grouping. Zabbix ho doplňuje na příčinu a aktualizuje v něm počet jejích symptomů. V našem příkladu tedy
cep.count=5znamená jednu příčinu a pět navázaných symptomů, nikoli pět událostí včetně příčiny. - Operations jsou výstup pravidla. Tady se nastavuje, co má Zabbix s eventy udělat: přidat nebo upravit tag, změnit severity, potlačit symptom, změnit název eventu nebo jinak ovlivnit jeho další zpracování.
- Stop after this rule zastaví vyhodnocování dalších CEP pravidel pro stejný event po zpracování aktuálního pravidla. To je důležité pro prioritizaci pravidel a pro situace, kdy jedno pravidlo incident jednoznačně klasifikuje.
- Sort order určuje pořadí vyhodnocování. Nižší hodnota se zpracuje dříve, při shodě rozhoduje název pravidla, takže spolu se Stop after this rule umožňuje řídit prioritu celé korelační logiky.
Možnosti operací uvnitř CEP pravidla vypadají takto:
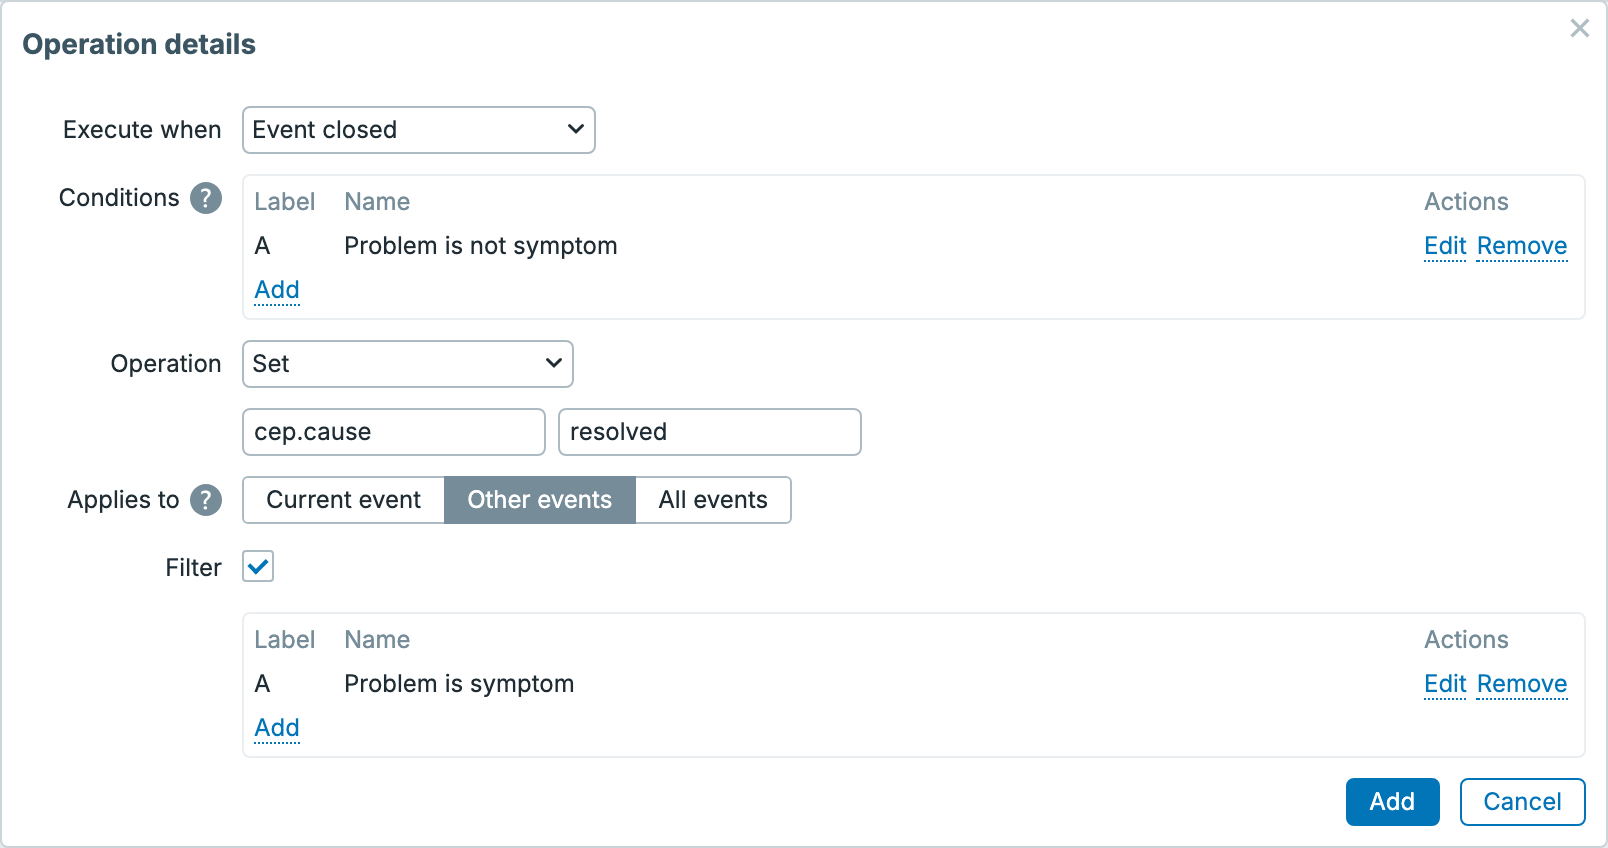
V dialogu Operation details se nejdřív nastavuje Execute when, tedy okamžik spuštění operace. Následující Conditions rozhodují, zda se operace v dané situaci vůbec vykoná. Vedle tagů mohou kontrolovat například to, jestli je problém otevřený, potlačený nebo označený jako symptom, případně zda jde o první či poslední event v okně. Teprve níže vybíráme samotnou akci a její cílové události.
- Event occurred se spustí ve chvíli, kdy do pravidla vstoupí nová odpovídající událost. Hodí se pro okamžité doplnění kontextu, například tagu nebo upraveného názvu.
- Event added to window nastane až ve chvíli, kdy je event skutečně zařazen do časového okna. Od Event occurred se liší tím, že už jde použít podmínky First event in time window a Last event in time window.
- Event evicted nastane, když událost z časového okna vypadne, například kvůli limitu kapacity nebo posunu času. Díky tomu lze odlišit eventy, které už do aktuální korelační skupiny nepatří.
- Event closed se spustí při uzavření události v časovém okně. Je to jiný okamžik než uzavření celého okna; operace může reagovat například na skončení příčiny incidentu.
- Window closed se vyhodnotí při uzavření časového okna, tedy po době určené hodnotou Duration. To dává smysl pro akce, které mají proběhnout až po nasbírání celé skupiny eventů.
- Pattern matched patří k režimu Pattern match, kde se vyhodnocuje vzor událostí skriptem. Typicky se používá ve chvíli, kdy nestačí samotný počet nebo společný tag, ale záleží i na posloupnosti nebo kombinaci eventů.
Spouštěče mají pevné pořadí Event occurred > Event added to window > Event evicted > Event closed > Window closed > Pattern matched a operace v pravidle musí být takto seřazené. Jejich nabídka závisí na typu okna: u None je jen Event occurred, zatímco Pattern matched patří pouze k Pattern match. Discard slouží k vyřazení právě vznikající události při Event occurred; není to nástroj pro dodatečné mazání eventů, které už jsou v okně.
Applies to odděluje podmínky spuštění od výběru událostí, které operace změní:
- Current event: operace pracuje s aktuální událostí.
- Other events: pracuje s ostatními událostmi v témže okně, nikoli s aktuální.
- All events: zahrne všechny události v okně včetně aktuální.
U Other events a All events lze zapnout samostatný Filter. Ten vybírá cíle operace, nikoli události vstupující do pravidla. V ukázce reagujeme na uzavření příčiny a souvisejícím symptomům doplníme tag cep.cause=resolved. Podmínka operace vylučuje symptom jako spouštěcí událost; filtr rozsahu naopak vybírá právě symptomy. Event closed nenabízí operaci Close pro uzavření dalších problémů a ukončení příčiny samo neznamená jejich vyřešení. Close (window) uzavírá časové okno, nikoli automaticky všechny jeho problémy.
Část Operation určuje konkrétní akci. Podle jejího typu se zobrazí další pole, například nový název eventu, cílová severity nebo název a hodnota tagu.
- Set name přepíše název eventu, v hodnotě fungují makra. Praktické je to ve chvíli, kdy chcete z několika technických hlášek udělat čitelnější incidentový název.
- Close uzavře vybrané otevřené problémy. Discard při Event occurred odmítne právě vznikající událost; již uložené eventy dodatečně nemaže.
- Set severity, Increase severity a Decrease severity umožňují upravit závažnost podle toho, co CEP zjistí. Samostatný problém může mít nižší prioritu, ale v kombinaci s dalšími eventy může jít o vážnější incident.
- Suppress potlačí vybraný event, typicky symptom, který už nechcete ukazovat stejně výrazně jako pravděpodobnou příčinu. Nastavuje se buď Duration, nebo Indefinitely. Opačná operace Unsuppress potlačení zruší. Potlačení se zapisuje do historie eventu jako CEP akce.
- Add, Set a Set value doplní nebo upraví tagy. To je užitečné pro další filtrování, notifikace, dashboardy i návaznou automatizaci.
- Increase value a Decrease value pracují s hodnotou tagu jako s čítačem nebo číselným kontextem, například pro počet souvisejících eventů v korelační skupině.
- Rename a Remove pomáhají normalizovat metadata eventů, aby se dál v Zabbixu pracovalo s jednotným názvoslovím.
- Clone first a Clone last vytvoří kopii první nebo poslední události v okně. Jsou k dispozici při Event evicted, Event closed, Window closed a Pattern matched a dávají smysl tam, kde chcete z nasbírané skupiny vyrobit jeden souhrnný event.
- Close (window) uzavře celé časové okno předčasně. Hodí se v Pattern match scénářích, kdy je vzor nalezen a není důvod čekat na vypršení Duration.
- U režimu Cause and symptoms grouping Zabbix sám označí první event v okně jako příčinu a ostatní jako symptomy; v detailu eventu je pak vidět akce Set as symptom s odkazem na CEP pravidlo.
Příklad: incident v lokalitě New York
Pro představu si vezměme jednoduchý scénář: v lokalitě New York vznikne během krátké doby více problémů na edge gateway, databázovém clusteru a aplikačním serveru. Každý problém dává sám o sobě smysl, ale pro operátora je důležitější vědět, že pravděpodobně patří ke stejnému incidentu.
Před korelací
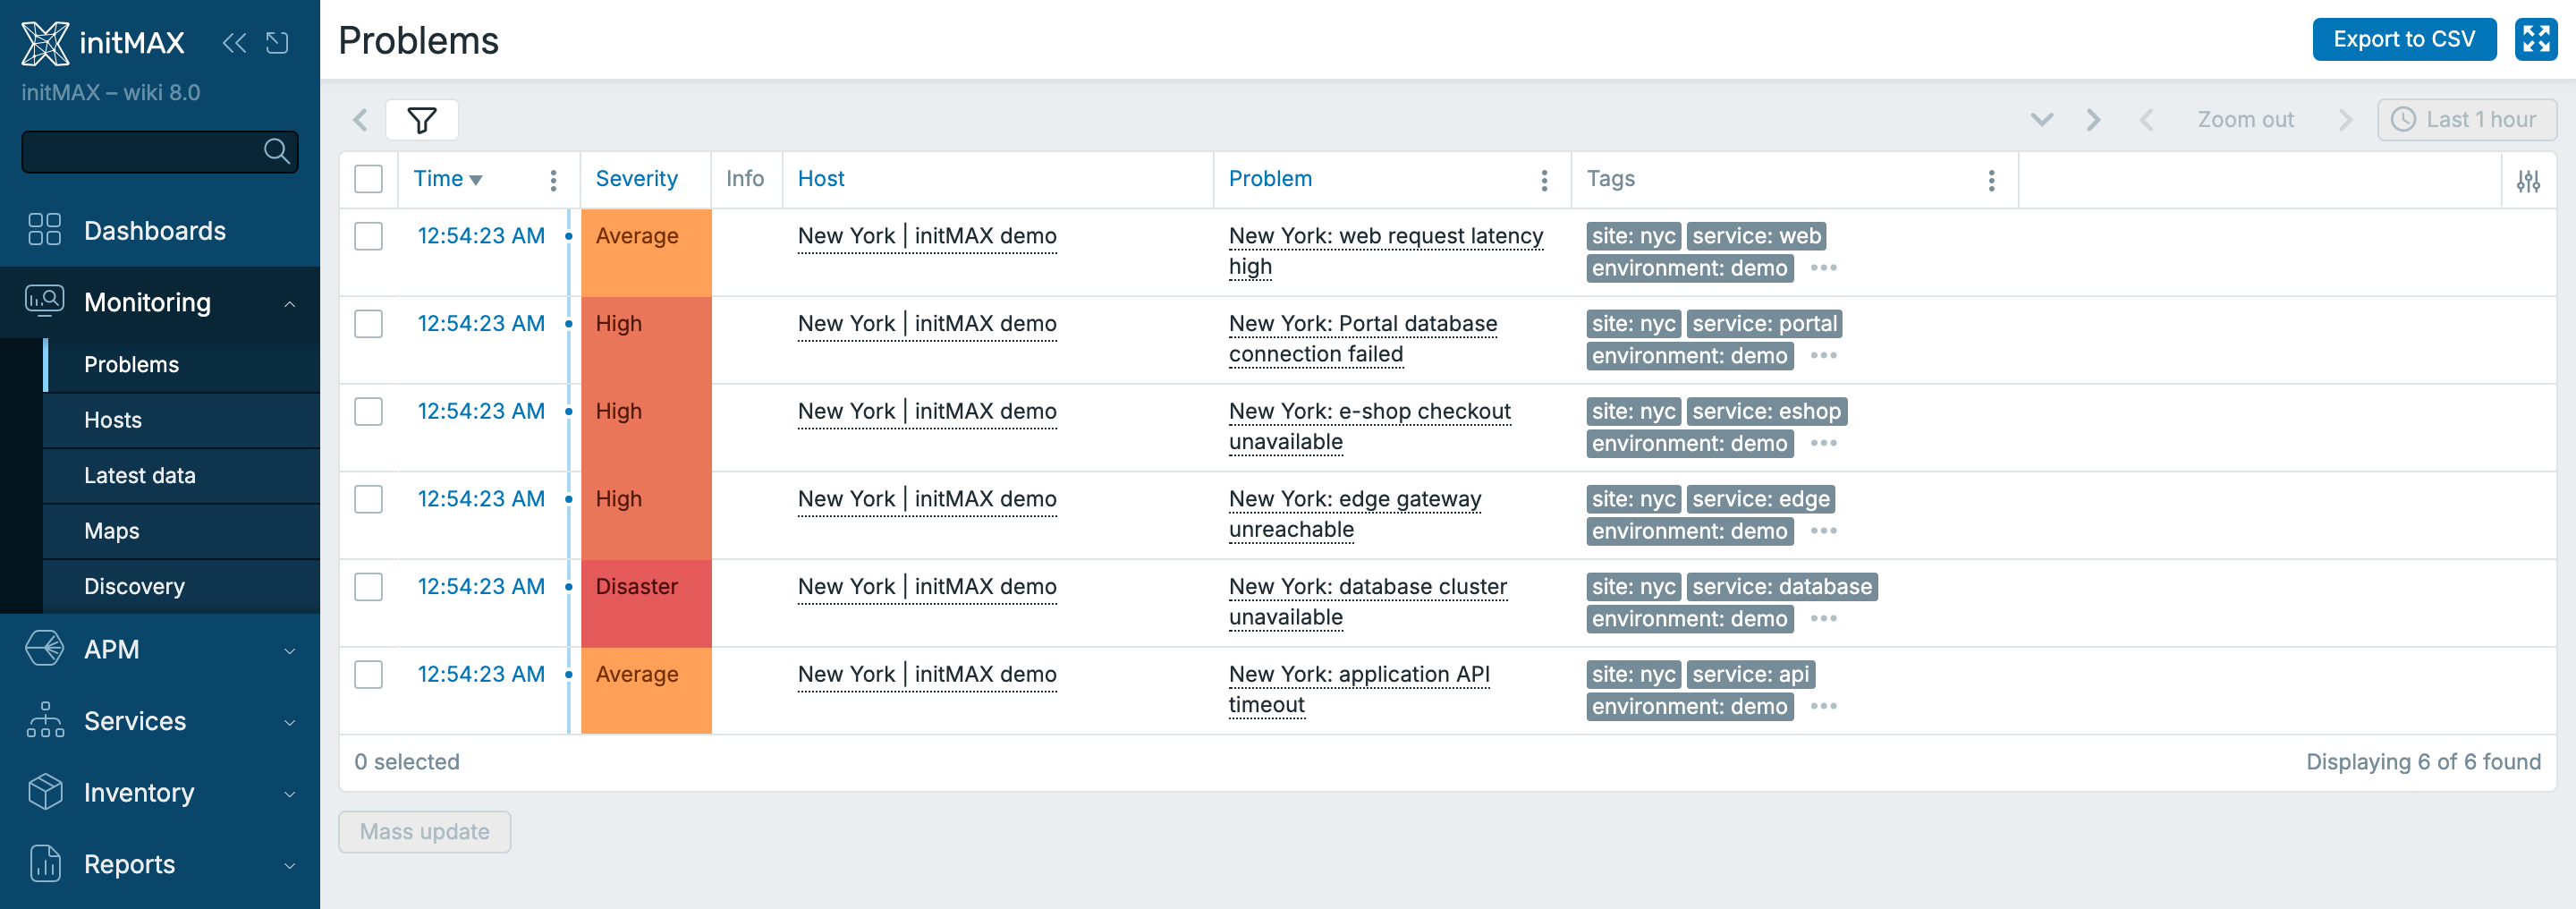
Bez korelace jde o běžný seznam problémů. Vidíme více událostí se společným kontextem, například site=nyc, region=us-east nebo podobné služby, ale Zabbix je v této podobě stále zobrazuje hlavně jako samostatné problémy. Operátor si vztah mezi nimi musí odvodit z názvů, hostů, severity a tagů.
- problémy vznikly ve stejném časovém úseku,
- část z nich má stejné lokalizační tagy, například
site=nycaregion=us-east, - tag
servicerozlišuje web, portál, e-shop, gateway, databázi a API, - bez další logiky ale není na první pohled jasné, co je hlavní příčina a co jsou jen následné symptomy.
Po korelaci
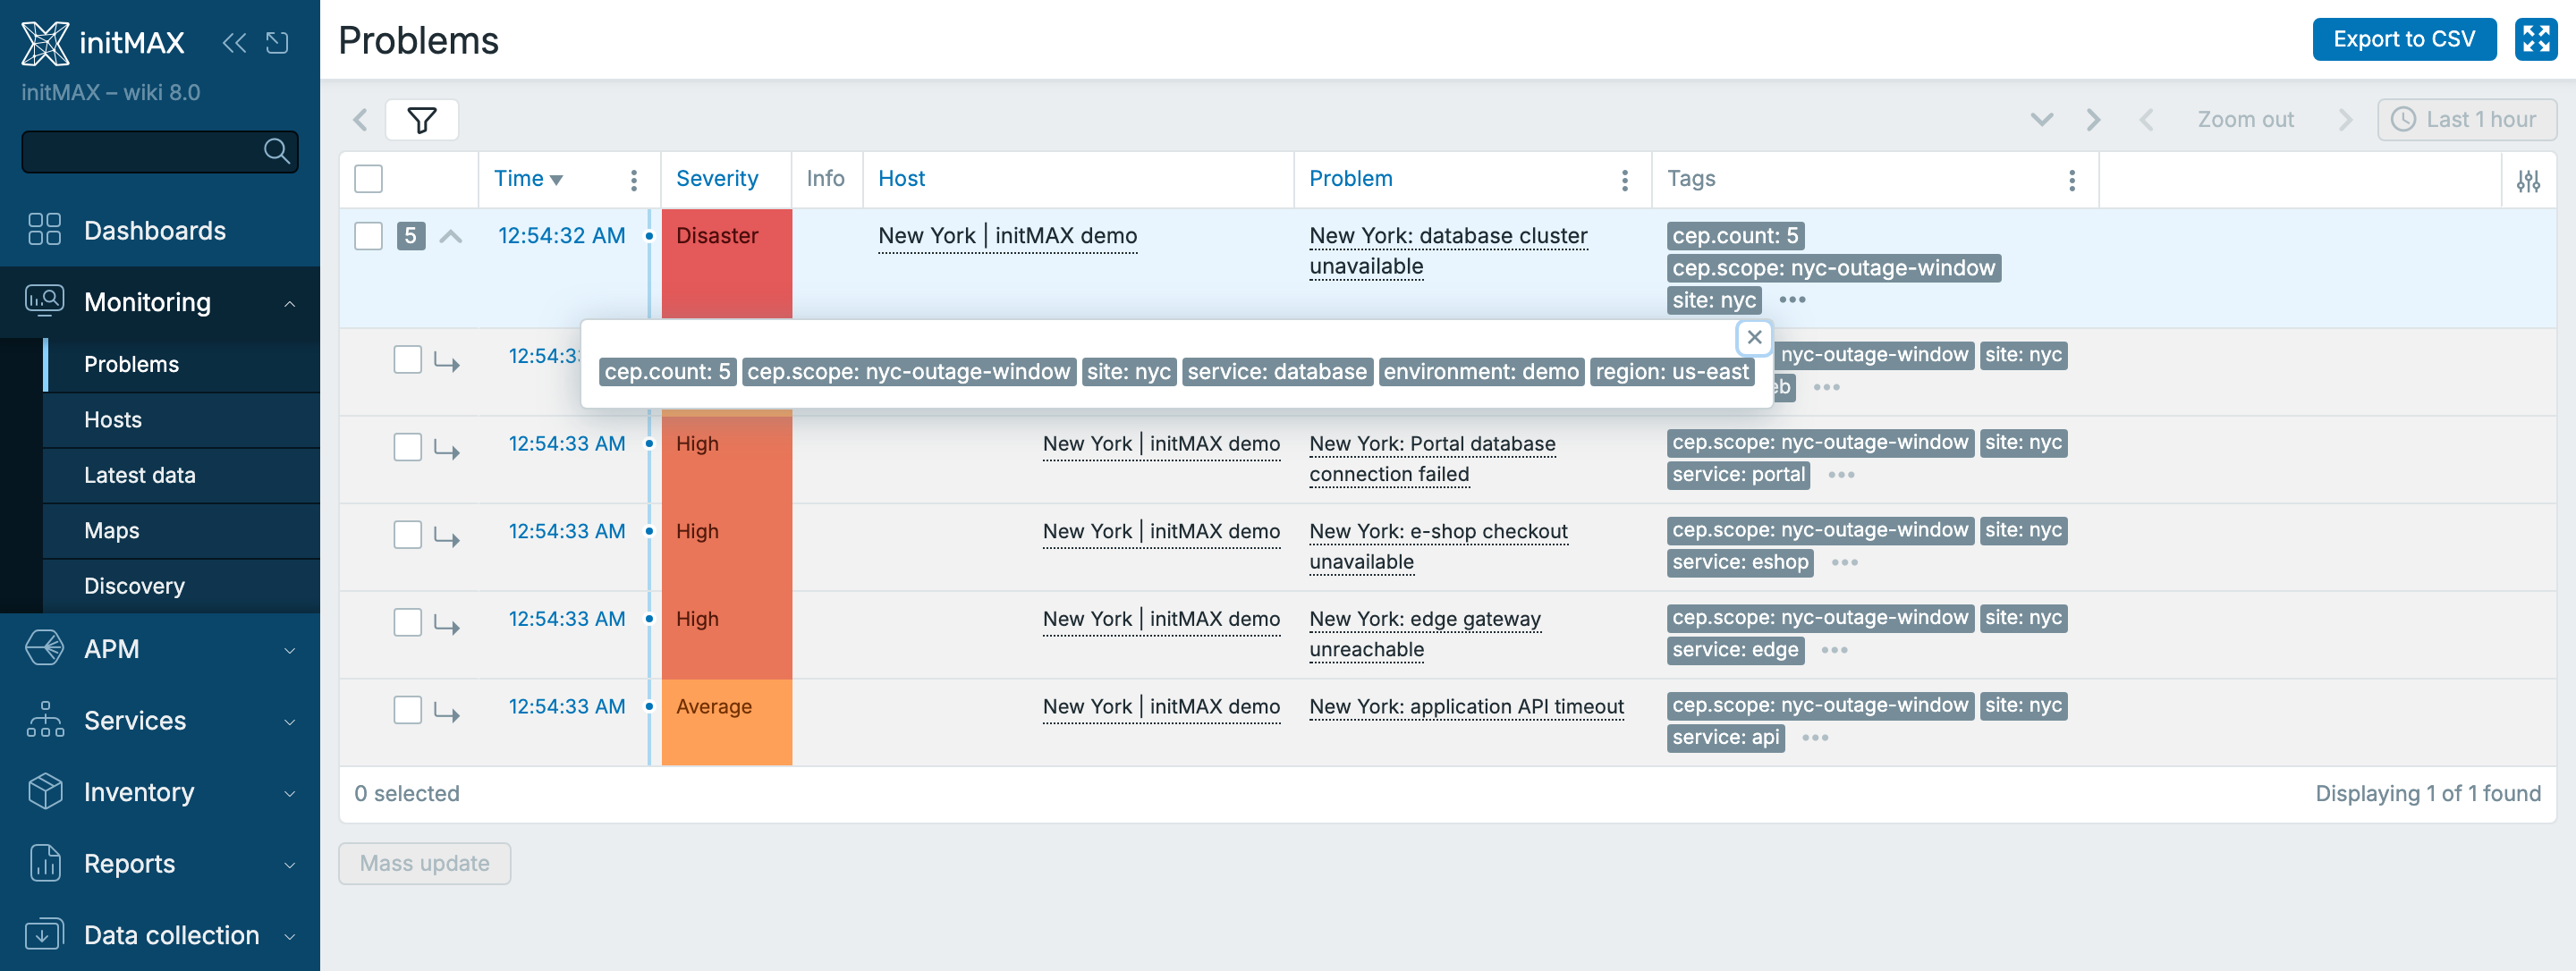
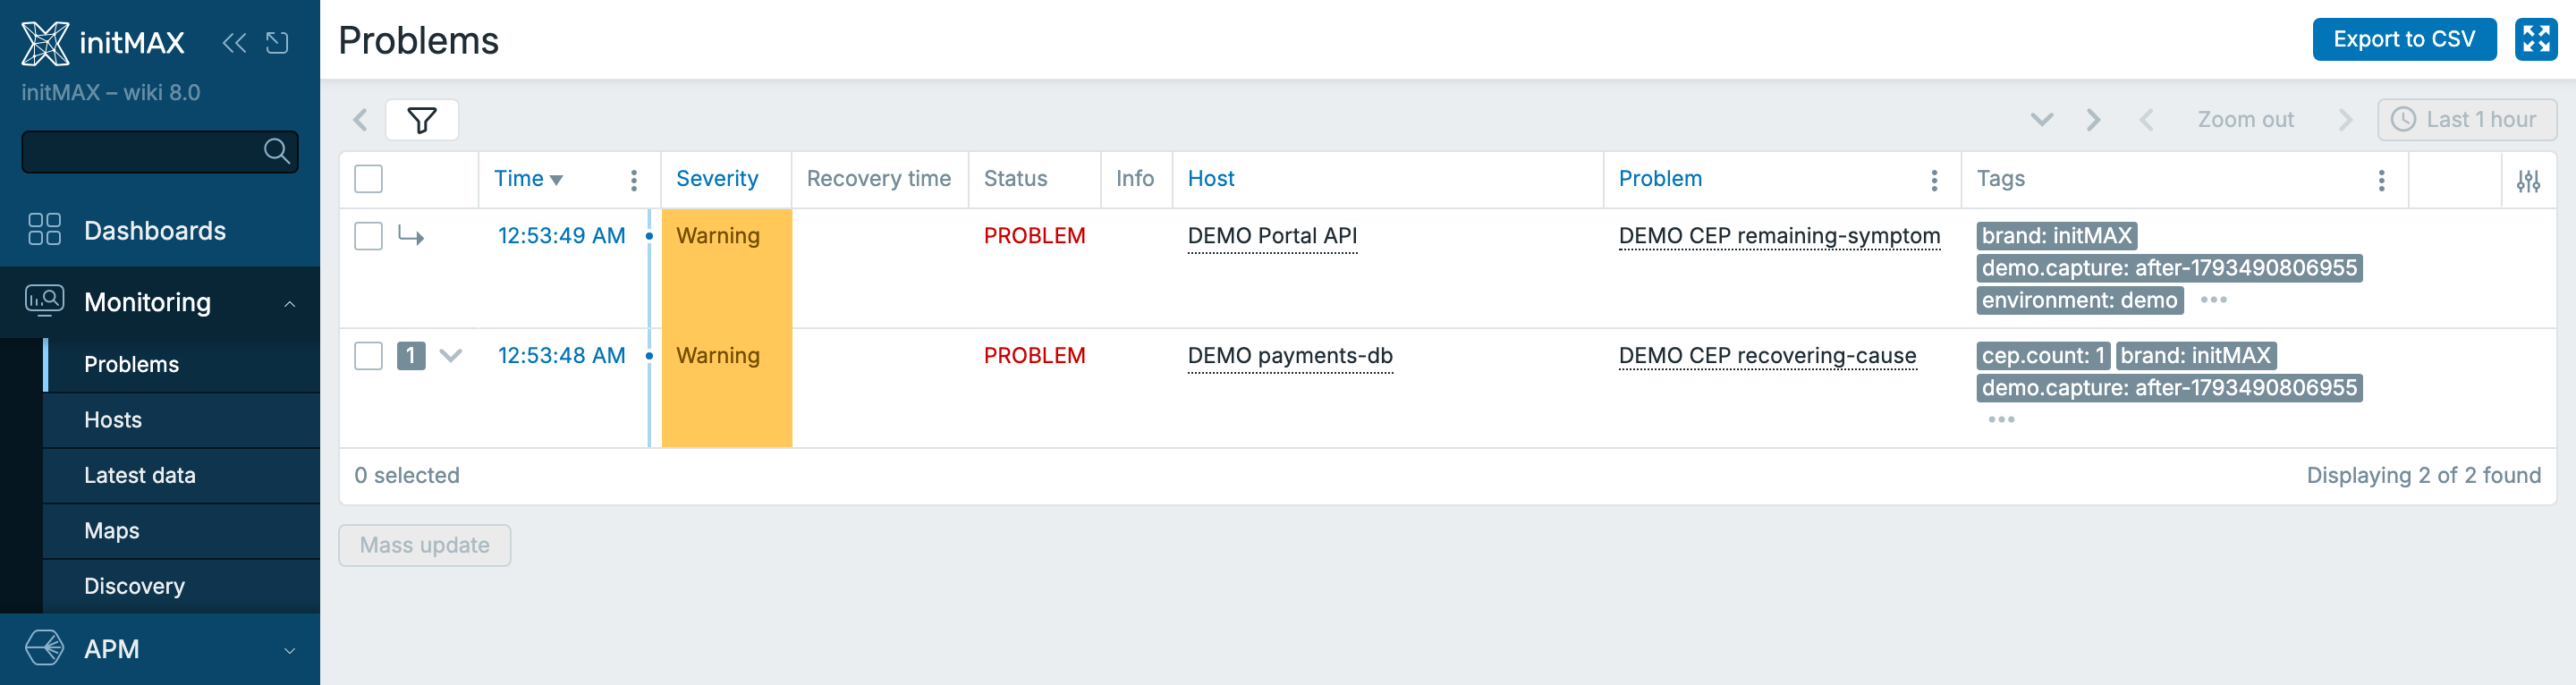
Po zpracování CEP pravidlem jsou problémy propojené jako jedna příčina a pět symptomů. V ukázce vznikl databázový problém jako první, a proto ho režim Cause and symptoms grouping zvolil za příčinu. Nejde o automatické odhalení skutečné technické příčiny: kdyby jako první vznikl aplikační timeout, vedl by skupinu on. V pohledu Problems jsou ostatní problémy rozbalené pod příčinou a tag cep.count=5 udává počet jejích symptomů.
- Root cause zůstává viditelný jako hlavní problém, na který se má operátor zaměřit jako první.
- Symptomy nezmizí, ale jsou svázané s hlavní příčinou. Dávají kontext, aniž by se tvářily jako samostatné incidenty stejné důležitosti.
- Společné tagy, například
cep.scope=nyc-outage-window, umožní pozdější filtrování, reporting nebo navázání notifikací a automatizace. - Count tag, například
cep.count=5, ukazuje počet souvisejících symptomů nebo rozsah zasažené skupiny přímo v event datech.
Praktický dopad je v tom, že monitoring nepředkládá jen delší seznam jednotlivých problémů. Události dostanou kontext: co spolu pravděpodobně souvisí, co vypadá jako příčina, které problémy jsou následky a jak velká skupina událostí do incidentu patří.
Příklad: společná databáze webu, e-shopu a portálu
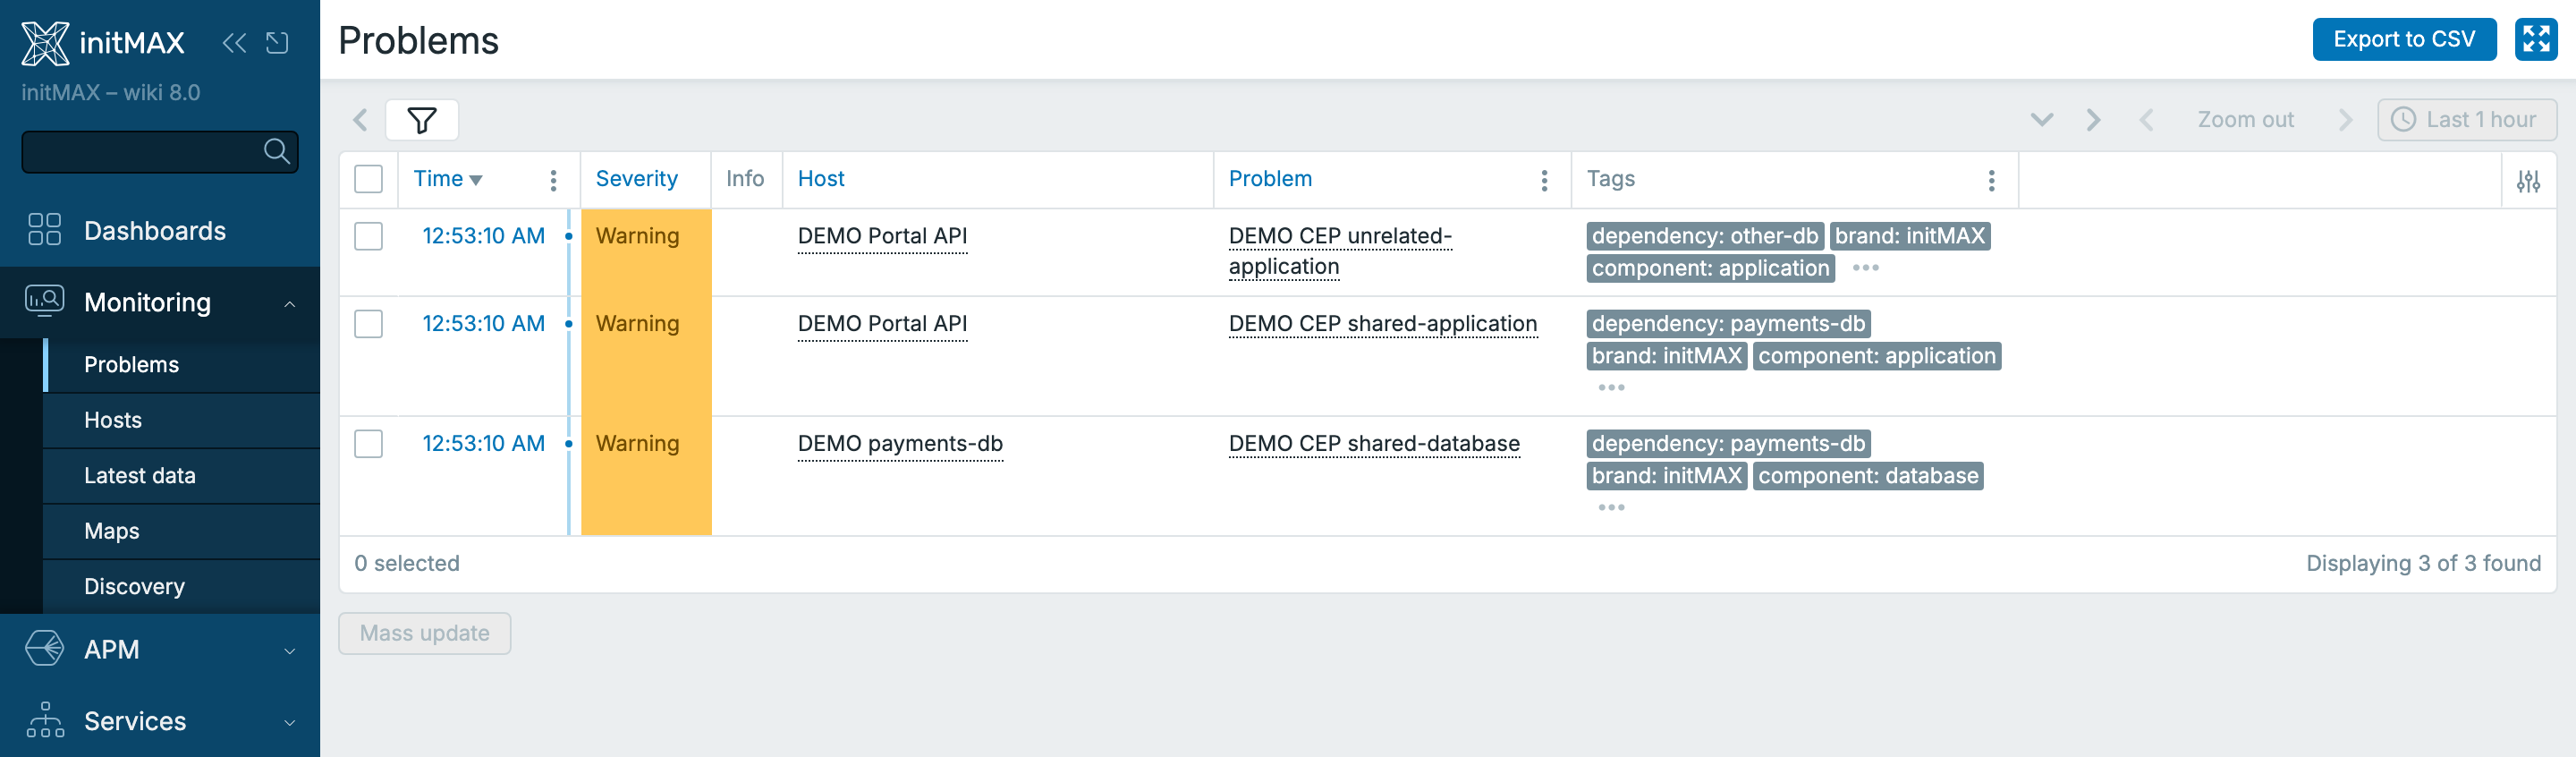
Před korelací
Po korelaci
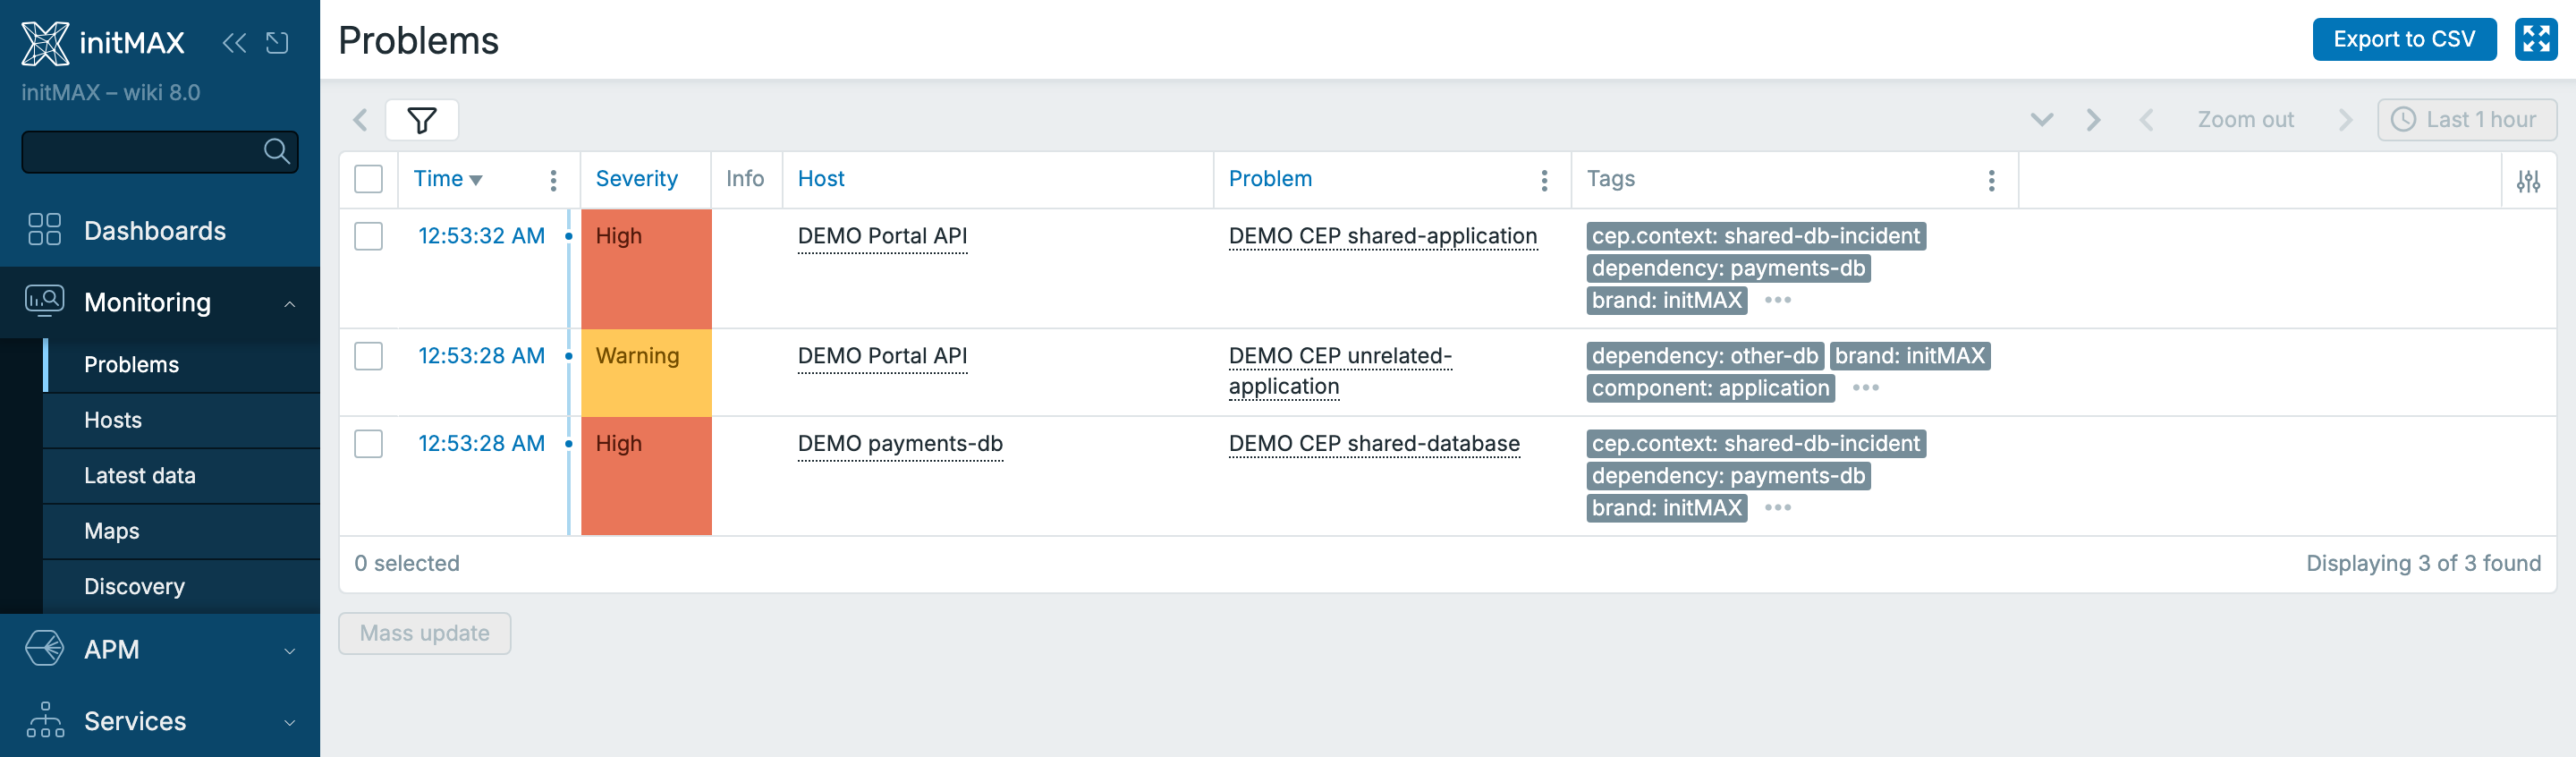
Web, e-shop i portál běží na různých hostech, ale používají stejnou databázi. Samotná databázová hláška ještě nemusí znamenat výpadek zákaznických služeb. Zajímá nás až kombinace problému databáze a chyby alespoň jedné aplikace.
- Vstup: databázové i aplikační eventy mají
dependency=payments-dbaenvironment=production. Tagcomponentrozlišuje hodnotydatabaseaapplication. - Pravidlo: Pattern match, Duration
5m, Group by podle tagůdependencyaenvironment. Seskupení podle Host nezapínáme, protože potřebujeme spojit různé hosty. Skript ověří, že jsou v okně současně otevřené oba typy problémů:
var events = cep_get_events();
function hasComponent(component) {
    return events.some(function(event) {
        return event.is_open && event.tags.some(function(tag) {
            return tag.tag === 'component' && tag.value === component;
        });
    });
}
return hasComponent('database') && hasComponent('application');
Výsledek: při Pattern matched nastavíme otevřeným eventům přes All events a filtr Problem is open společný tag cep.context=shared-db-incident a severity High. Operací Close (window) poté ukončíme toto vyhodnocení.
Samostatný databázový problém podmínku nesplní. Závažnost se zvýší až po potvrzení dopadu do aplikace. Tento příklad události společně klasifikuje; režim Pattern match jim sám nevytváří vztah příčina–symptom a uzavření okna neuzavře jejich problémy.
Příklad: služba opakovaně vypadává a zase se obnovuje
Před korelací
Po korelaci
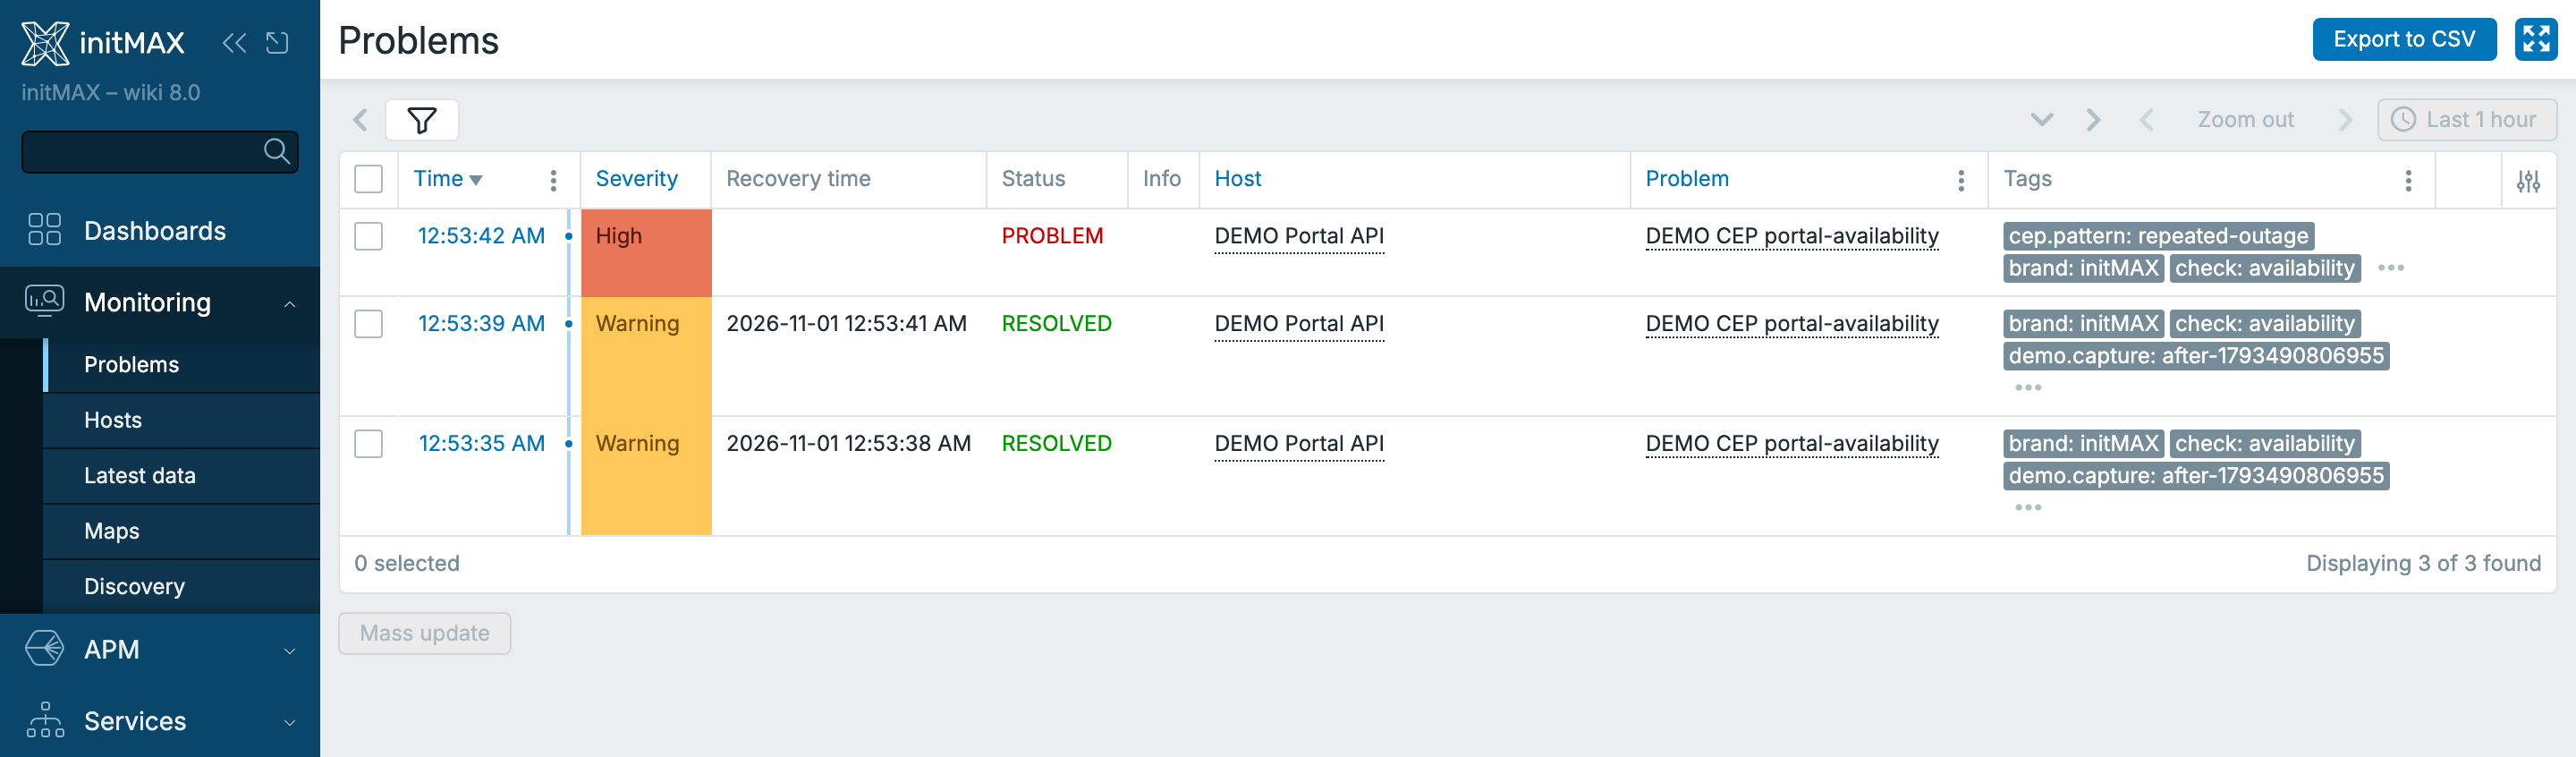
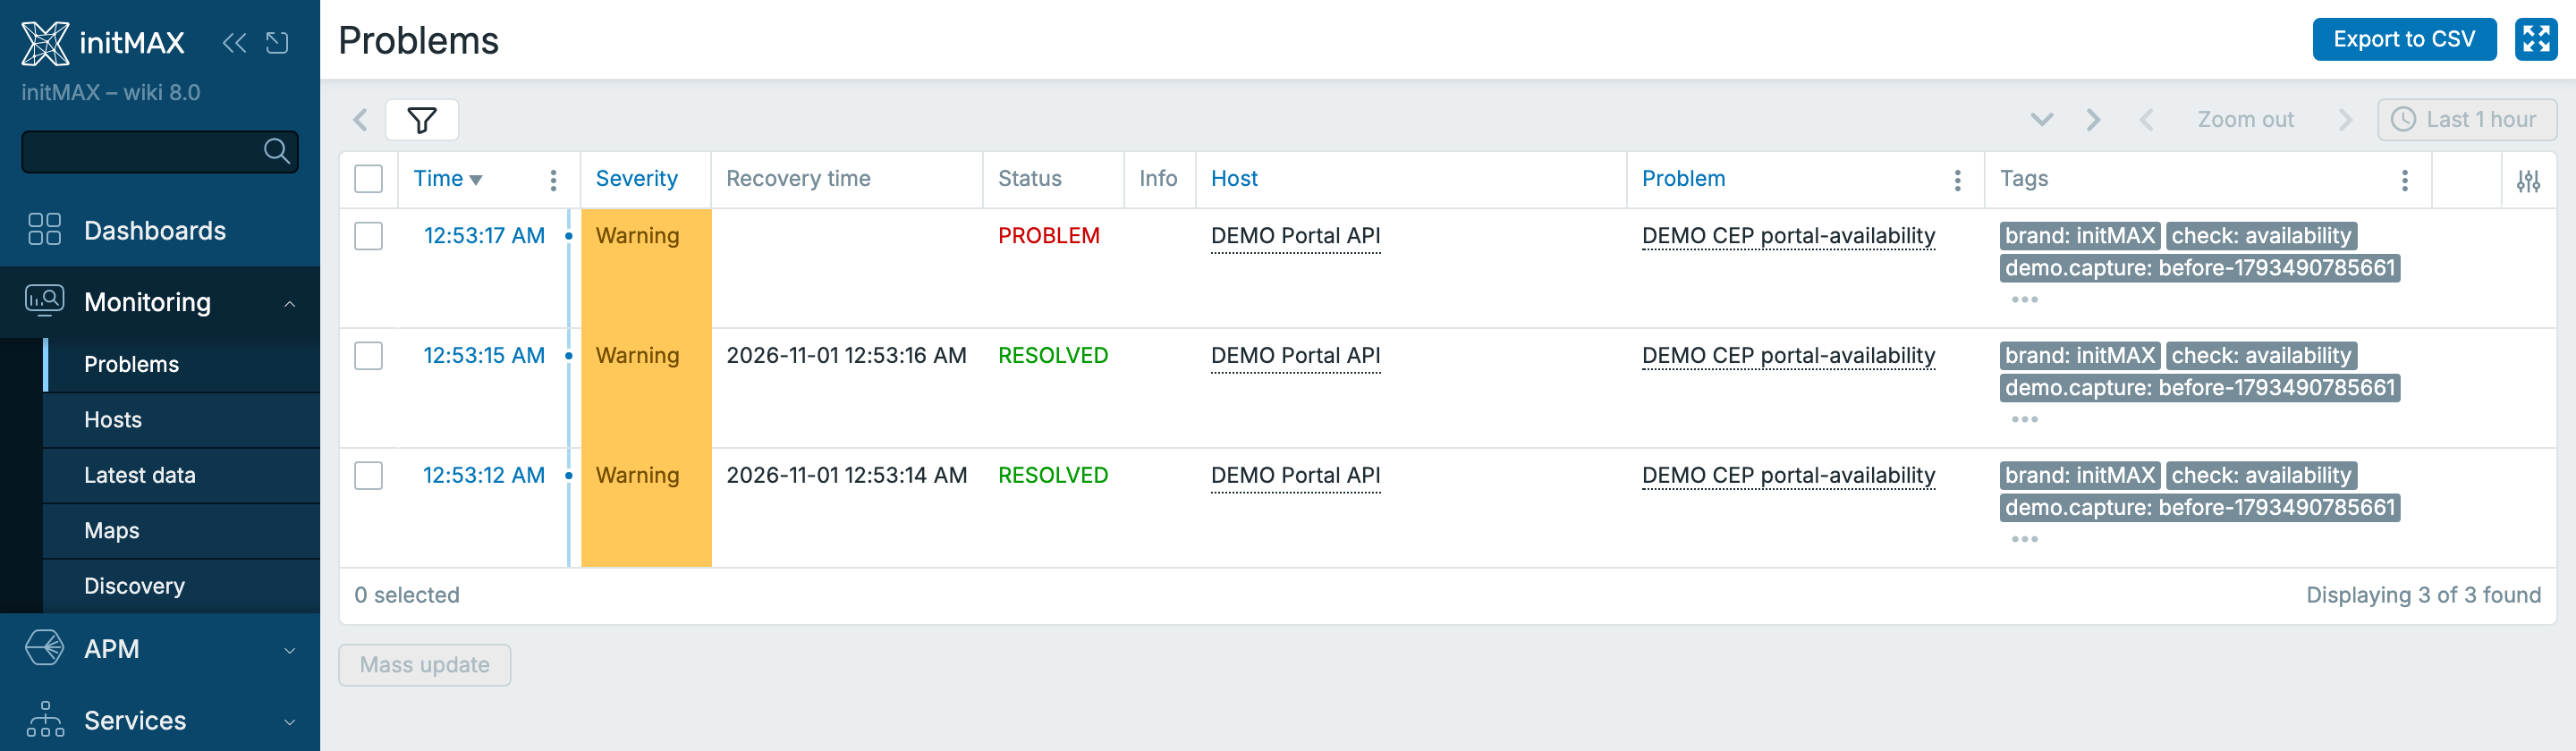
Portál se třikrát během deseti minut odmlčí, ale první dva výpadky se rychle obnoví. V aktuálním seznamu tak může zbýt jediný problém, přestože opakování ukazuje na nestabilní službu.
- Vstup: eventy konkrétní kontroly dostupnosti mají například
service=portal-apiacheck=availability. Trigger používá běžné vytváření jednoho problému při přechodu do stavu PROBLEM, ne opakované generování během jednoho trvajícího výpadku. - Pravidlo: Pattern match, Duration
10m, Group by podle Host a taguservice. Počítáme nové problémové eventy v okně, včetně těch, které se už obnovily. Kopie eventů do počtu nezahrnujeme:
return cep_get_events().filter(function(event) {
    return !event.is_copied;
}).length >= 3;
Výsledek: po třetím eventu nastavíme přes Pattern matched právě otevřeným problémům severity High a tag cep.pattern=repeated-outage. Následné Close (window) zabrání opakování stejných operací nad již vyhodnocenou skupinou.
Jeden desetiminutový výpadek není totéž jako tři nové výpadky. Stejně tak nesčítáme chyby různých služeb nebo hostů. Starší obnovené události zůstávají součástí historie; neotevírají se znovu a změna severity sama o sobě neposílá notifikaci bez odpovídající konfigurace akcí.
Příklad: očekávané hlášky během noční zálohy
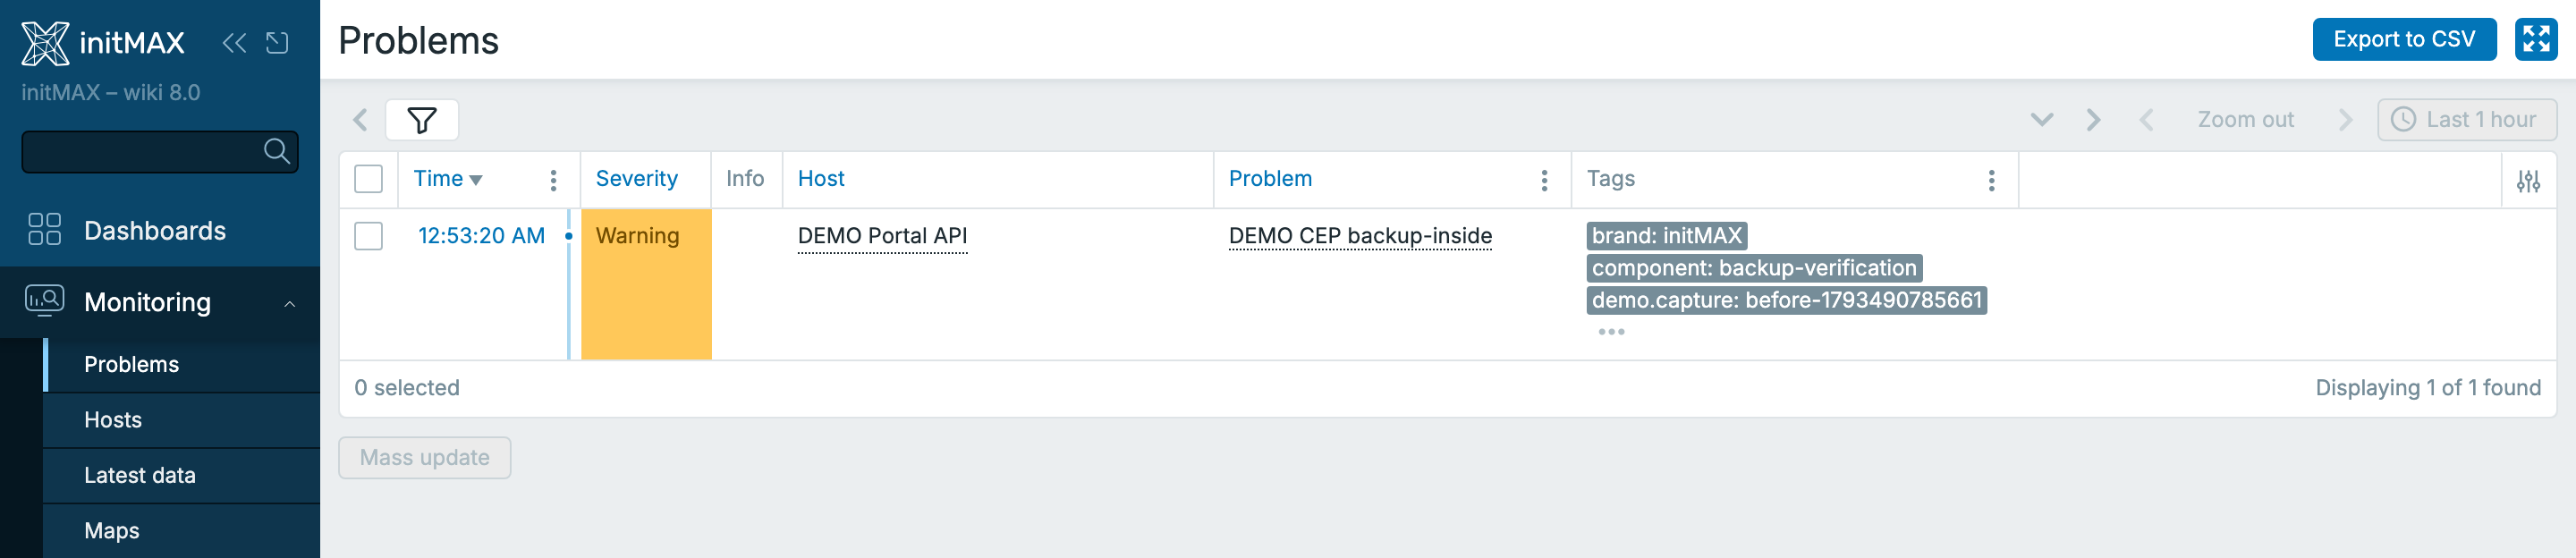
Před korelací
Po korelaci
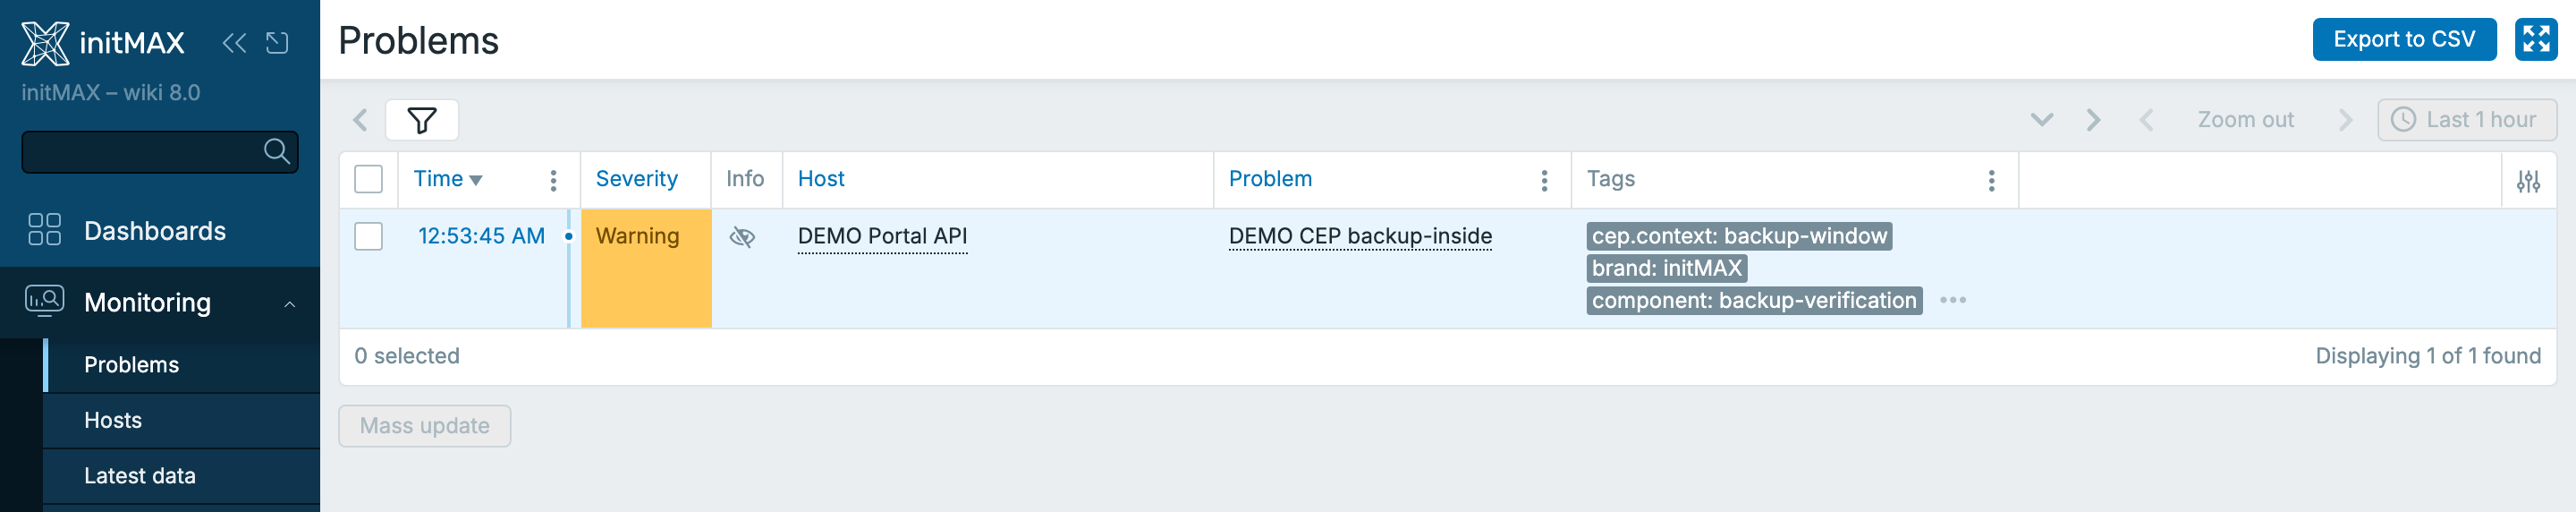
Během zálohy pravidelně vznikají krátké problémy konkrétní kontroly, které nechceme řešit stejně jako neočekávaný výpadek přes den. Nechceme ale vypnout monitoring celého hosta.
- Vstup: přesně vybraná skupina hostů a eventy se štítkem
component=backup-verification. Podmínka Time period omezí pravidlo například na1-7,02:00-02:15; rozhoduje čas vzniku eventu a časová zóna serveru. - Pravidlo: Time window None. Při Event occurred nastavíme tag
cep.context=backup-windowa použijeme Suppress s Duration15m. - Výsledek: odpovídající problémy zůstanou dohledatelné, ale jsou dočasně potlačené a označené jako součást zálohovacího provozu. Jiný typ problému ani stejná hláška mimo daný časový interval tímto pravidlem potlačené nebudou.
Doba potlačení běží od každé operace, ne od začátku plánovaného intervalu. Event z 02:14 tedy může zůstat potlačený přibližně do 02:29. Po vypršení potlačení se nevyřešený problém automaticky neuzavře. Pro plošnou plánovanou odstávku je vhodnější Maintenance; CEP zde cíleně upravuje jen vybraný druh událostí.
Příklad: databáze už běží, ale aplikace se neobnovila
Před obnovou příčiny
Po obnově příčiny
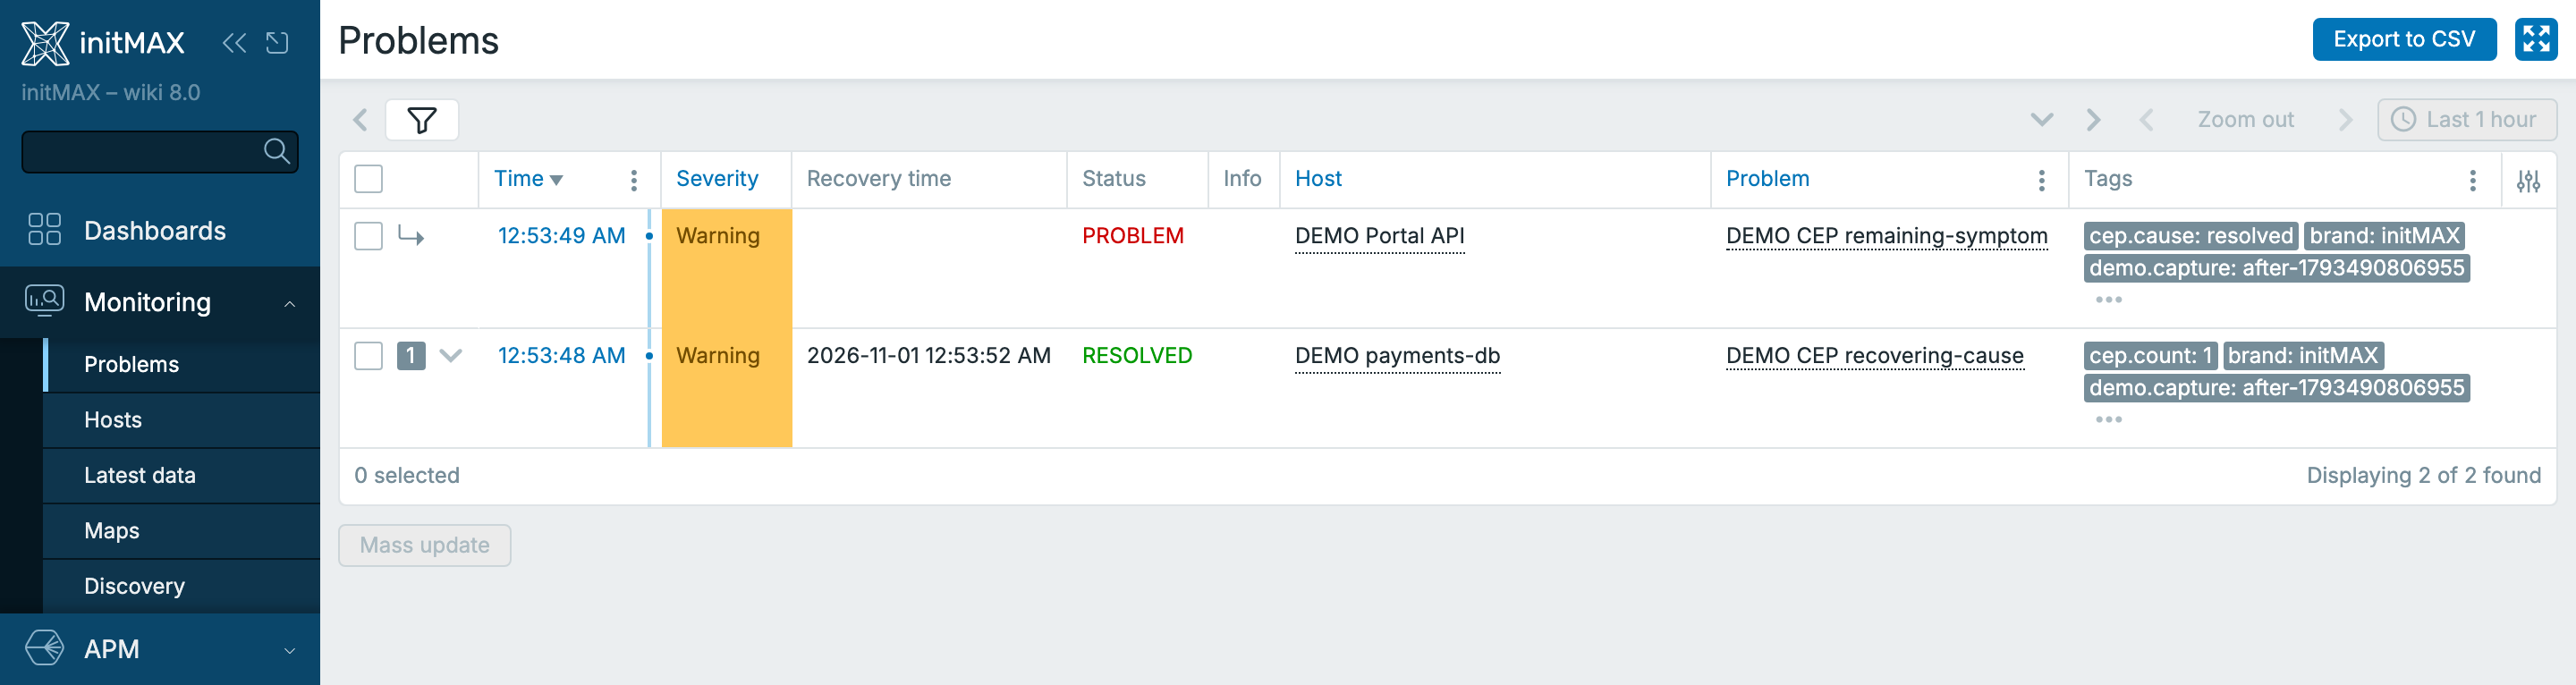
Vraťme se ke skupině příčiny a symptomů z New Yorku. Databáze se obnoví, ale portál stále hlásí chybu připojení. Právě takový zbytek incidentu je potřeba zvýraznit: obnova příčiny ještě neznamená obnovu všech služeb.
- Vstup: příčina a její symptomy stále patří do stejného okna režimu Cause and symptoms grouping. Uzavření příčiny musí nastat, dokud je toto okno aktivní.
- Pravidlo: Execute when Event closed, podmínka Problem is symptom = No. Operace Set nastaví
cep.cause=resolved; v Applies to zvolíme Other events a ve Filter vybereme Problem is symptom = Yes a Problem is open = Yes. - Výsledek: otevřené symptomy dostanou informaci, že příčina už skončila. Pokud je pravidlo předtím potlačilo, může nad stejným výběrem provést i Unsuppress. Operátor tak může dohledat služby, které potřebují samostatný zásah, například obnovení databázového spojení.
Neprovádíme hromadné uzavření symptomů. Portál se musí skutečně obnovit a jeho trigger vyhodnotit OK. Eventy z jiného okna se touto operací nezmění. Jakmile okno skončí, nelze od tohoto pravidla očekávat dodatečné zpracování pozdější obnovy příčiny.
Co zohlednit při nasazení CEP
CEP proto vnímáme jako jednu z hlavních změn Zabbixu 8.0. Nejde o náhradu dosavadní práce s problémy, ale o novou úroveň event managementu: Zabbix může nad událostmi udržovat kontext, spojovat je do souvisejících skupin a automaticky doplňovat informace, které administrátor jinak hledá ručně.
O délce okna a tagu pro seskupení rozhoduje konkrétní služba, ne univerzální hodnota. Příliš široké pravidlo může spojit nesouvisející incidenty. V prostředí s více zákazníky oddělte také tenant; u produkce a testu alespoň environment. Notifikační akce musí respektovat zvolenou severity, tagy a potlačení. Korelace sama nenahrazuje konfiguraci notifikací ani skutečnou obnovu služby.
Z provozního pohledu: časová okna se ukládají do databáze a přežijí restart serveru, CEP má vlastní workery s interním itemem pro statistiky a sekcí v diaginfo, a v API přibylo cep_ruleid ve výstupu event.get a problem.get. Změny provedené CEP se ukazují v historii eventu jako samostatný typ akce.
Původní global event correlation pravidla v rozhraní zůstávají a dál je lze používat. V části Event processing je od CEP odděluje typ Event correlation. Nový CEP přidává časová okna a širší možnosti zpracování; stávající pravidla se na něj automaticky nepřevádějí.
Mobilní aplikace Zabbix a push notifikace
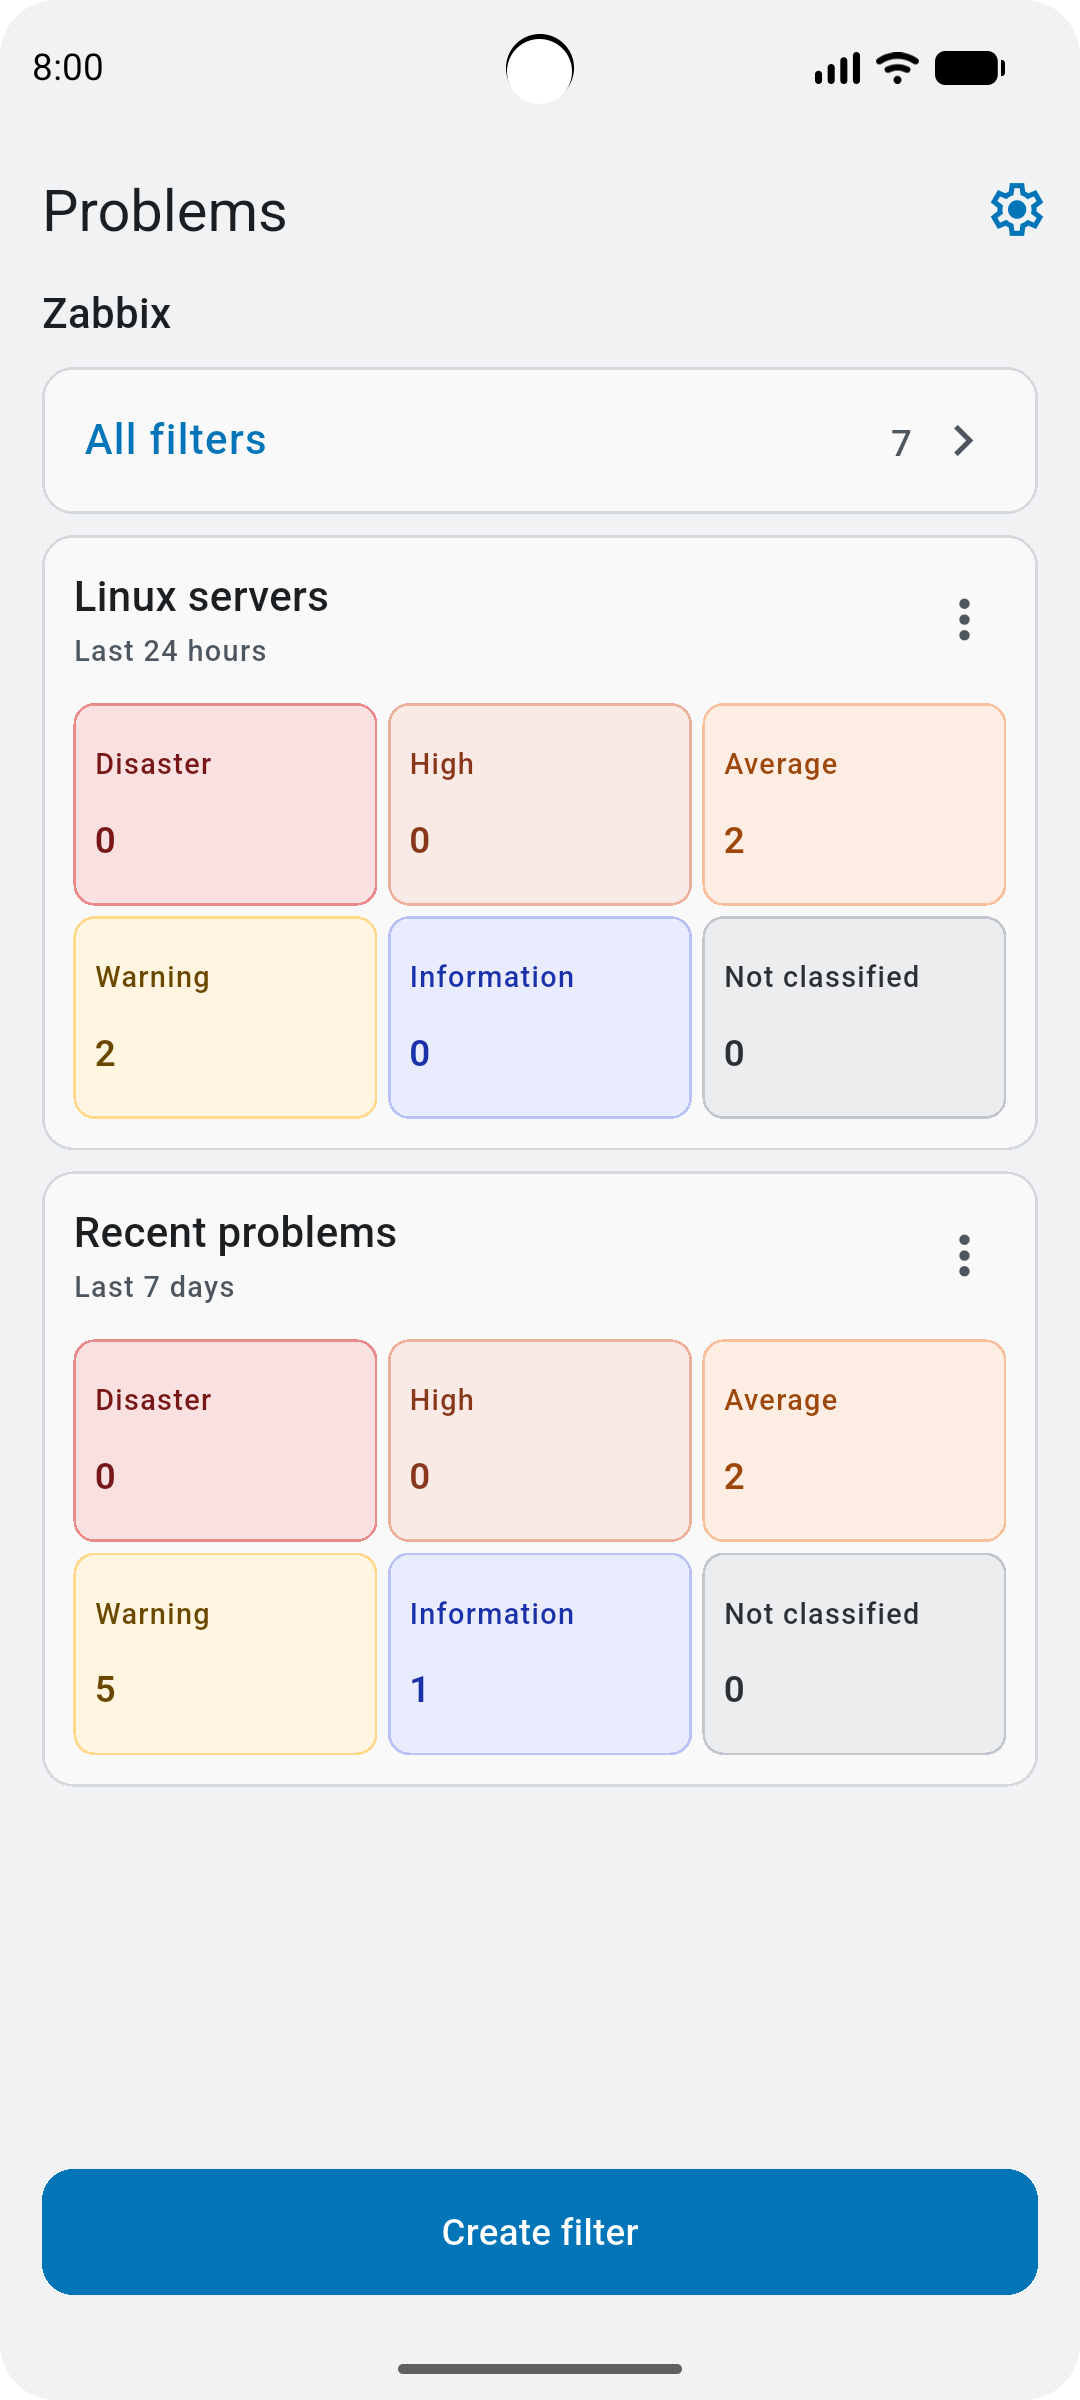
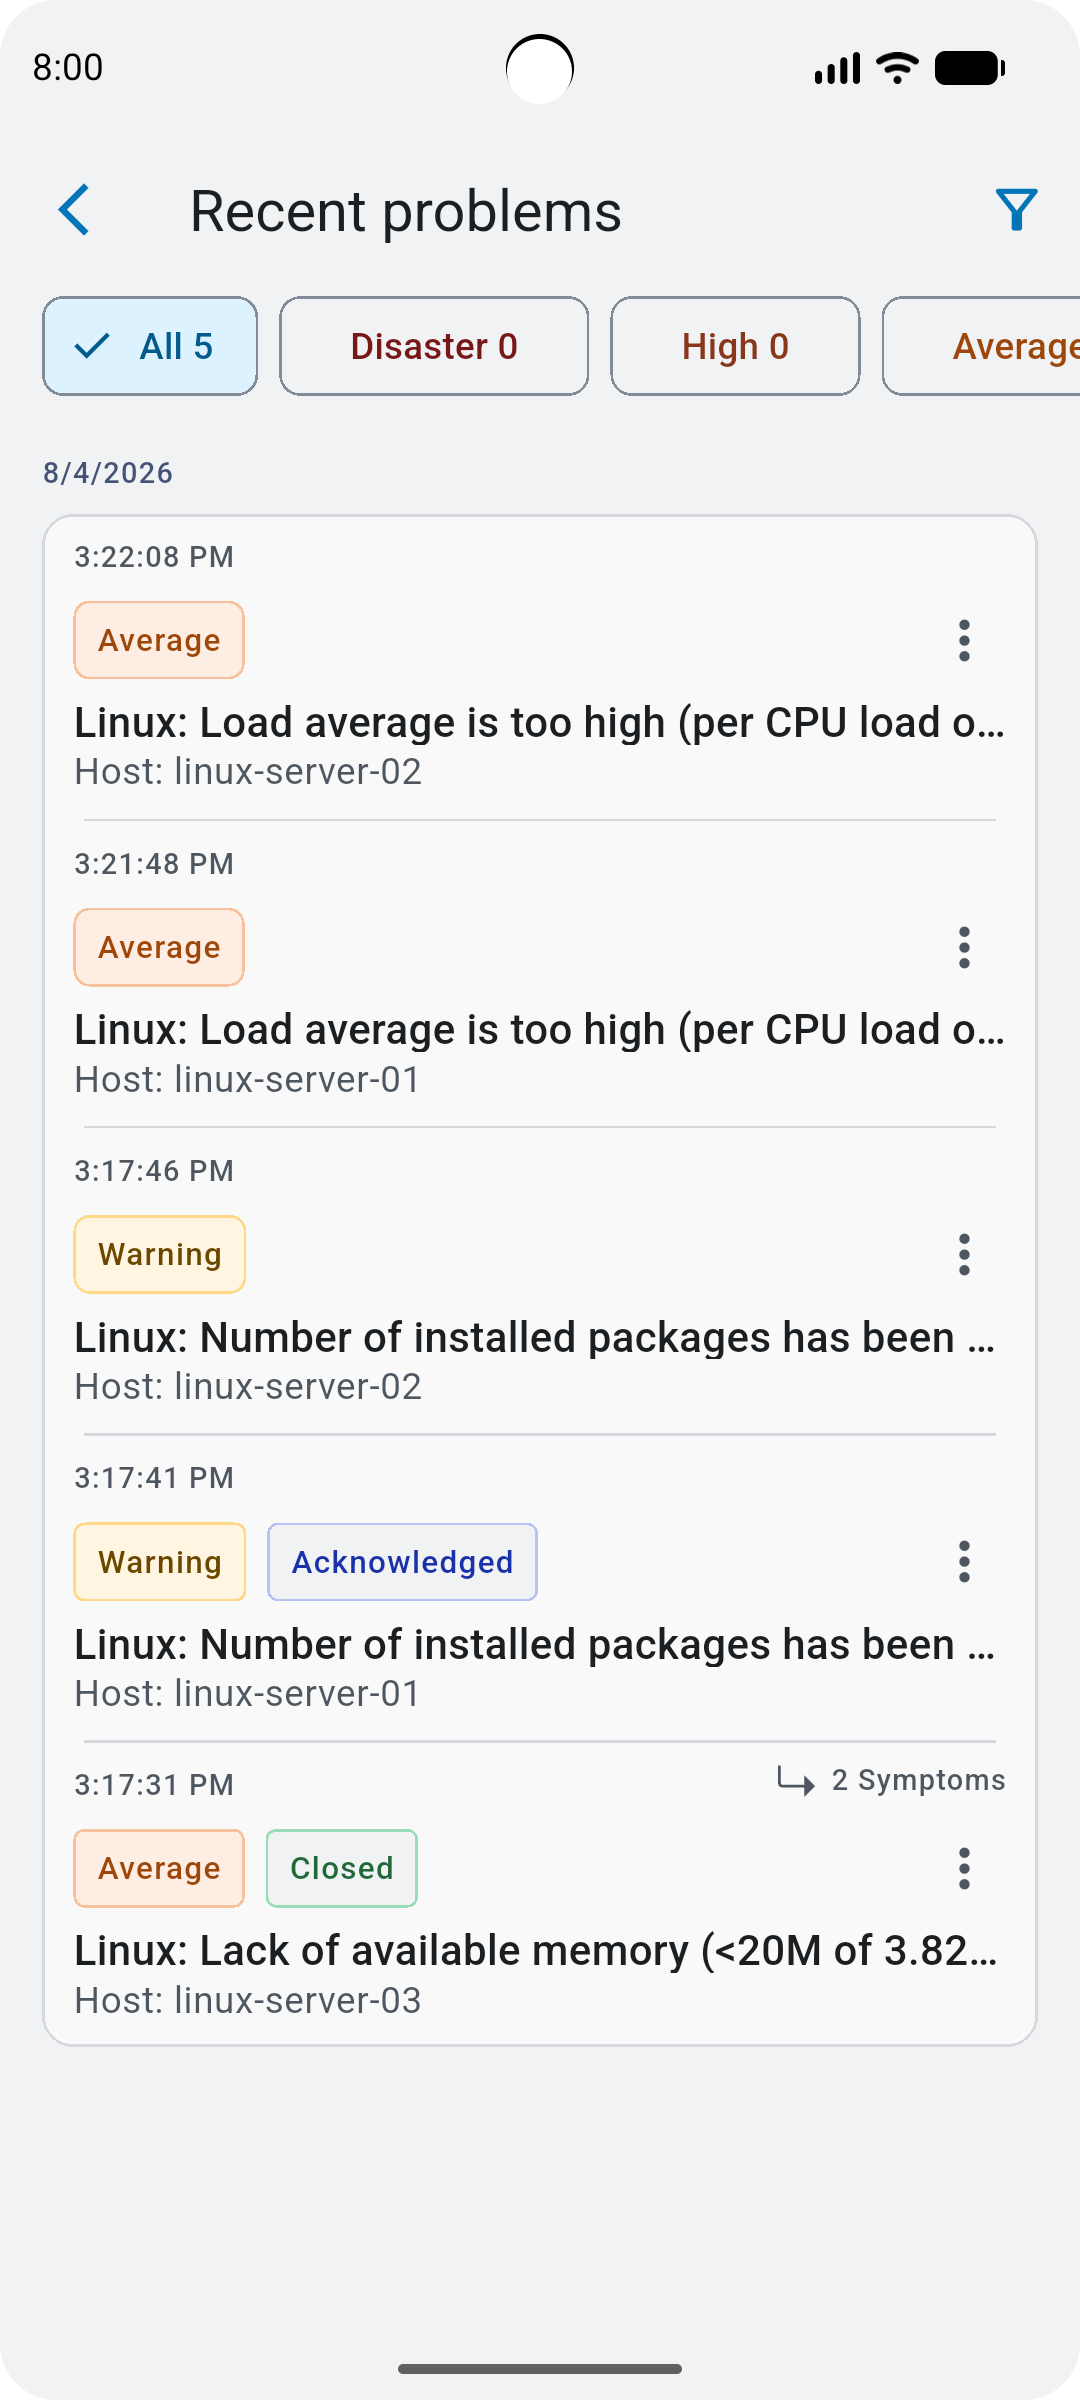
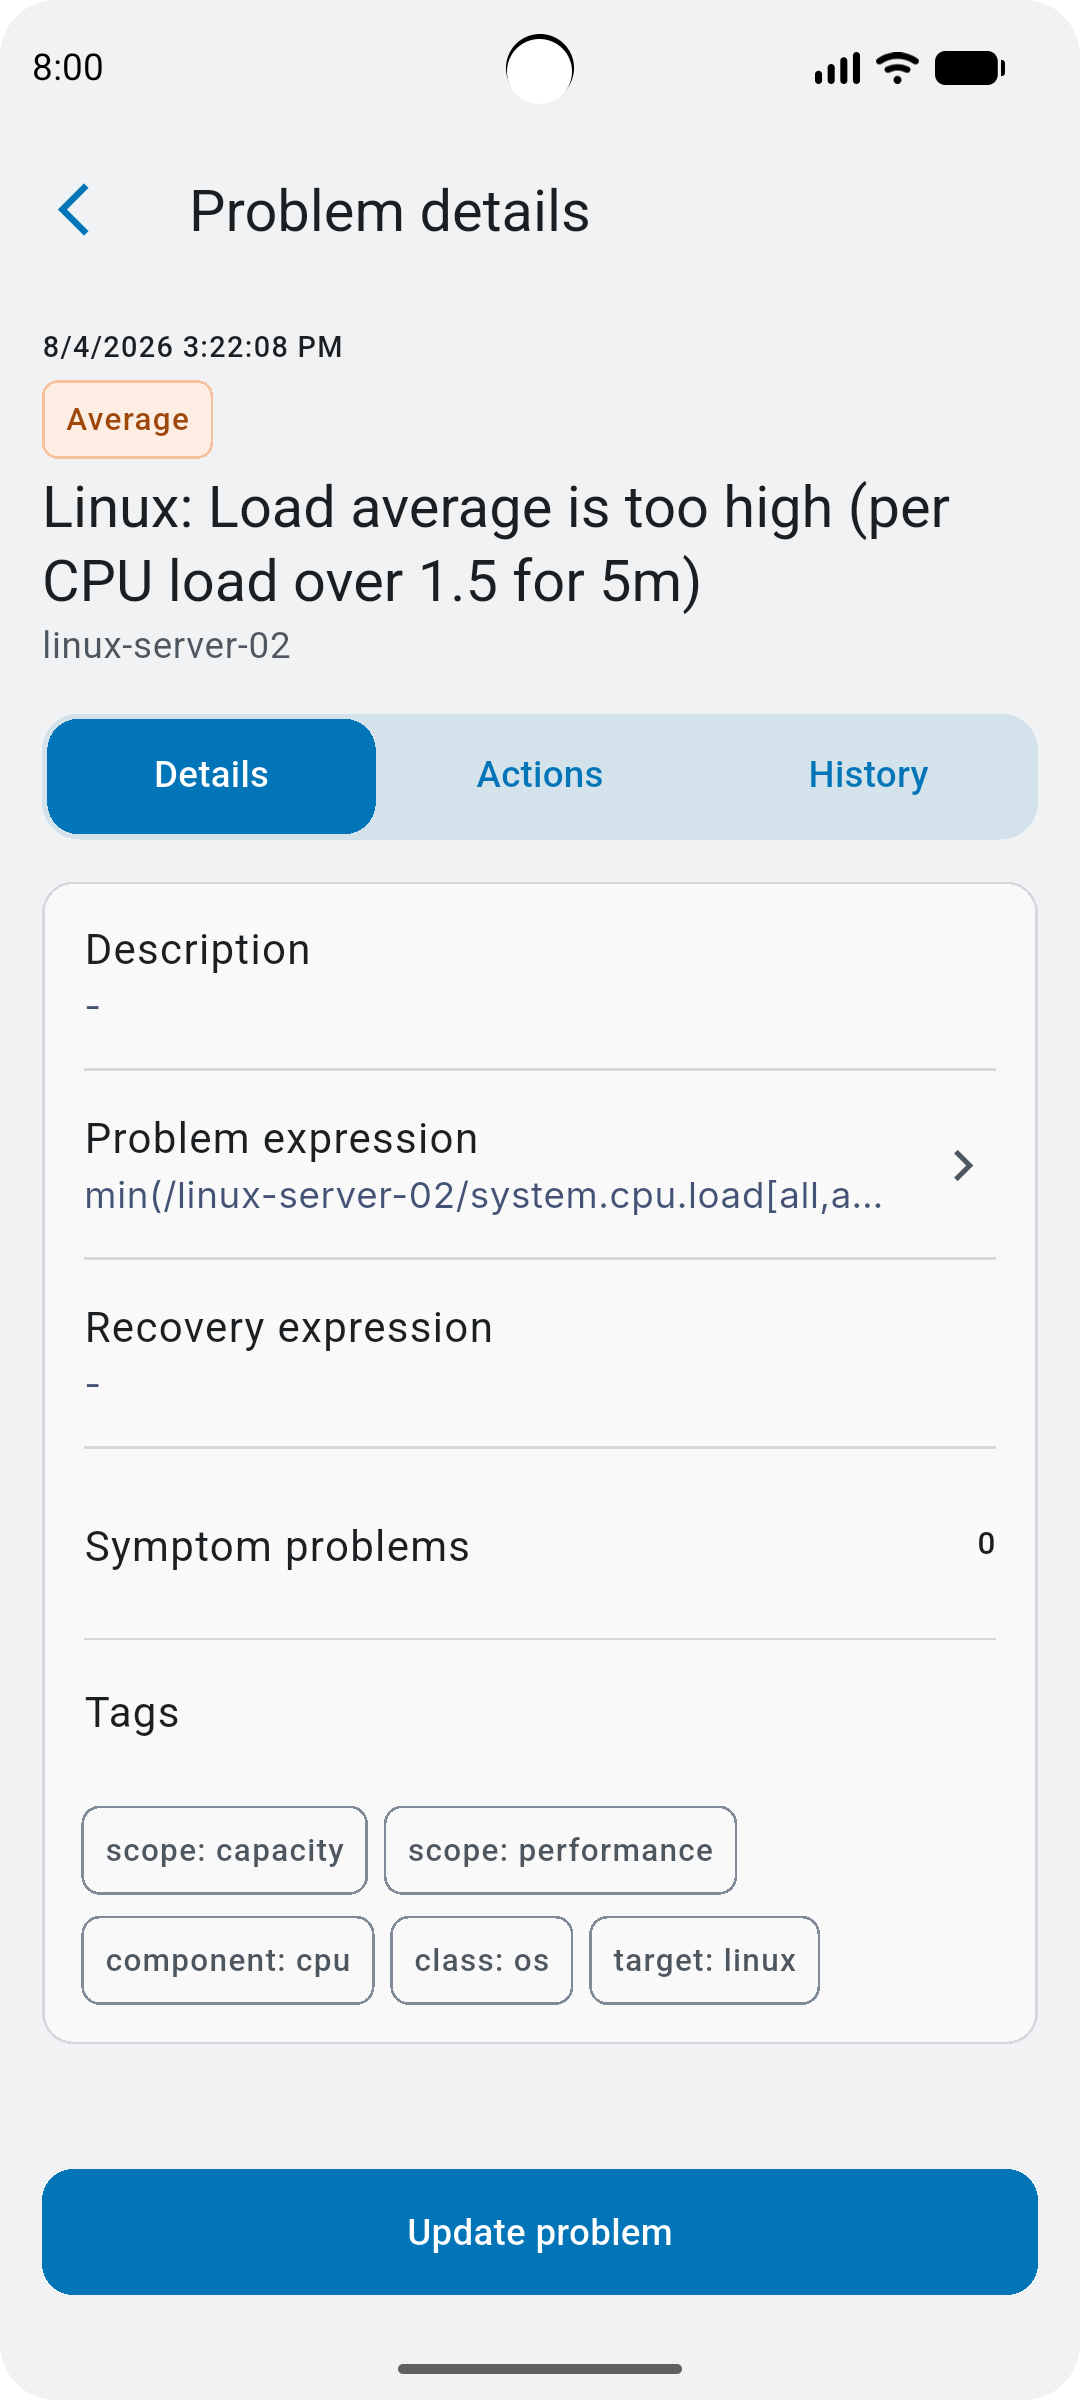
Zabbix 8.0 přináší serverovou část pro připravovanou oficiální mobilní aplikaci a nový typ media type Push. Samotná aplikace zatím není vydaná. Ve frontendu jsou již dostupné formuláře pro správu zařízení, jejich oprávnění v uživatelských rolích a konfiguraci media type Push. Připravované řešení má doručovat notifikace o problémech přímo do telefonu, bez e-mailu, SMS brány nebo webhooku třetí strany.
Ukázky připravované oficiální mobilní aplikace Zabbix: přehled problémů, seznam a detail problému.
Jak to funguje
Zabbix server neposílá push zprávy přímo. Mezi serverem a mobilní platformou stojí Bridge Adapter, samostatná služba s JSON-RPC rozhraním přes HTTP(S), na kterou se server obrací při párování zařízení (device.init) i při každé notifikaci (device.notify). Server jí předává události problem.created, problem.updated a problem.resolved včetně severity, priority, titulku a těla zprávy.
Připravovaná mobilní aplikace Zabbix Mobile App má fungovat jako samostatný klient pro iOS a Android, nikoli součást webového frontendu nebo balíčku Zabbix serveru. Párování zařízení, jejich oprávnění a push média se nastavují v Zabbixu; samotný mobilní klient a dostupný Bridge Adapter jsou další části řešení. Informace o aplikaci najdete na oficiální stránce Zabbix Mobile App.
Bridge Adapter instalujeme vedle Zabbix serveru nebo na samostatný stroj. Propojuje vlastní Zabbix s centrálně provozovanou službou Zabbix Bridge, přes kterou komunikuje mobilní aplikace. Nezprostředkovává jen push: požadavky aplikace předává místnímu Zabbix API a vrací jeho odpovědi. Mobil tak nemusí přistupovat přímo na veřejně vystavený frontend. Adaptér, mobilní aplikace a centrální Bridge jsou samostatné komponenty s vlastní EULA; nejde o součást otevřeného kódu Zabbix serveru.
Lokální Bridge Adapter patří do důvěryhodné části infrastruktury. Zabbix server mu předává titulek, tělo zprávy a metadata události spolu s veřejným šifrovacím klíčem telefonu. Není tedy správné předpokládat, že adaptér text problému nevidí. Šifrování pro mobilní zařízení a TLS mezi komponentami jsou různé vrstvy ochrany; podle nasazení použijte i vzájemné ověřování certifikáty. Mobilní přístup k API používá DPoP, který váže token na klíč zařízení a kontroluje podpis i opakované použití požadavku.
Konfigurace serveru
EnableMobileDevices má výchozí hodnotu 1. To ale samo o sobě nezprovozní párování ani push: server potřebuje nakonfigurovaný a dostupný adaptér. V zabbix_server.conf nastavíme jeho adresu:
EnableMobileDevices=1
BridgeAdapterURL=https://bridge.example.com:10054/rpc
BridgeAdapterURL je adresa našeho místního adaptéru, nikoli centrální služby Zabbix Bridge. Adaptér nemusí běžet na stejném stroji jako server; zvolené jméno musí vést na jeho dostupné HTTPS rozhraní. Parametr BridgeAdapterConnectTo aktuální server nepodporuje. Pro jinou síťovou cestu použijte odpovídající DNS a směrování při zachování ověřitelného jména v TLS certifikátu.
HA Zabbix serveru neznamená automaticky HA Bridge Adapteru. V clusteru musí mít každý serverový uzel nakonfigurovaný a dostupný endpoint adaptéru. Jeho dostupnost a obnovu řešte samostatně, včetně uchování DataDir se stavem registrace a klíči. Ztráta tohoto stavu může zabránit opětovné registraci stejného serveru.
Při EnableMobileDevices=0 nejsou funkce zařízení dostupné. Bez nakonfigurovaného a dostupného adaptéru nelze dokončit párování ani doručovat push notifikace.
Bridge Adapter: konfigurace a přístup k API
Samostatný balíček zabbix-bridge-adapter používá konfiguraci /etc/zabbix/zabbix_bridge_adapter.conf. Potřebuje zejména ServerId z Reports > System information a ZabbixAPIURL vedoucí na vlastní API. Server komunikuje s adaptérem standardně přes TCP 10054; adaptér potřebuje spojení k místnímu API a odchozí komunikaci k Zabbix Bridge. Vnější dostupnost portu 10054 z telefonu není podmínkou.
AllowedAPIMethods omezuje metody, které adaptér smí přeposlat. Pro mobilní práci s problémy zahrnuje například problem.get, event.get a event.acknowledge; párování využívá device.onboard a device.offboard. Seznam nenahrazuje oprávnění uživatele v Zabbixu. Zároveň je třeba rozlišit prázdné nastavení, které metody nepovolí, od distribuovaného konfiguračního souboru s předvyplněným seznamem pro aplikaci.
Pro spojení server–adaptér slouží TLSConfig adaptéru, pro adaptér–API samostatné ZabbixAPITLSConnect. V produkci ověřujte certifikát i hostname; režim required bez ověření certifikátu není totéž jako verify_full. Zálohujte také jeho DataDir se stavem a klíči a před instalací projděte EULA i síťové požadavky.
Párování zařízení
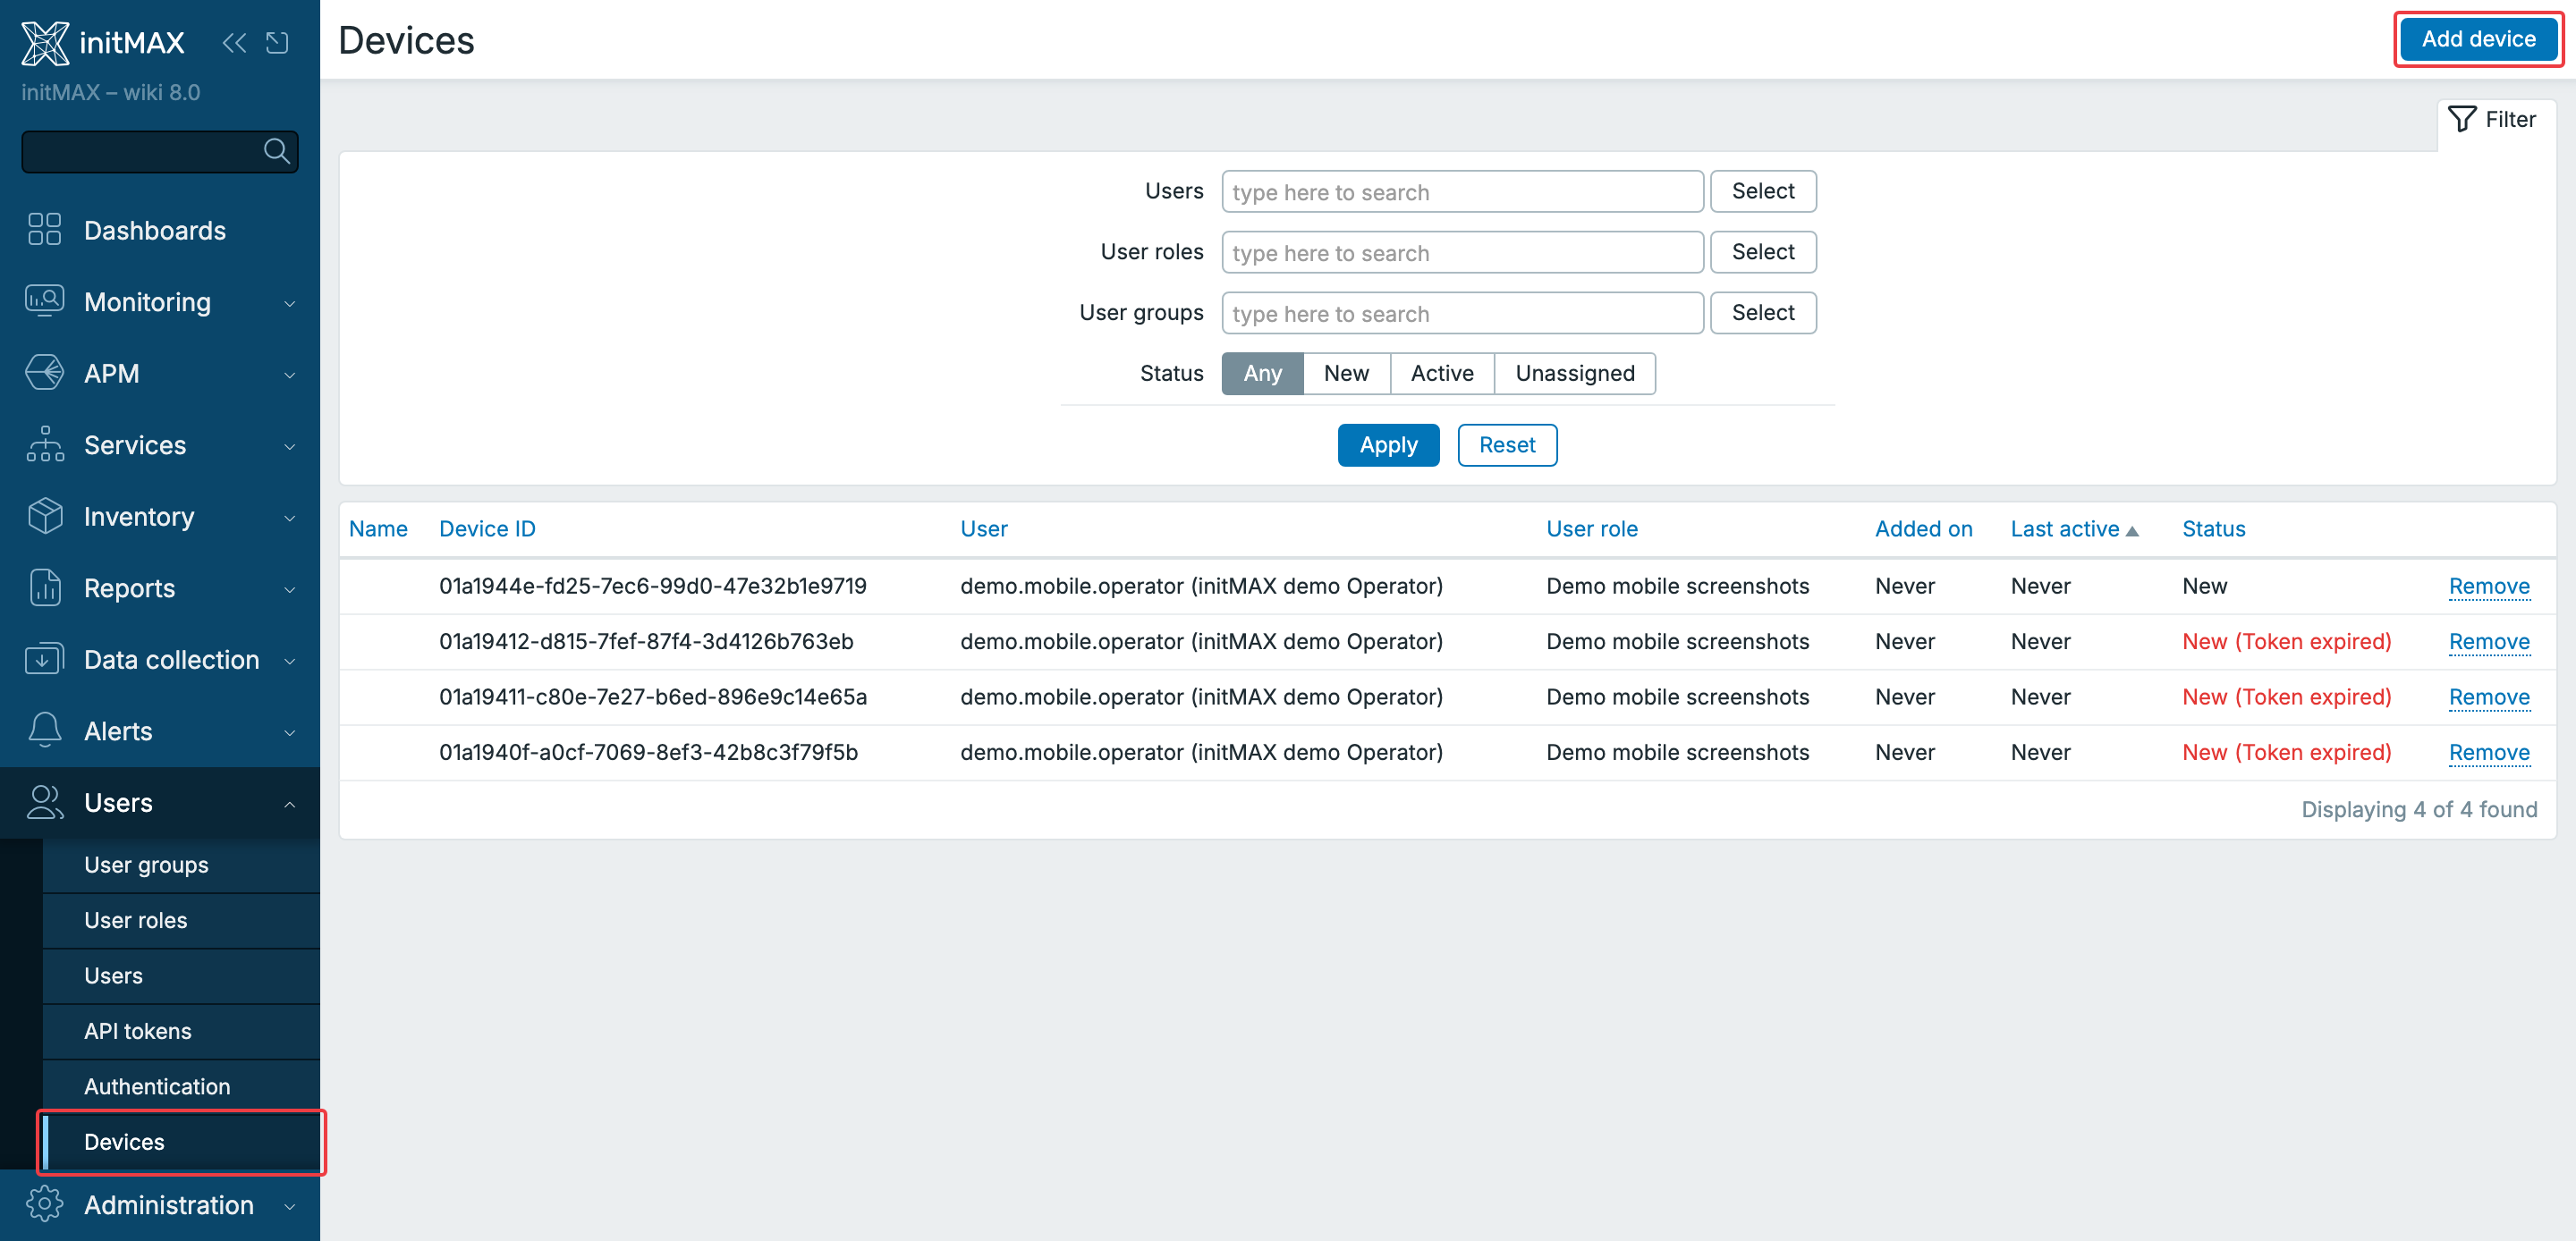
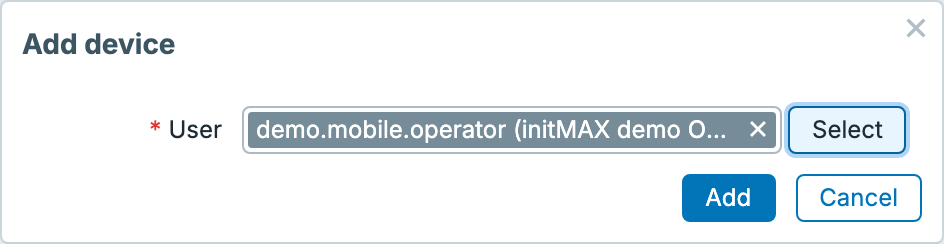
Telefon si přidáme přes User settings > Devices > Add device. S nakonfigurovaným adaptérem se otevře QR kód s platností 10 minut; po naskenování v aplikaci a dokončení párování přejde zařízení do stavu Active. Jako správce můžeme použít také Users > Devices > Add device: nejdřív vybereme uživatele a tlačítkem Add vytvoříme QR kód. Ukázka zachycuje oba kroky. V přehledu na prvním obrázku jsou zařízení čekající na dokončení párování ve stavu New.
V Users > Devices přidáte zařízení tlačítkem Add device.
Vyberte uživatele, ke kterému bude zařízení přiřazené, a potvrďte Add.
QR kód načtěte v oficiální mobilní aplikaci Zabbix; platí 10 minut.
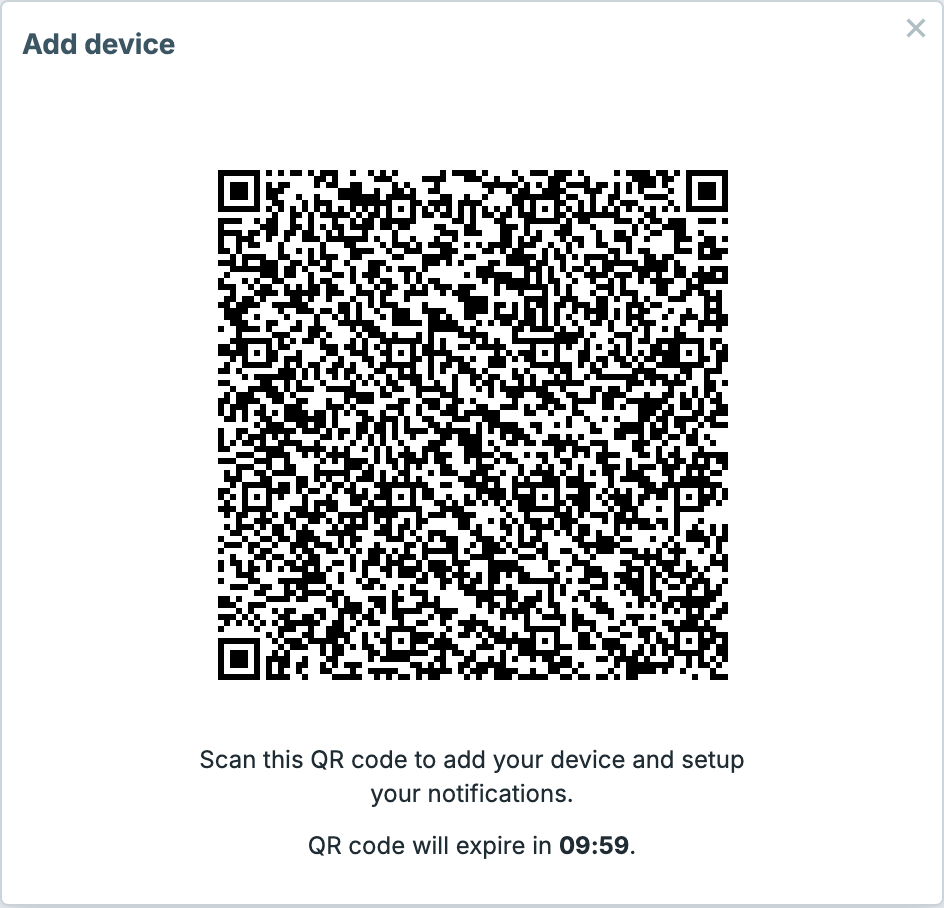
QR kód používá deep link zabbix://v1/link_device. Obsahuje identifikátor a název serveru, ID zařízení, enrollment URL centrálního Zabbix Bridge, dva jednorázové tokeny pro párování a veřejný klíč adaptéru. Nejde o přímou adresu místního adaptéru nebo frontendu, kterou by bylo nutné zpřístupnit telefonu z internetu. Zabbix server ID je viditelné v Reports > System information a rozlišuje jednotlivé Zabbix instalace.
Administrátor má přehled všech zařízení v Users > Devices: název, Device ID, uživatel, role, kdy bylo spárováno a kdy bylo naposledy aktivní. Stavy jsou New (zahájené párování), Active a Unassigned. Zařízení lze filtrovat podle uživatele, role nebo skupiny a odebrat; administrátor může párování zahájit i za jiného uživatele.
Oprávnění
V user roles přibyla samostatná sekce Devices: zapnutí funkce pro roli, akce Manage own devices a Manage user devices a výchozí přístup k nově přidaným akcím. Vedle toho je v UI elementech nová položka Users > Devices. Lze tak například povolit push notifikace všem, ale správu cizích zařízení nechat jen helpdesku.
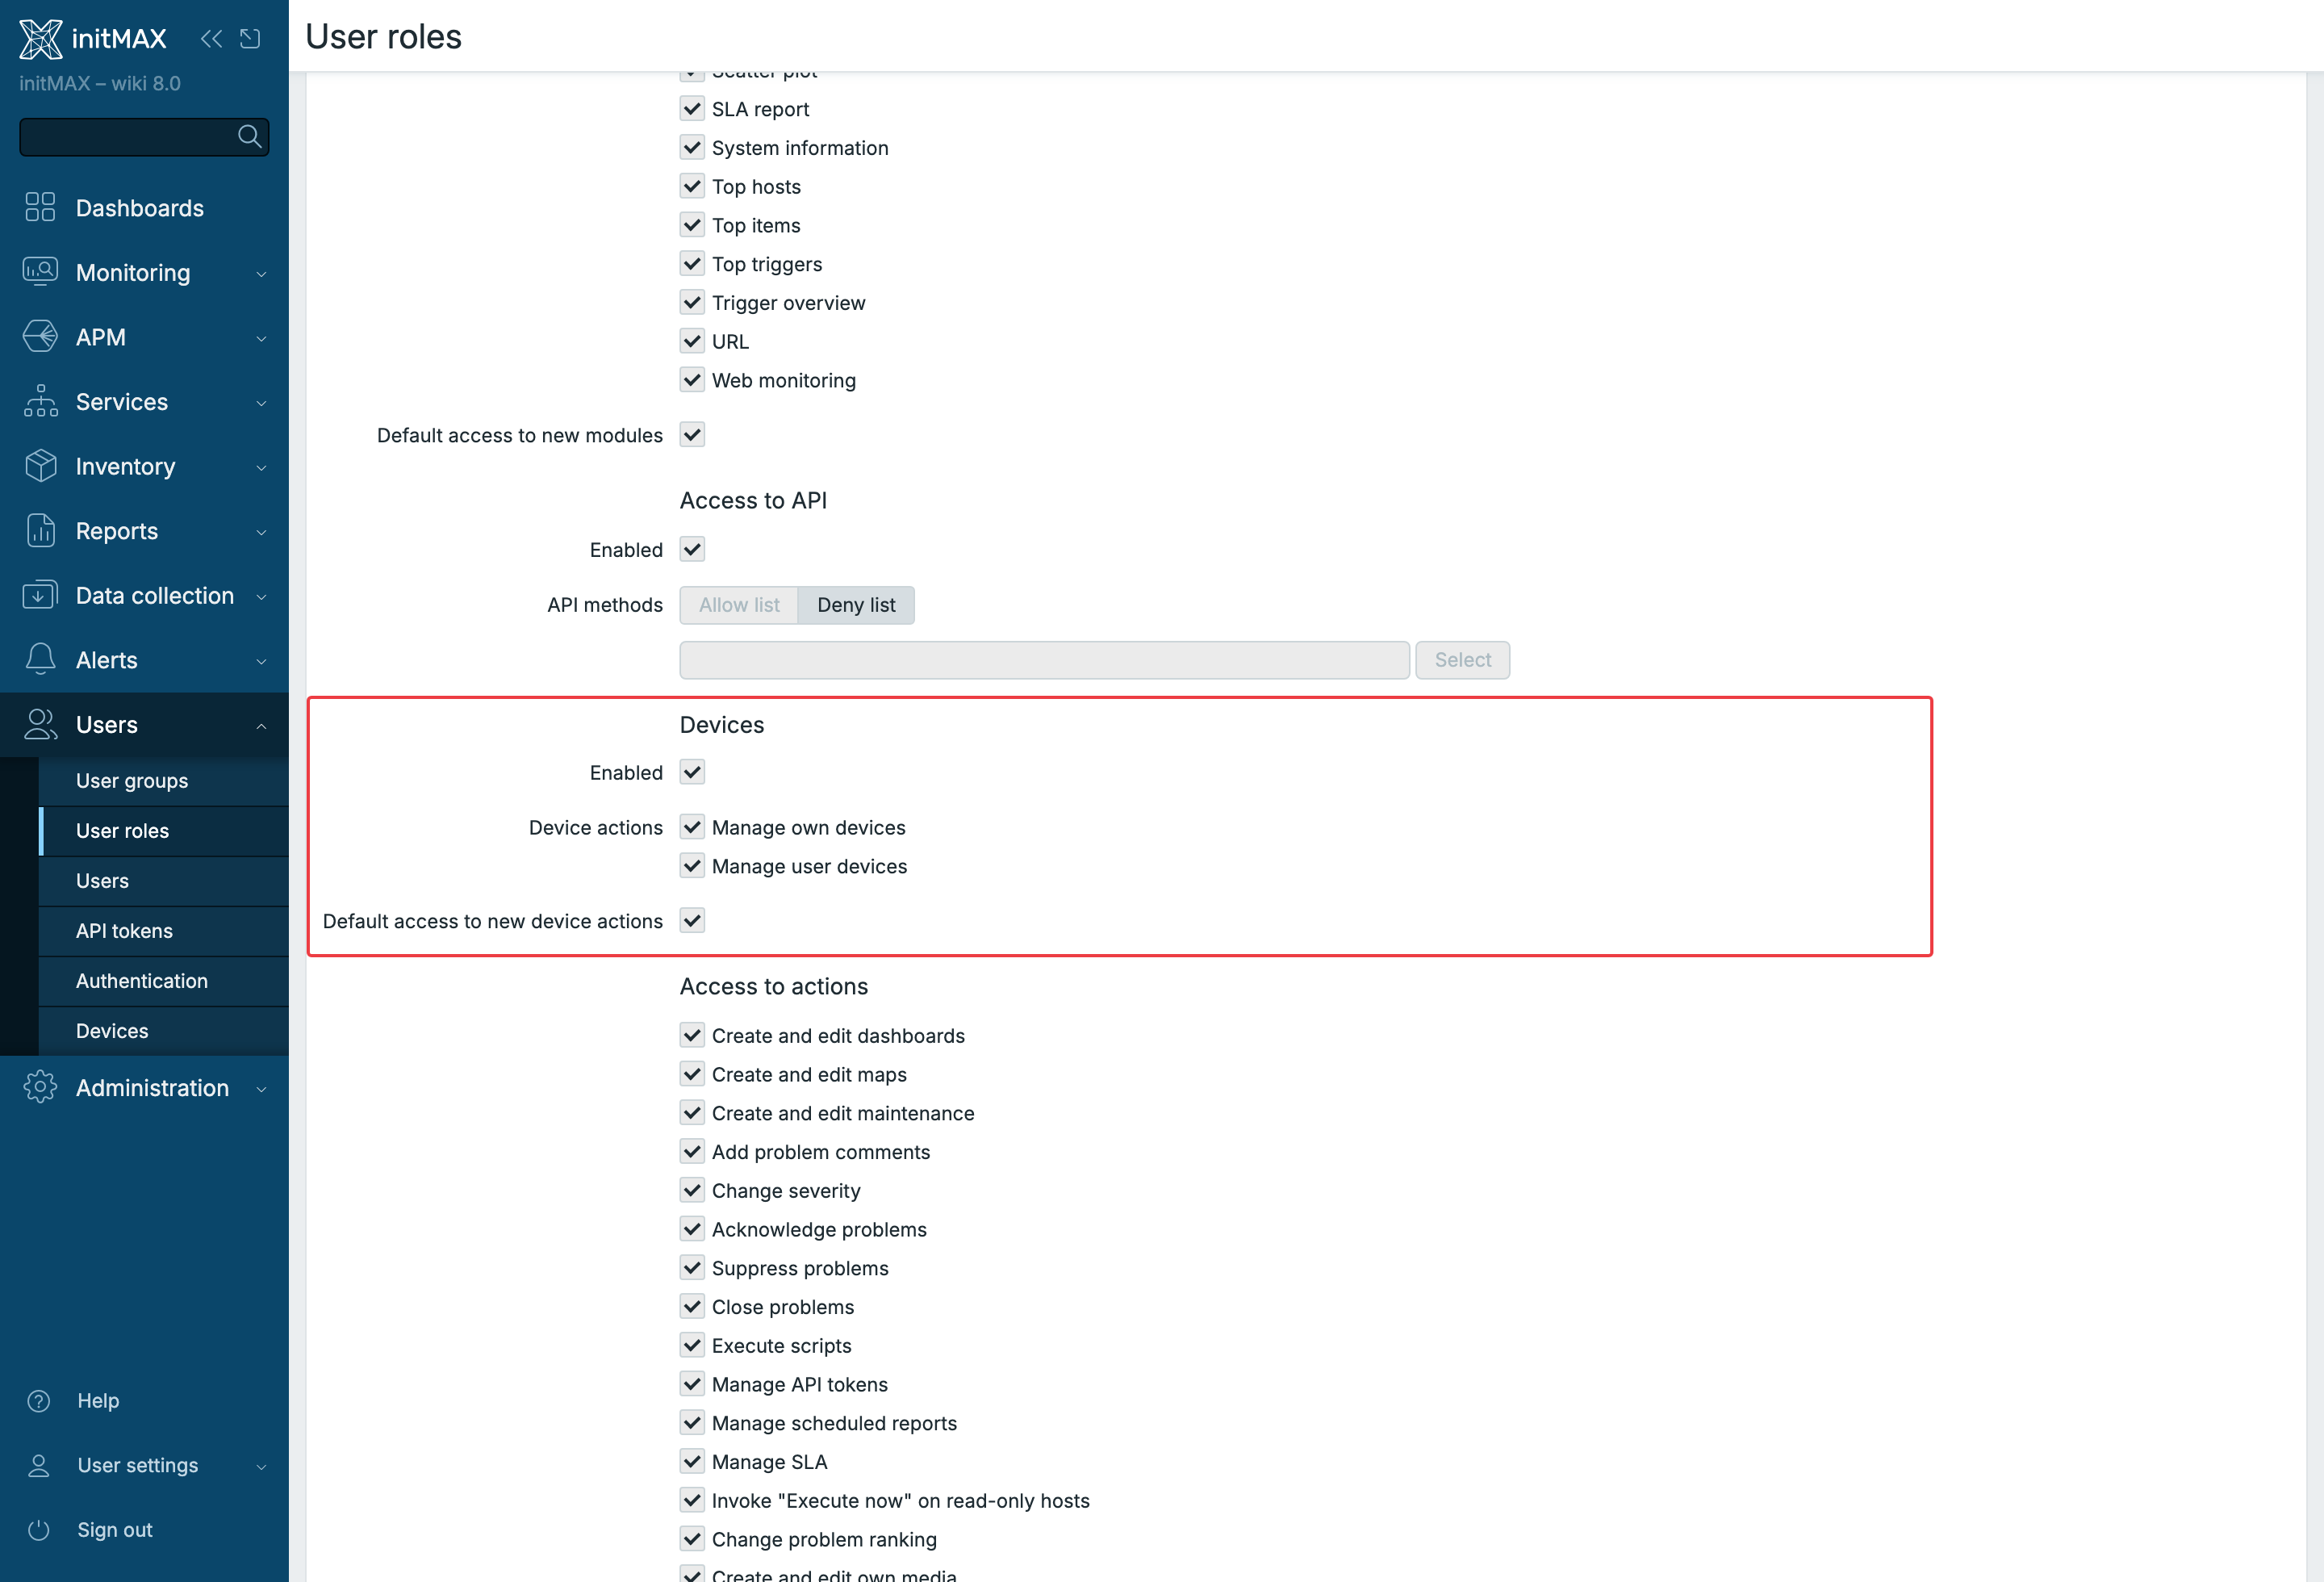
Media type Push
Nový typ media type Push stojí vedle Email, SMS, Script a Webhook. Formulář je minimální: název, typ a popis, k tomu indikátor Bridge adapter connection, který rovnou ukáže, jestli server adapter má nakonfigurovaný. Výchozí šablony zpráv pro problém, recovery a update vypadají například {HOST.NAME} - {EVENT.NAME} a [RESOLVED] {HOST.NAME} - {EVENT.NAME}, makra fungují jako u ostatních typů.
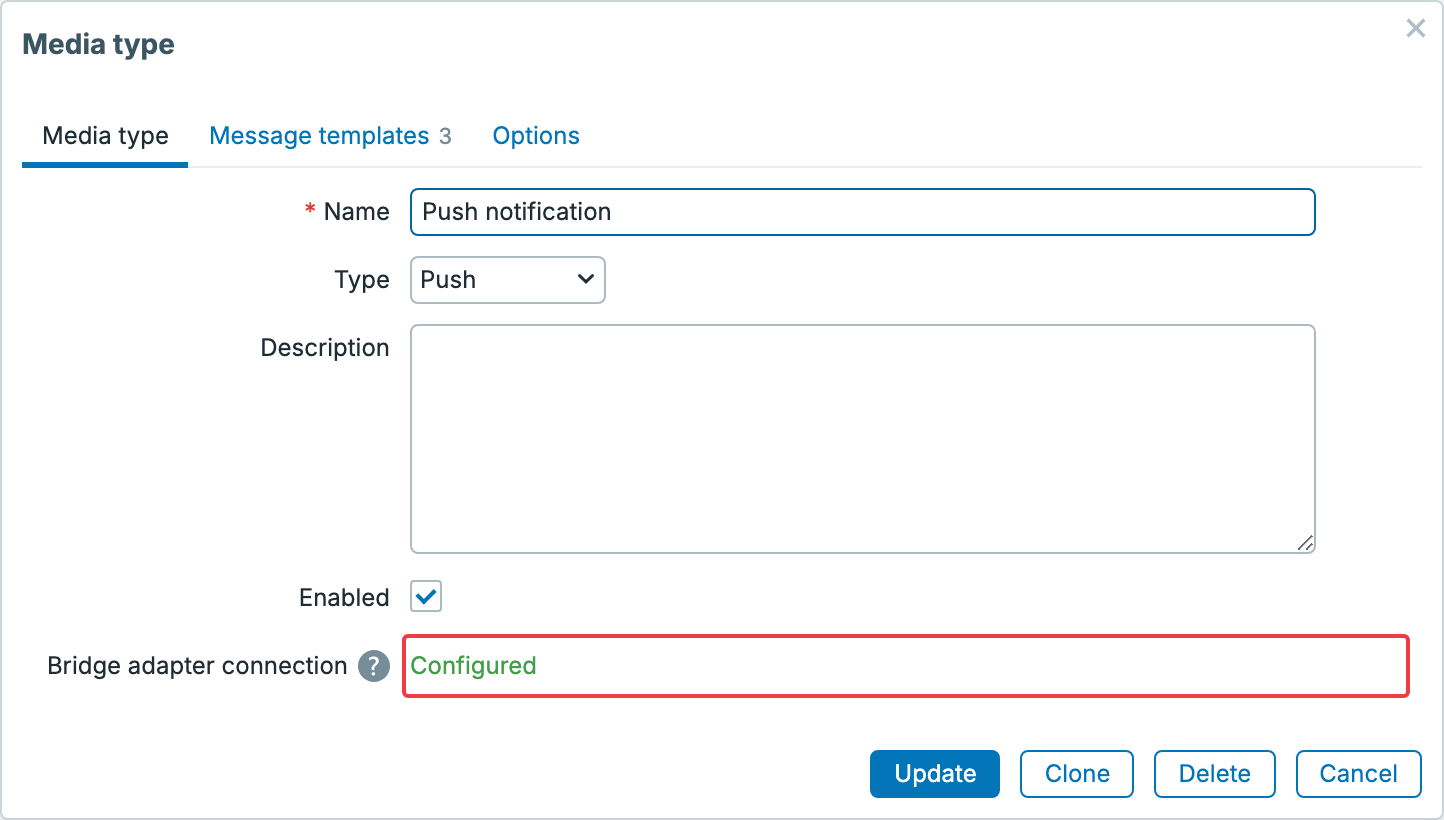
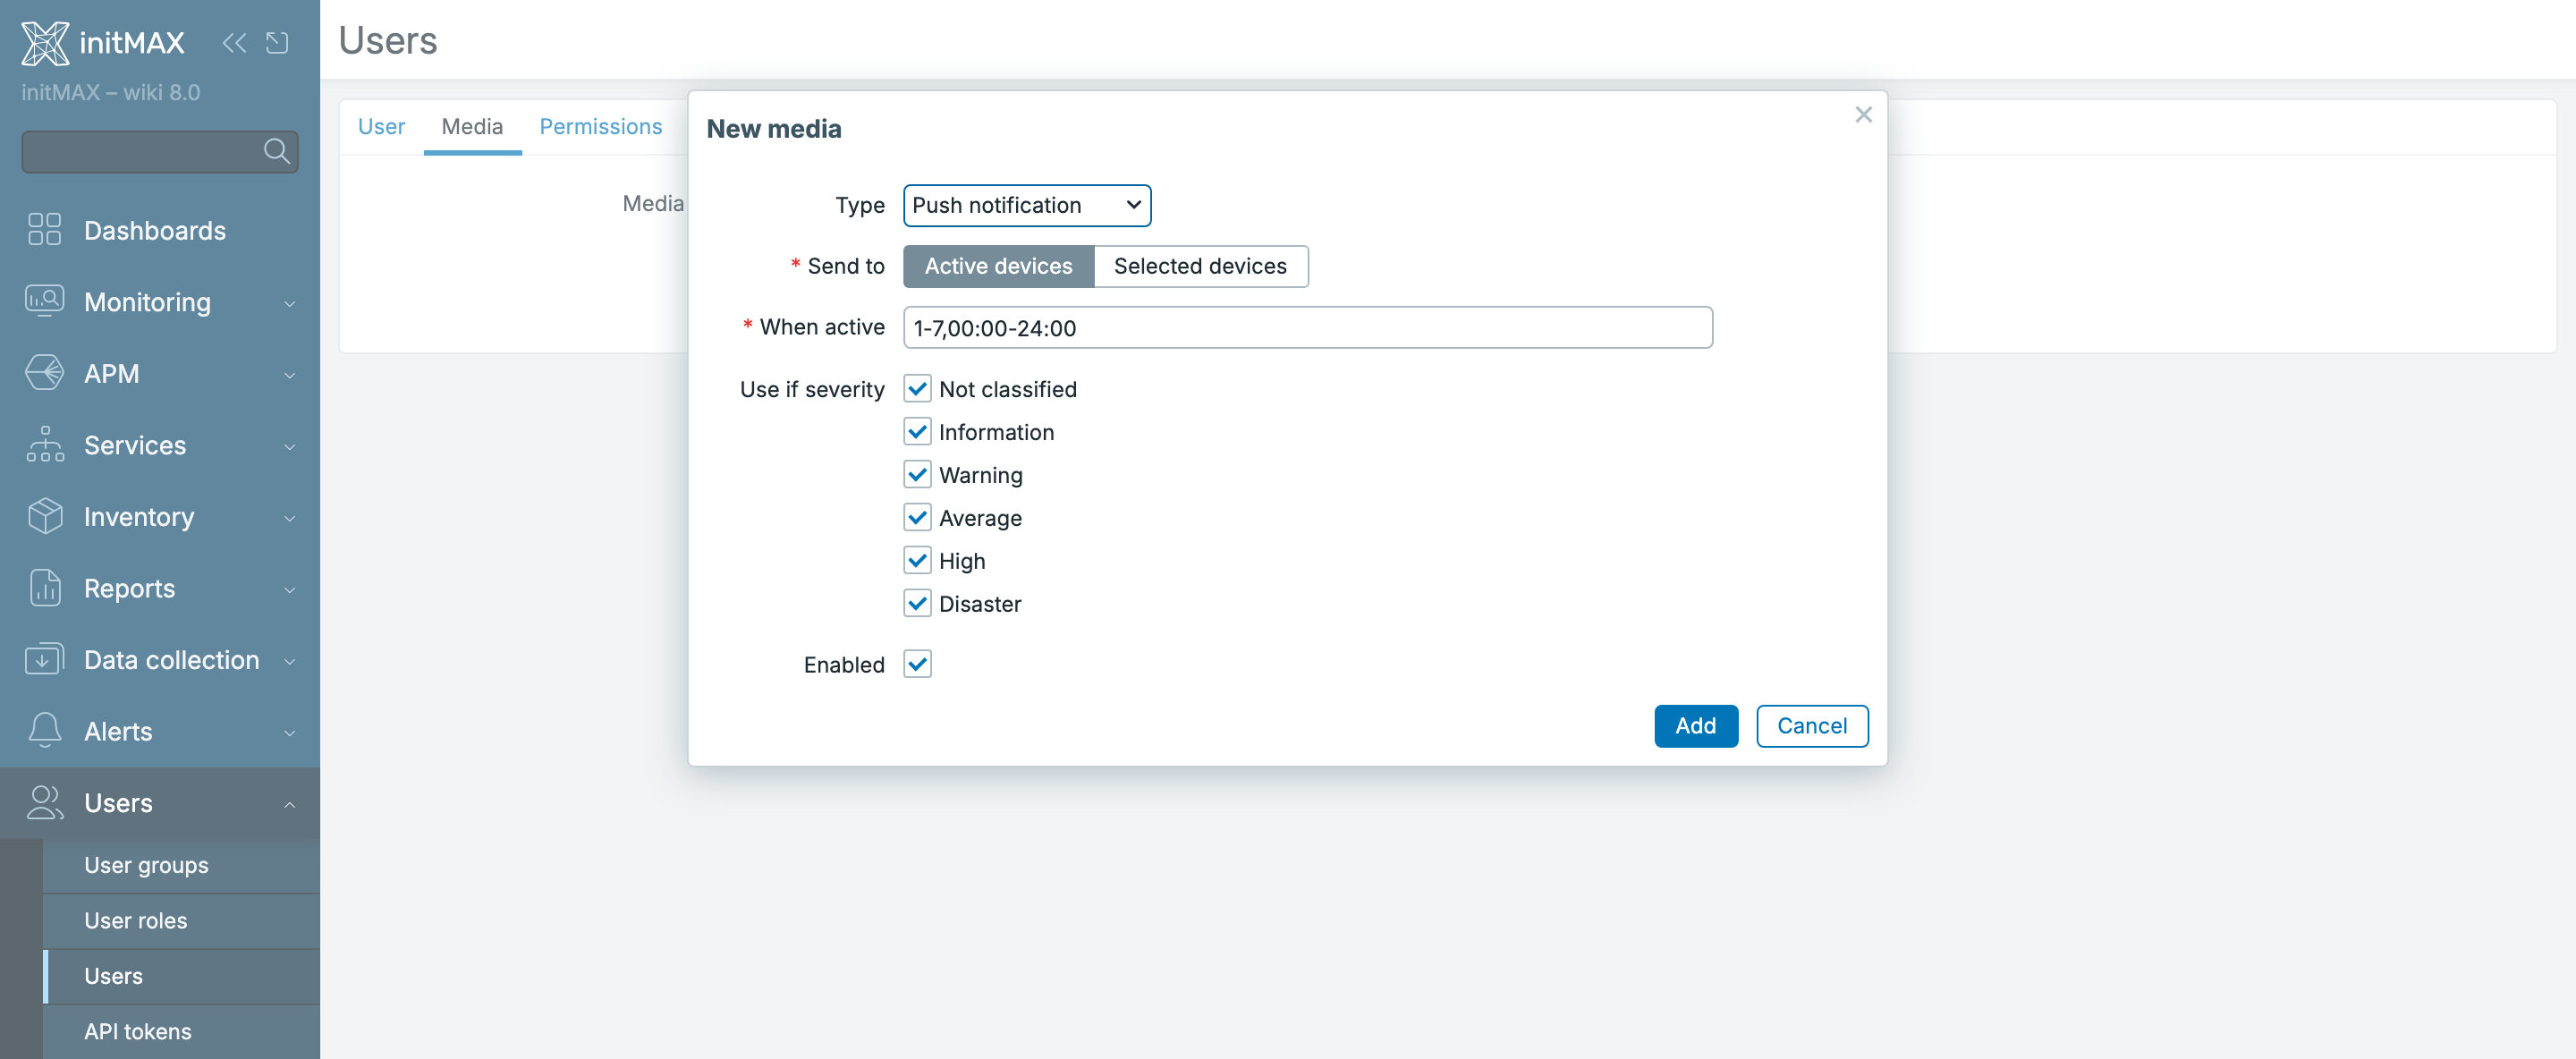
U uživatele se pak médium nastavuje jako obvykle, jen Send to není adresa, ale volba Active devices (všechna aktivní zařízení uživatele) nebo Selected devices. Akce a eskalace se konfigurují stejně jako u jiných media typů, push je jen další krok v eskalaci.
Co to znamená v praxi
Push notifikace využívají mobilní aplikaci a dostupnost Zabbix Bridge i internetového spojení. Zařízení jsou centrálně evidovaná a lze jim odebrat přístup. Při nasazení proto ověřte nejen přidání zařízení, ale i doručení problému, jeho aktualizace a recovery na skutečný telefon. Citlivé údaje neposílejte do textů notifikací bez promyšleného posouzení celé přenosové cesty.
SMS a hlasové upozornění jako nezávislý kanál
Push notifikace potřebují funkční datovou cestu přes internet. Pokud lokalitě se Zabbixem vypadne internetové připojení a nemá záložní cestu, zpráva se z ní k centrálnímu Zabbix Bridge nedostane. Mobilní data na telefonu operátora tento výpadek nevyřeší. Připojený musí být i přijímající telefon; push proto není nezávislý kanál pro hlášení výpadku konektivity.
Pokud bezpečnostní politika nepovoluje přenos monitorovacích dat přes externí službu, je potřeba zvolit jinou notifikační cestu. Mobilní aplikace komunikuje přes centrální Zabbix Bridge mimo vlastní infrastrukturu. Ani šifrování nenahrazuje posouzení toho, jaká data a metadata organizace předává provozovateli služby a za jakých podmínek. Místní adaptér proto sám o sobě neznamená čistě on-premise řešení.
Pro tyto situace lze využít vlastní hardwarovou bránu SMSEagle. Funkční Zabbix jí předá upozornění v lokální síti a SMS nebo hlasový hovor pak odchází přes SIM a mobilní síť, bez internetového připojení, Zabbix Bridge a cloudové SMS brány. Hodí se tak i do uzavřených sítí bez přístupu na internet, pokud jejich bezpečnostní politika dovoluje komunikaci přes mobilního operátora. Brána potřebuje napájení, signál, aktivní SIM a dostupné lokální spojení se Zabbixem; nevyřeší výpadek samotného serveru nebo celé LAN.
SMS není end-to-end šifrovaný kanál a její obsah stále zpracovává mobilní operátor. Do zprávy proto patří jen nezbytné údaje. Možnosti nasazení, modely a ceny najdete v našem přehledu SMSEagle.
Jako oficiální partner SMSEagle vám pomůžeme s výběrem brány, nasazením, integrací i servisní podporou. Připravili jsme také vlastní integraci Zabbixu pro SMS a hlasová upozornění. Najdete ji včetně návodu na našem GitHubu.
Nový vzhled: téma Dark blue, písmo Inter a zaoblené rozhraní
Zabbix 8.0 je první verze po dlouhé době, která mění nejen funkce, ale i to, jak rozhraní vypadá. Změny jsou tři: nové barevné téma Dark blue, nové písmo vložené přímo do frontendu a modernizované komponenty se zaoblenými rohy a lepší přístupností. Nic z toho nemění rozložení stránek, administrátor se orientuje stejně jako v 7.x.
Téma Dark blue
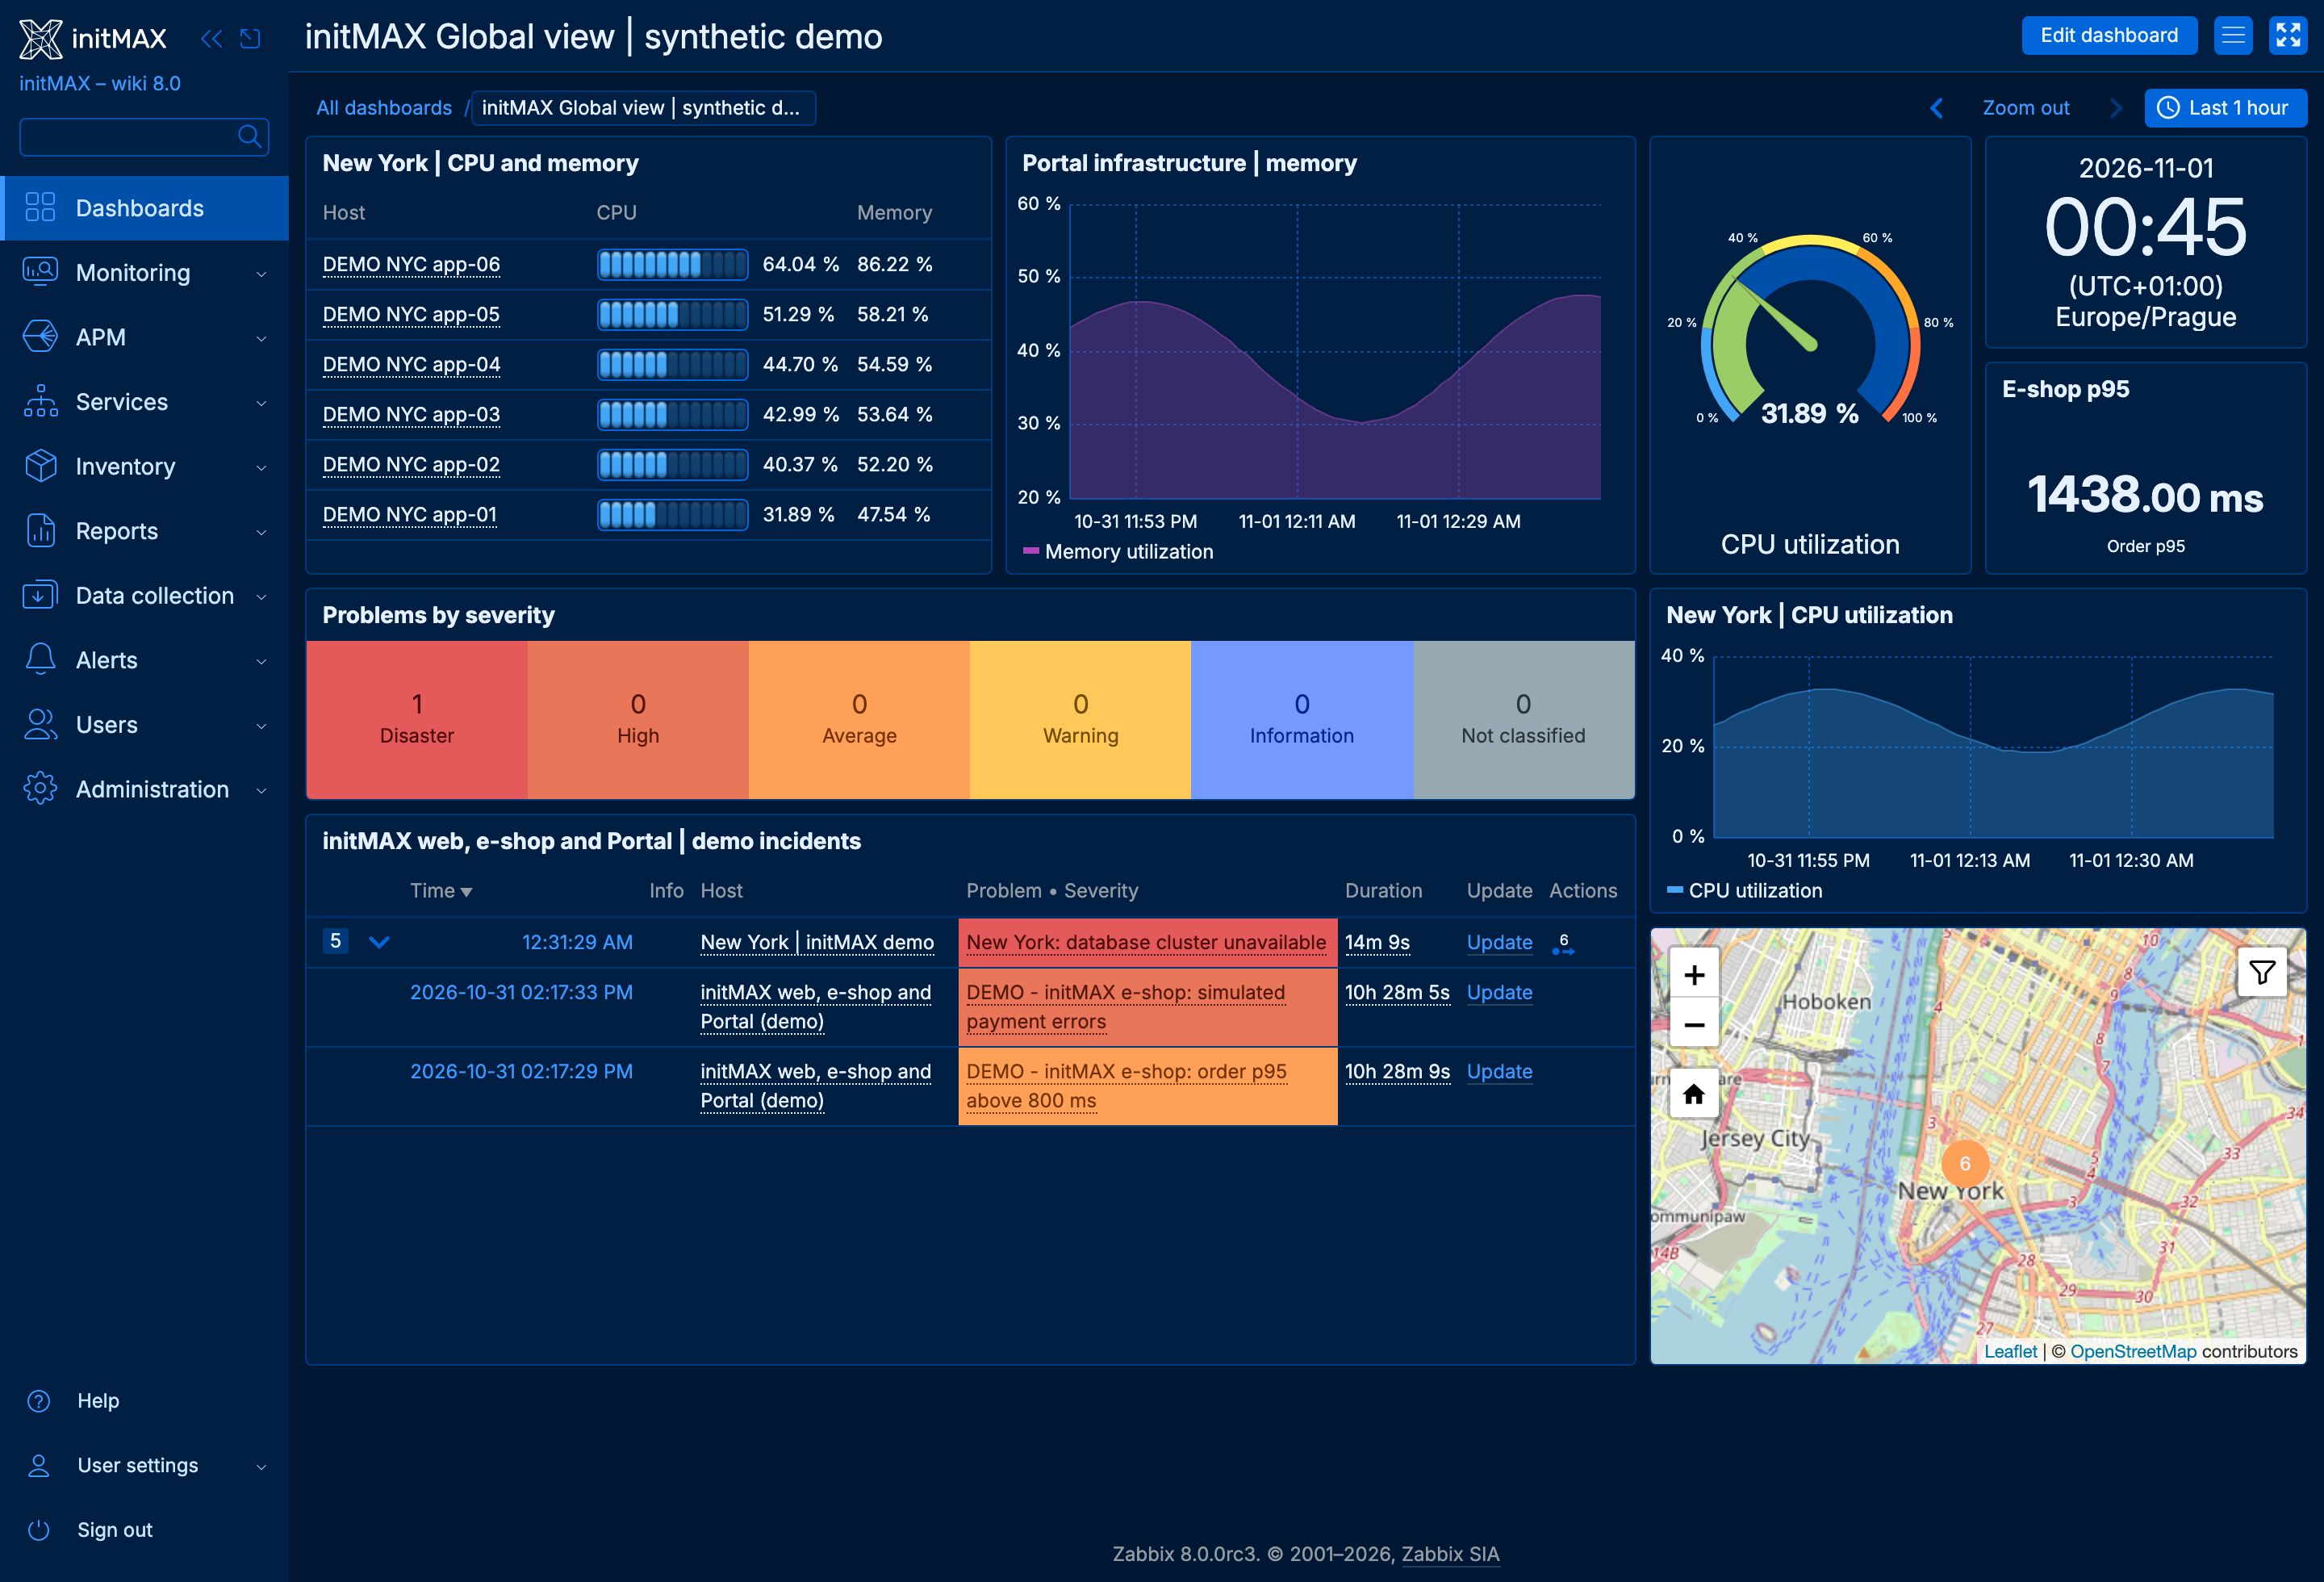
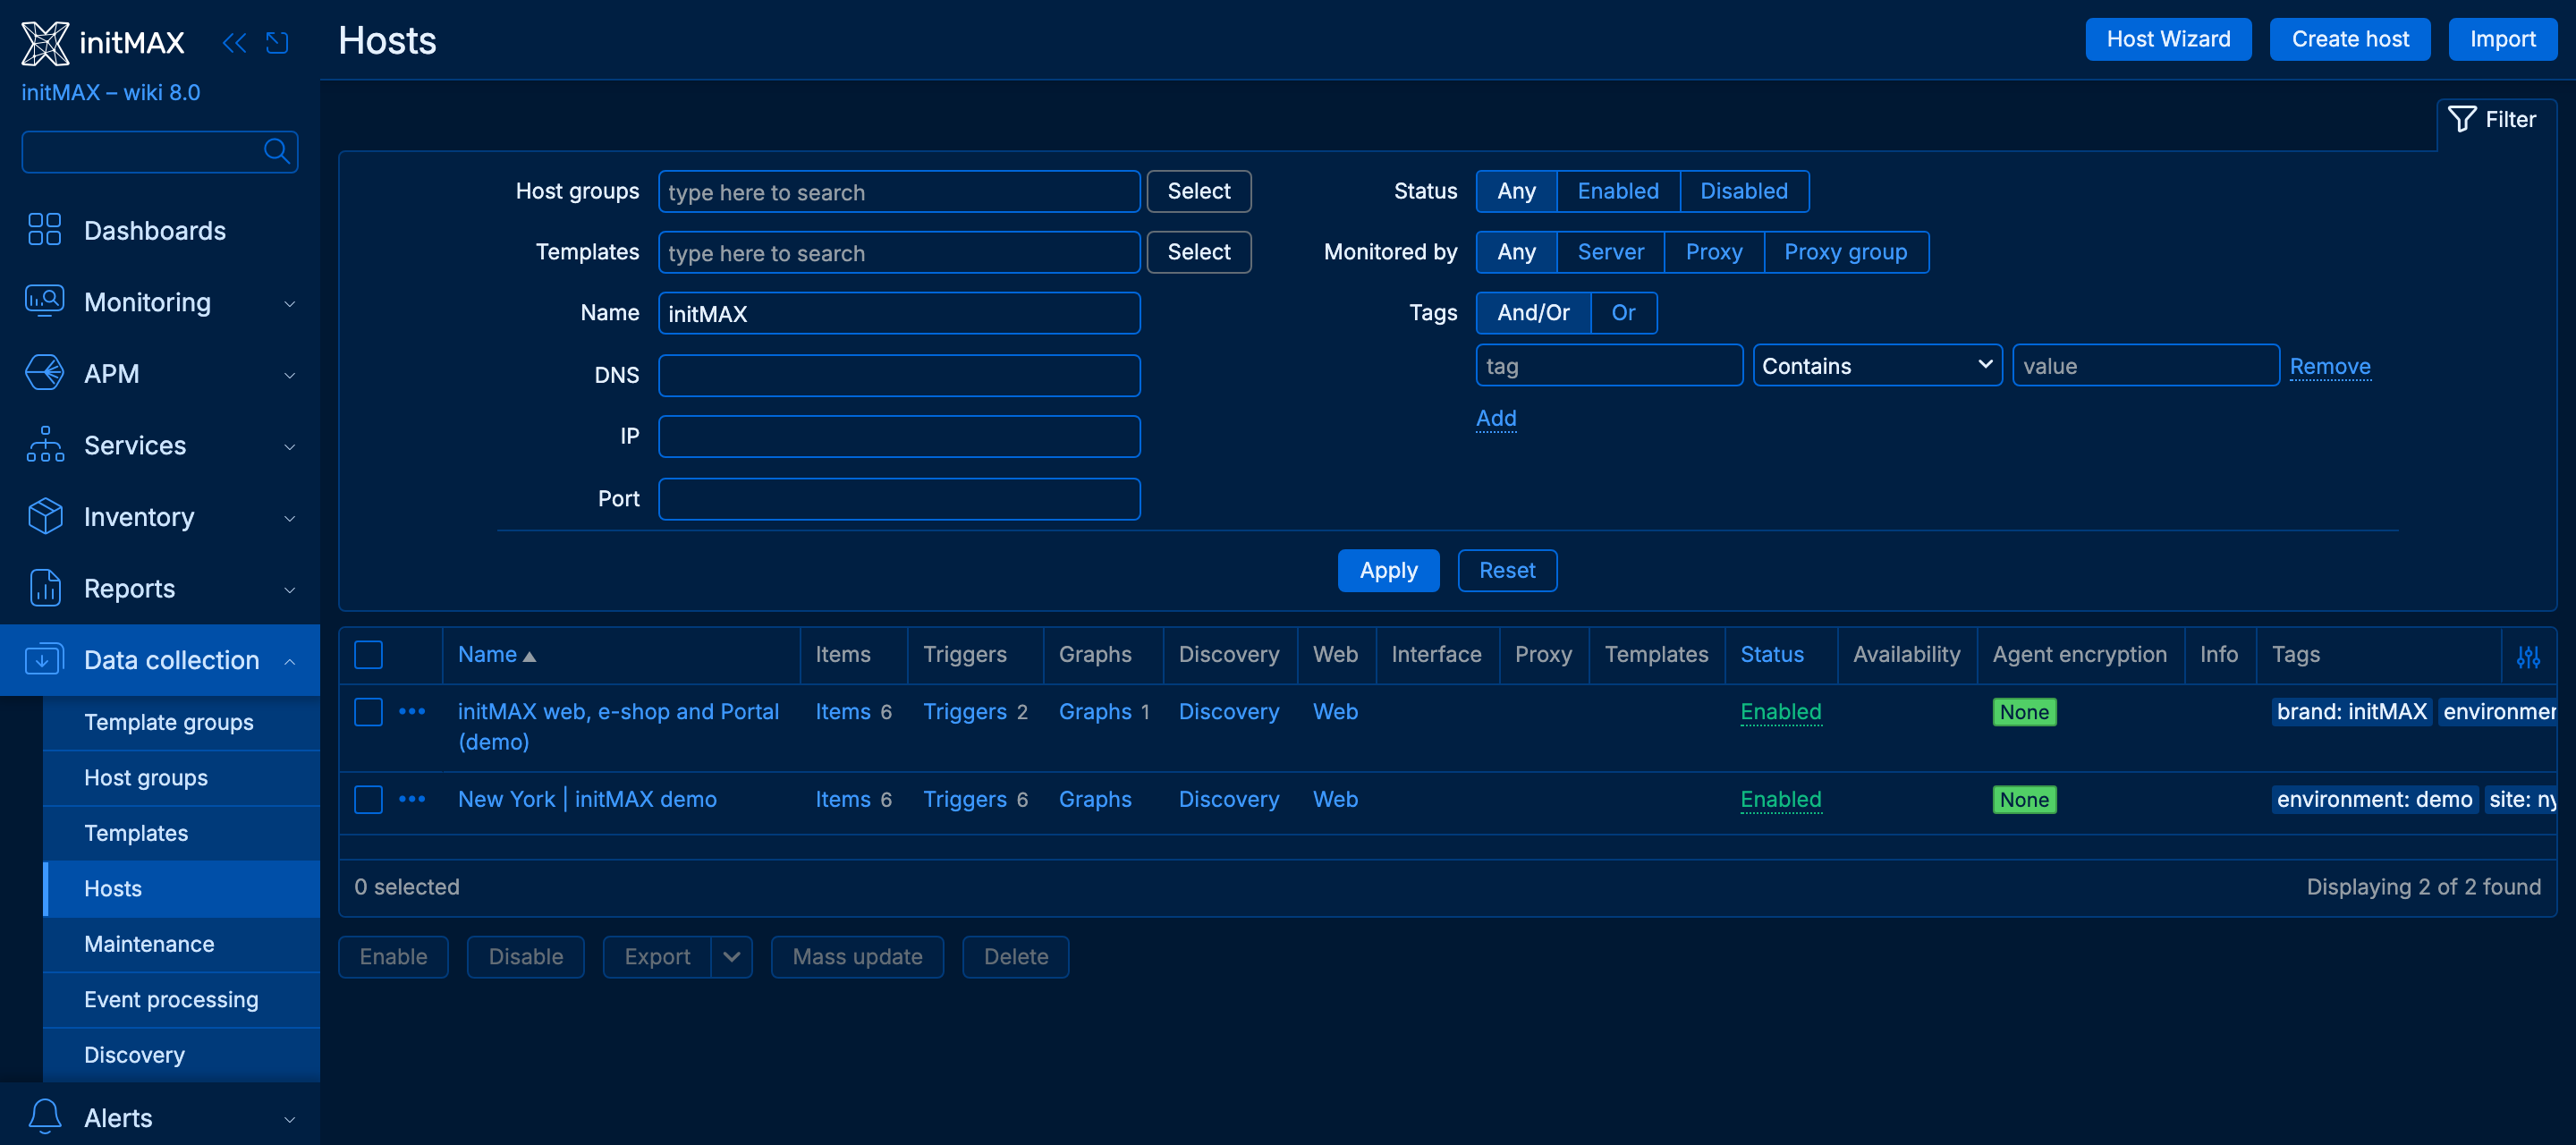
Vedle stávajícího Dark přibývá Dark blue: tmavě modrý podklad (#001F42), modré akcenty (#004FA8) a světlý text, navržené tak, aby na velkých obrazovkách v dohledovém centru neoslňovalo, ale zůstalo čitelnější než čistě černé téma. Má vlastní paletu i pro klasické grafy, takže barvy křivek sedí s pozadím.
Vlastní písmo místo systémového
Frontend nově nese vlastní písmo Inter (variabilní font, včetně kurzívy) a pro japonštinu, korejštinu, čínštinu, gruzínštinu a hebrejštinu Noto Sans. Zabbix tak vypadá stejně na Windows, macOS i Linuxu a nezávisí na tom, jaké fonty má prohlížeč k dispozici. Spolu s tím prošly úpravou formuláře, kde delší texty dřív přetékaly (grafový widget, preprocessing, setup wizard).
Kdo chce zůstat u původního vzhledu, má k dispozici témata Blue (classic) a Dark (classic) s dosavadní sadou písem. Seznam témat je tedy: Blue, Blue (classic), Dark, Dark (classic), High-contrast light, High-contrast dark a nově Dark blue.
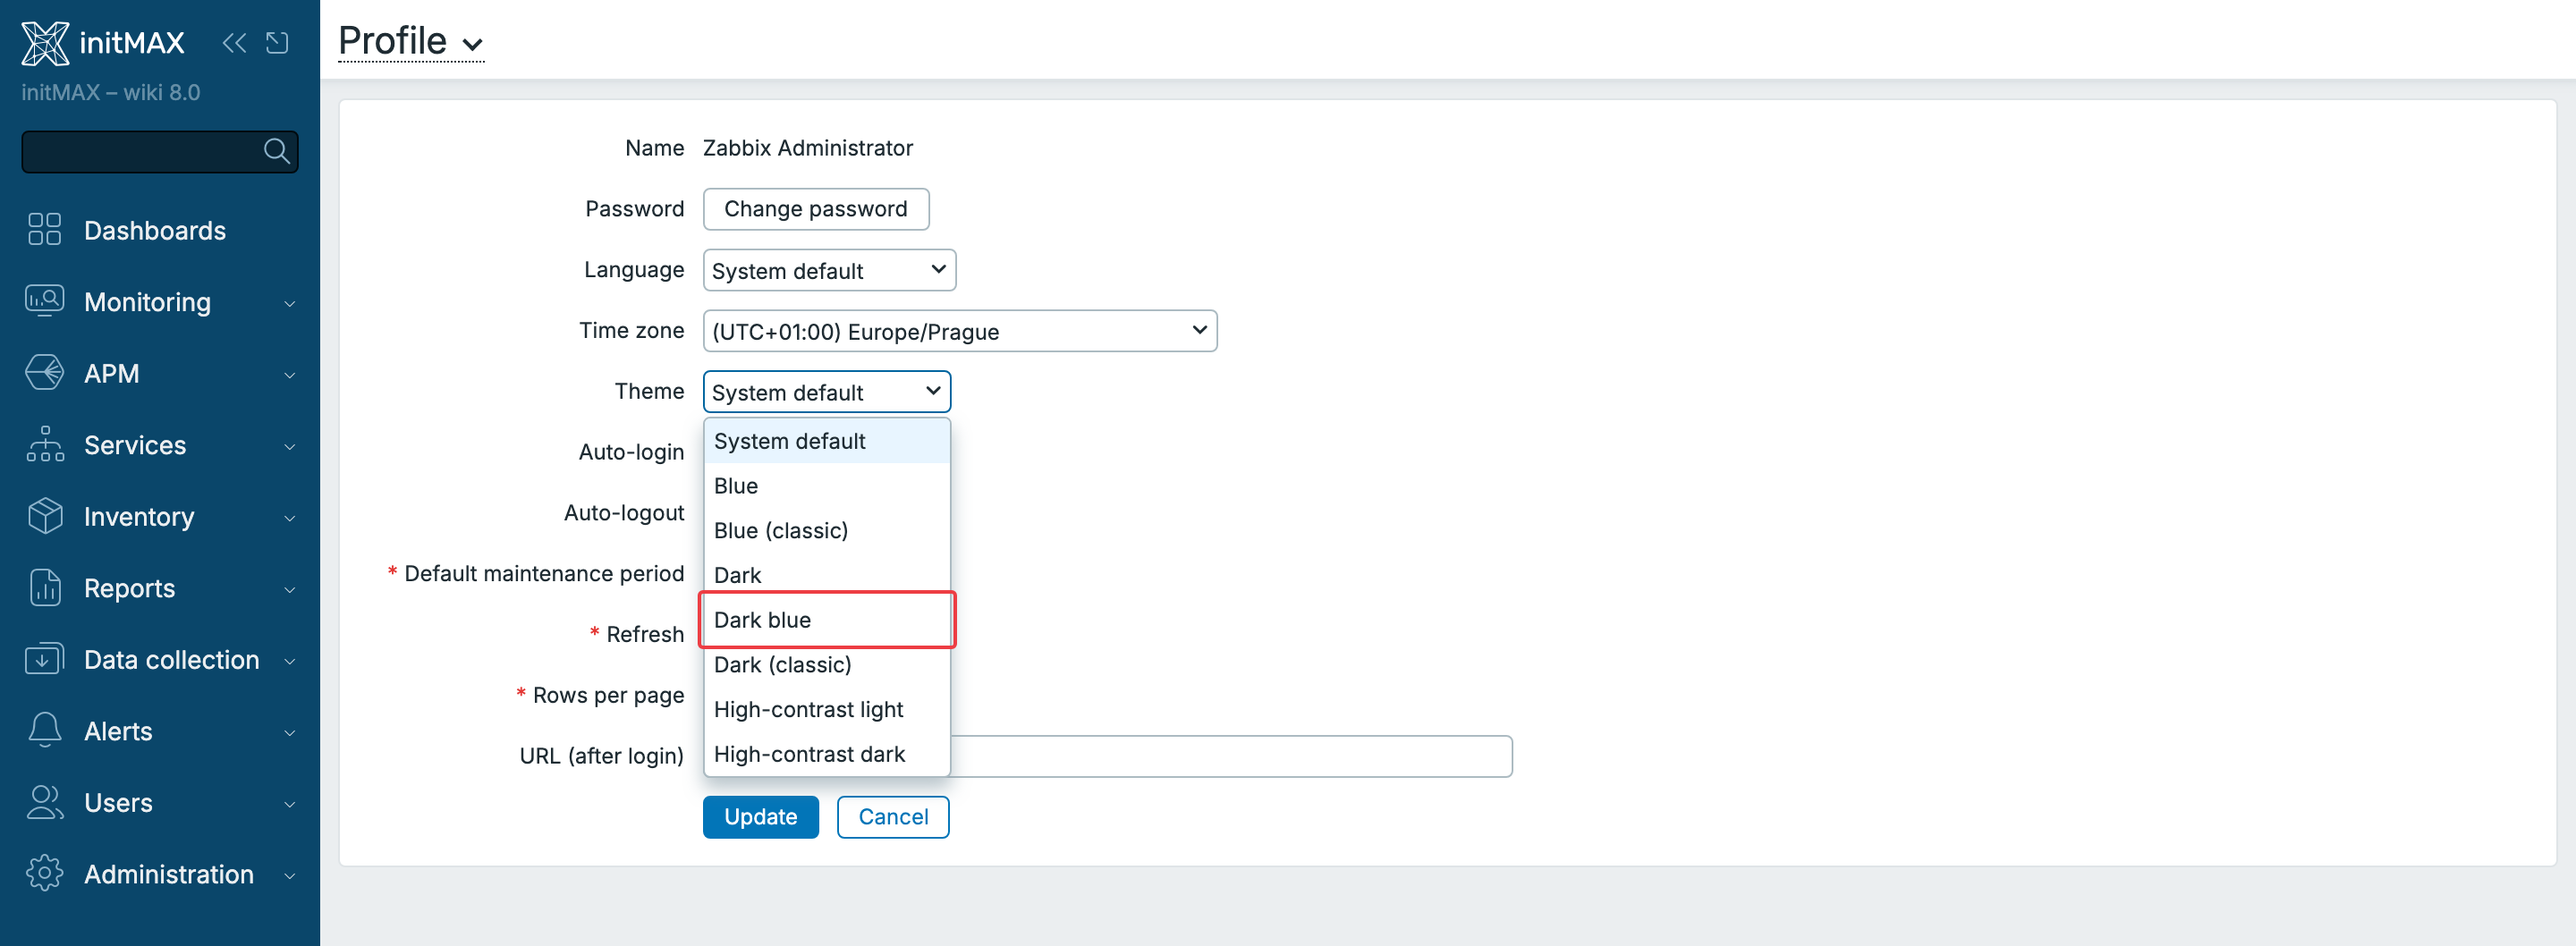
Modernizované rozhraní
Vstupní pole, tlačítka, tabulky, filtry, záložky i dashboardové widgety dostaly jednotné zaoblení rohů a upravené okraje. Na první pohled drobnost, v součtu ale rozhraní působí lehčeji a jednotněji. Srovnání stejné obrazovky v 7.4 a 8.0:
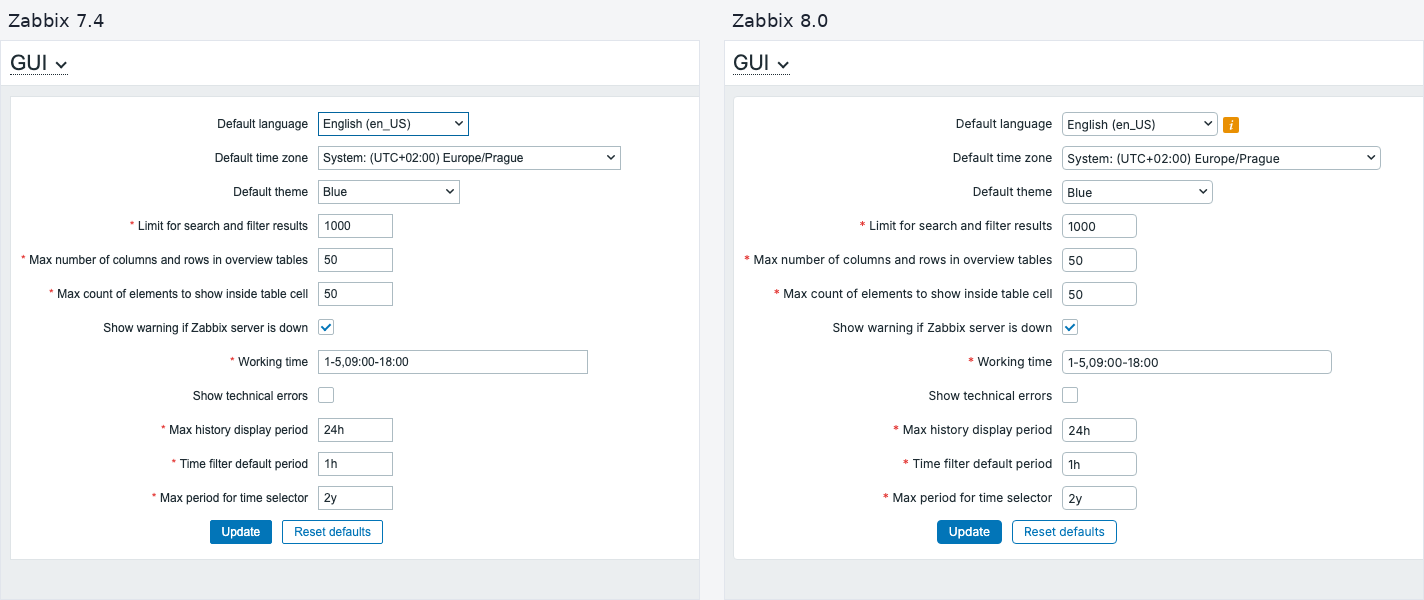
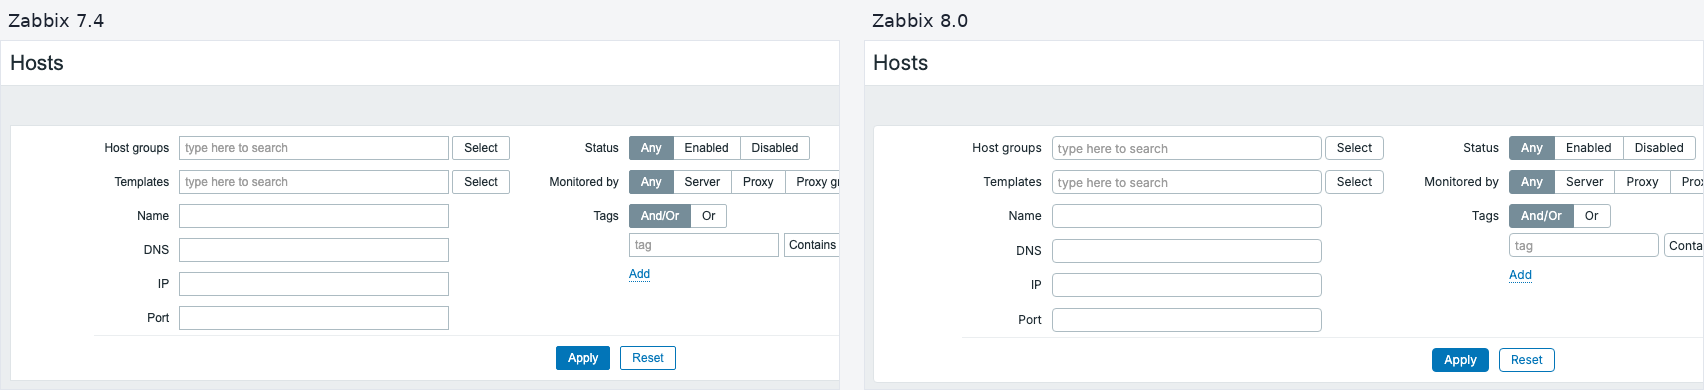
Druhá část modernizace je přístupnost: odkaz Skip to main content pro ovládání z klávesnice (objeví se po stisku Tab), lepší zvýraznění fokusu a opravené kontrasty. Vybraná textová pole se navíc automaticky zvětšují podle obsahu (názvy, výrazy, popisy), takže se dlouhé hodnoty nemusí procházet v jednořádkovém políčku.
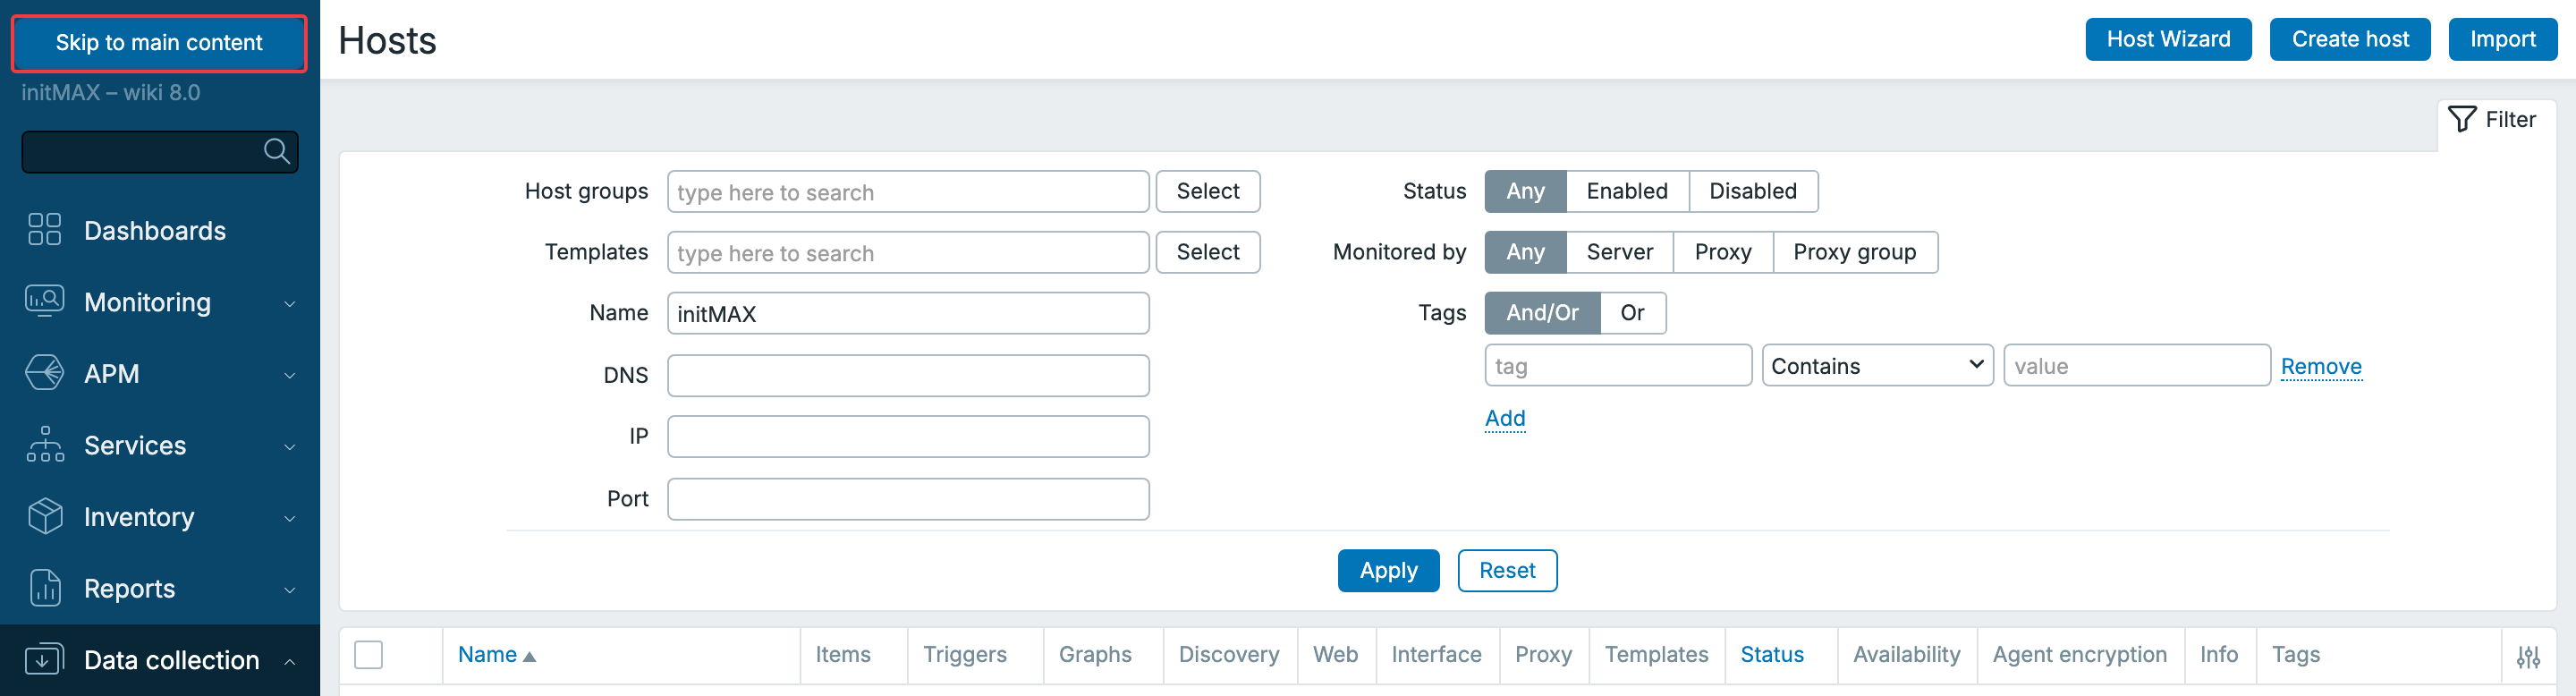
Drobnosti, které s tím souvisí: tooltipy a hintboxy jdou přetáhnout myší jinam, když překrývají to, co potřebujete vidět; automatické spouštění slideshow dashboardů je nově vypnuté a ovládá se parametrem v URL; a většina konfiguračních formulářů běží v modálních oknech s inline validací, takže chyba se ukáže rovnou u pole, ne až po uložení.
Co to znamená v praxi
Pro uživatele je to hlavně jistota, že Zabbix vypadá všude stejně a že se s ním dá pohodlně pracovat i z klávesnice. Pro firmy, které mají vlastní branding frontendu (logo, barvy přes brand.conf.php), se nic nemění, mechanismus zůstává. Pokud máte vlastní moduly nebo widgety s vlastním CSS, počítejte s kontrolou na nových tématech, hlavně na Dark blue a classic variantách.
Bezpečnost a řízení: Vault AppRole, feature flags, API vypnuté ve výchozím stavu
Zabbix 8.0 přináší několik změn, které nejsou vidět na dashboardu, ale zajímají každého, kdo Zabbix provozuje pro víc týmů nebo zákazníků: bezpečnější výchozí nastavení (API vypnuté v rolích, žádné staré protokoly na trapperu), lepší práci se secrets (HashiCorp Vault AppRole) a nástroje, jak instalaci osekat na to, co administrátor opravdu chce povolit (feature flags, regulární výrazy pro klíče agentů, omezení uživatelů na konkrétní proxy).
HashiCorp Vault: AppRole místo tokenu
Přihlášení do HashiCorp Vaultu dosud vyžadovalo statický token v konfiguraci serveru i frontendu. 8.0 přidává AppRole: server dostane VaultAppRoleID a VaultAppSecretID, frontend $DB['VAULT_APP_ROLE_ID'] a $DB['VAULT_APP_SECRET_ID'], a token si vyžádá sám. Pro bezpečnostní tým to znamená standardní způsob, jak Zabbixu vydat identitu s omezenou politikou a rotovat secret ID, místo dlouhodobě platného tokenu v souboru.
### zabbix_server.conf
Vault=HashiCorp
VaultURL=https://vault.example.com:8200
VaultDBPath=secret/zabbix/db
VaultAppRoleID=8a1c2f7e-0b3d-4c5e-9f10-1a2b3c4d5e6f
VaultAppSecretID=...
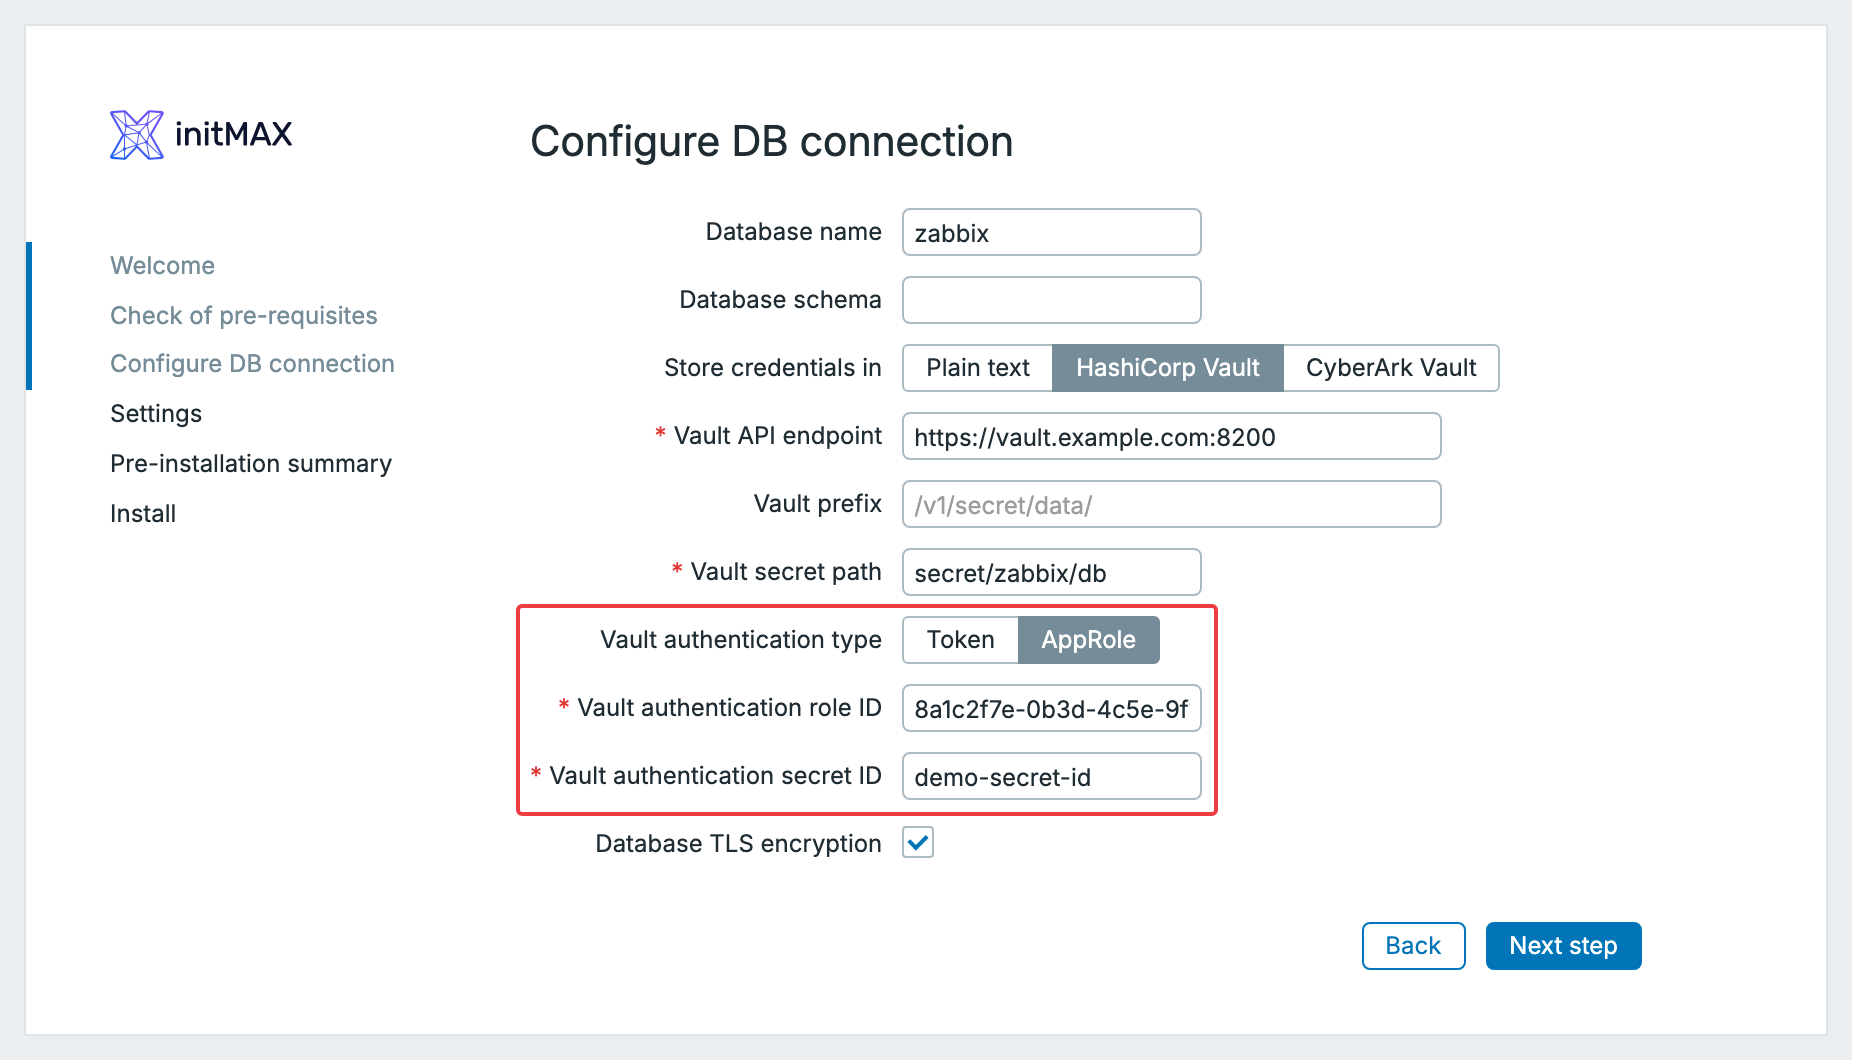
V instalačním průvodci frontendu je v kroku Configure DB connection nový přepínač Vault authentication type: Token / AppRole. AppRole lze využít také pro načtení hesla k ClickHouse z Vaultu v konfiguraci serveru nebo proxy pomocí vault_path= v TelemetryProvider.
API vypnuté ve výchozím stavu
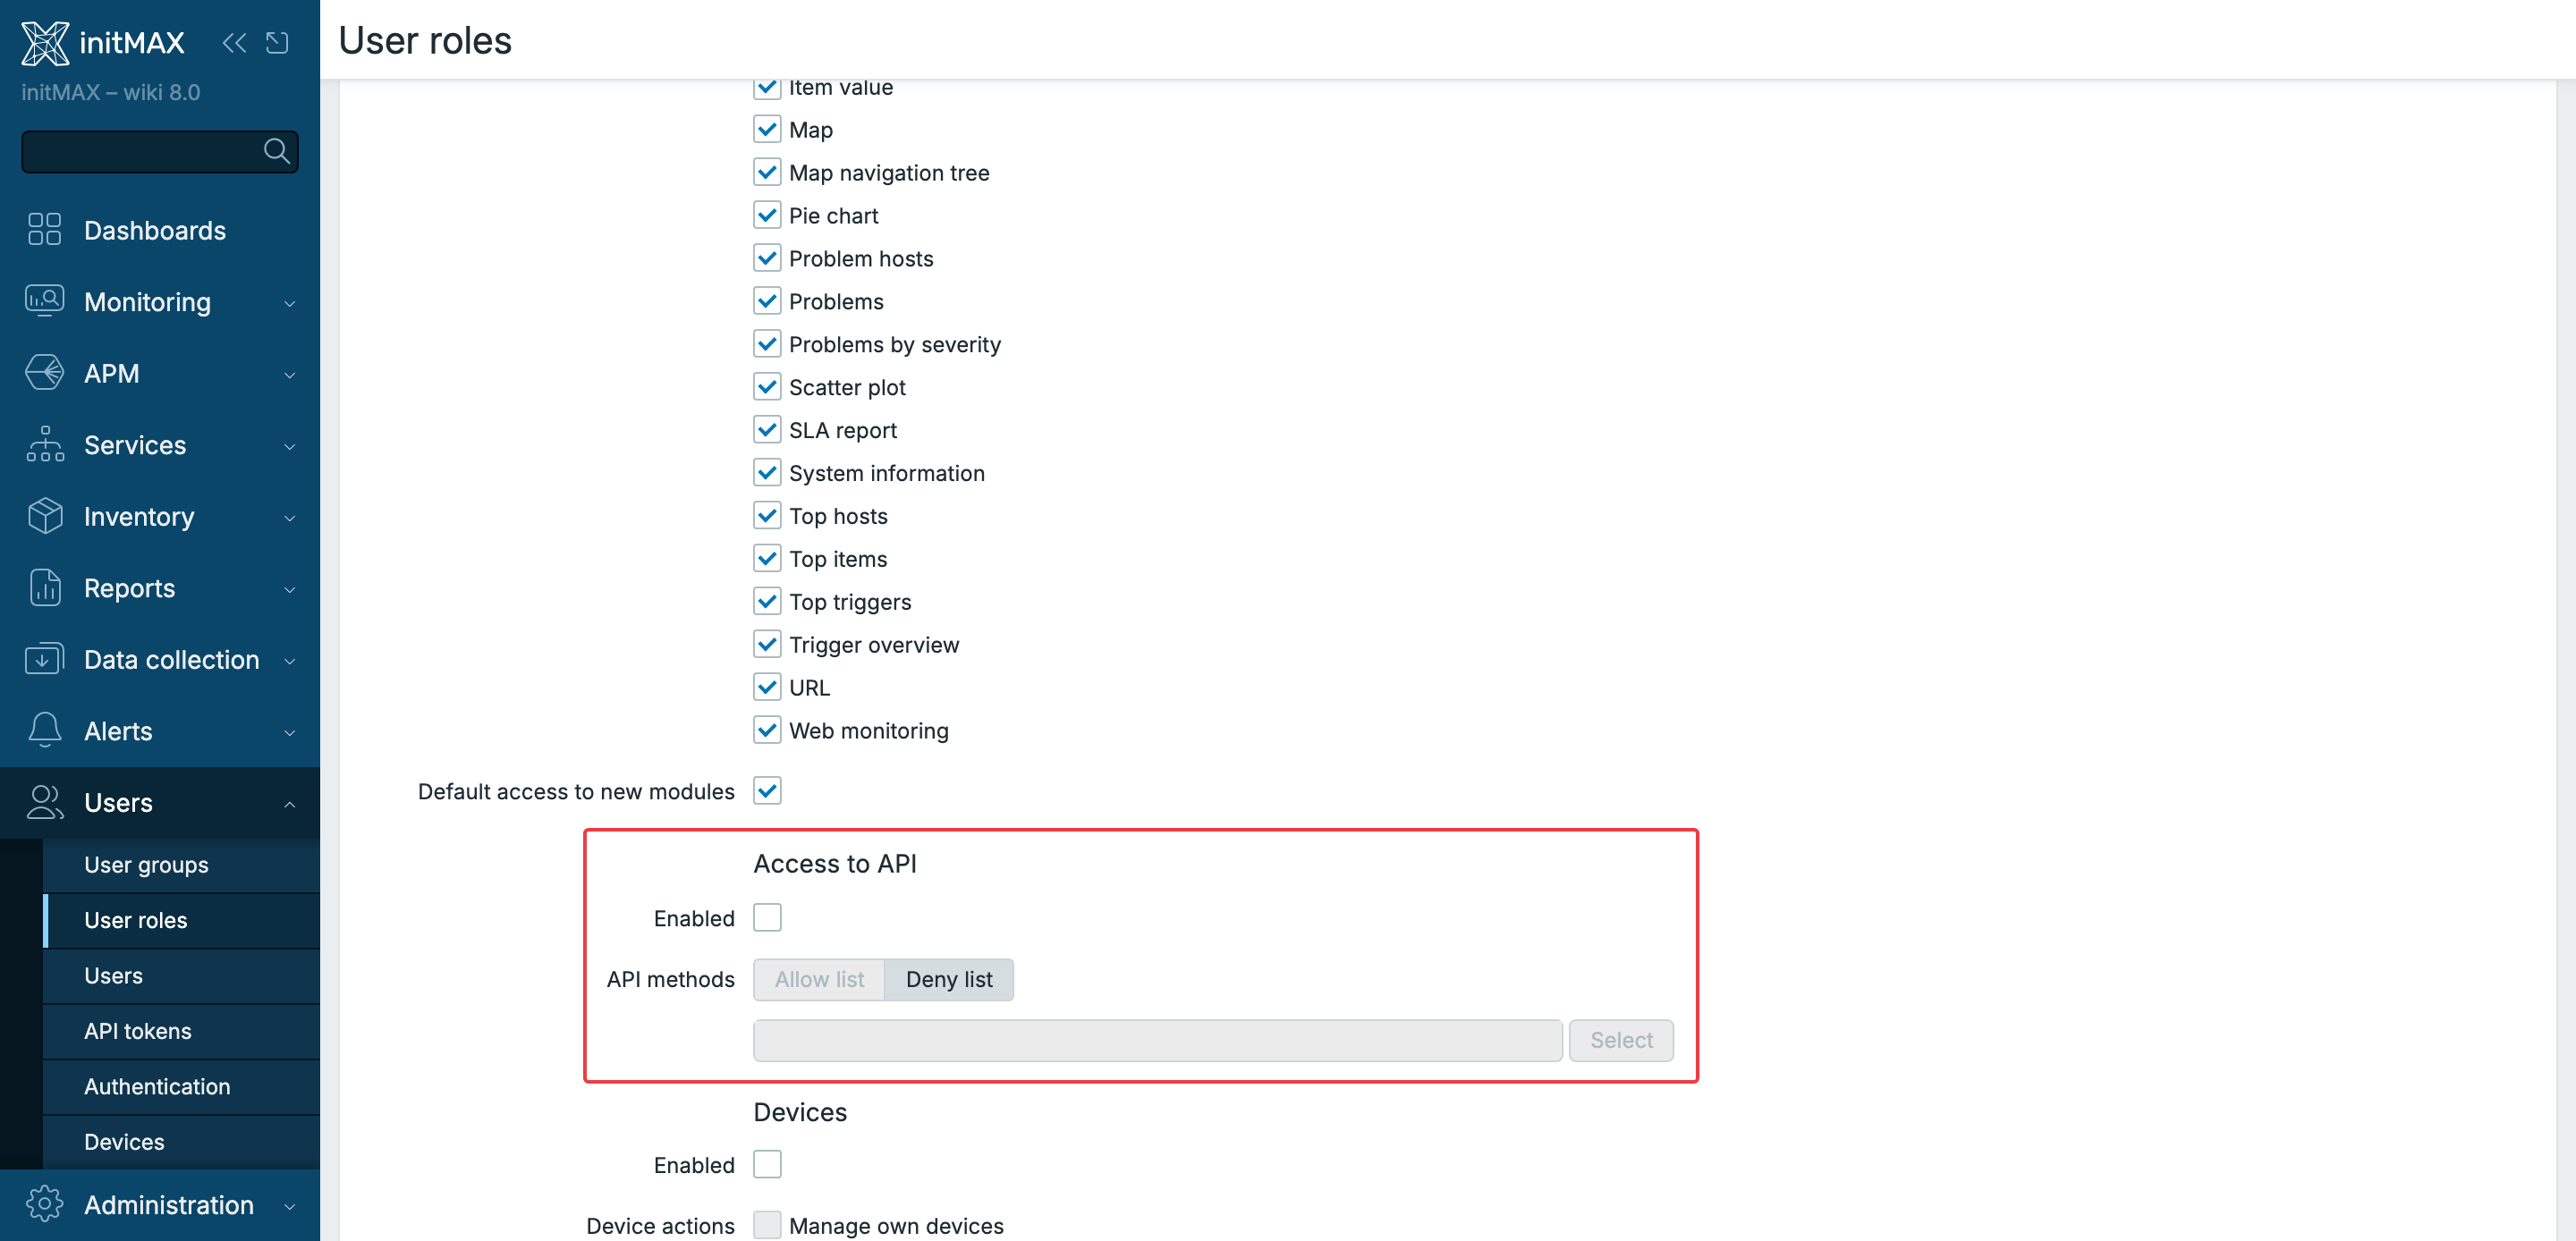
Nové uživatelské role mají Access to API vypnutý, včetně typu Super admin. Integrace, skripty nebo náš Zabbix MCP server potřebují API v roli výslovně povolit. Prázdný allow list nepovoluje žádnou API metodu: při jeho použití nestačí API pouze zapnout, je třeba vybrat i potřebné metody. Existující role si při upgradu zachovají nastavení přístupu k API. Do dosud prázdných allow listů upgrade doplní *, aby zachoval původní přístup ke všem metodám. Po upgradu proto tyto role projděte a wildcard nahraďte konkrétními metodami, které integrace skutečně používá.
Oficiální Zabbix MCP server
Zabbix MCP server propojuje AI asistenta se Zabbix API. Není to model AI ani součást automaticky spuštěná instalací Zabbix serveru. Instaluje se jako samostatný balíček zabbix-mcp-server z oficiálního repozitáře, případně se sestaví ze samostatných zdrojů. Běží jako vlastní služba; v /etc/zabbix/zabbix_mcp_server.conf se nastaví adresa API FrontendURL, povolení klienti AllowedIP a TLS.
Oficiální implementace je zaměřená hlavně na čtení monitoringu a obsluhu incidentů:
- Načítá hosty, skupiny, šablony, položky, LLD pravidla, rozhraní, makra, triggery, problémy, údržby a historii položek kromě binárních dat.
- U problémů umí potvrzení a jeho zrušení, komentář, změnu závažnosti, potlačení a jeho zrušení nebo ruční uzavření, pokud ho trigger dovoluje.
- U údržeb nabízí vytvoření, změnu a smazání. Nejde o plné administrační pokrytí Zabbix API: tyto nástroje nenahrazují například zakládání hostů, správu šablon či dashboardů.
Klient musí podporovat Streamable HTTP. Samostatný starší SSE transport ani lokální stdio tato implementace nenabízí. Autentizace používá přímo Zabbix API token v každém požadavku, nikoli OAuth přihlášení. Platí oprávnění vlastníka tokenu. Pro historii je navíc omezený rozsah dotazu a výchozí konfigurace některé čtecí nástroje z bezpečnostních důvodů zakazuje.
Dostupné nástroje omezují AllowTool a DenyTool. Schválení zápisu závisí na klientovi: při podpoře form elicitation čeká změna na potvrzení, jinak se povolený zápis provede rovnou. Začněte účtem s omezenými právy a zapněte jen potřebné operace. Podrobnosti uvádí oficiální dokumentace.
Pro širší práci se Zabbixem přes AI doporučujeme náš initMAX Zabbix MCP server. Pokrývá 100 % veřejných API metod Zabbixu 8.0, nejen čtení monitoringu a obsluhu incidentů. Umožňuje také správu hostů, položek, triggerů, šablon a dashboardů. Vedle připravených nástrojů nabízí přímé volání dalších API metod; dostupné operace vždy omezují oprávnění účtu a nastavená pravidla přístupu.
Podporuje OAuth 2.1, více instancí Zabbixu a transporty Streamable HTTP, starší SSE i lokální stdio. Součástí je webový administrační portál, ve kterém lze naklikat servery, uživatele, tokeny a přístupová pravidla. Nabízí scopes, režim pouze pro čtení, dvoukrokové potvrzení řízených zápisů, souhrnné pohledy, analýzu dat, grafy a reporty. Oficiální MCP tak může stačit pro užší obsluhu incidentů; naše implementace nabízí podstatně širší možnosti správy a automatizace.
Feature flags: systémové omezení funkcí frontendu
Do zabbix.conf.php přibývá pole $ZBX_FEATURE_FLAGS, kterým se na úrovni systému vypnou celé funkce frontendu, bez ohledu na oprávnění uživatelů:
$ZBX_FEATURE_FLAGS['modules_config_enabled'] = false;               // omezí správu modulů
$ZBX_FEATURE_FLAGS['http_auth_enabled'] = false;                    // vypne HTTP autentizaci
$ZBX_FEATURE_FLAGS['media_type_denylist'] = ['script', 'webhook'];  // zablokuje editaci těchto typů médií
$ZBX_FEATURE_FLAGS['banners_enabled'] = false;                      // vypne informační bannery
modules_config_enabled=false skryje stránku Modules a zablokuje správu modulů přes frontend a příslušné API metody. Není to automatické odinstalování ani vypnutí již aktivních modulů. Jejich načítání běží samostatně podle uloženého stavu a oprávnění. Podobně media_type_denylist omezuje editaci vybraných typů médií, nikoli samotné odesílání již nastavených notifikací. Provozovatel tak může centrálně omezit změny konfigurace i pro administrátory.
Ostatní přepínače nemají stejný význam: http_auth_enabled=false vypne samotnou HTTP autentizaci, nejde jen o skrytí jejího nastavení. banners_enabled=false vypne informační bannery. Rozlišujte proto omezení správy konfigurace od vypnutí konkrétní funkce.
Správa modulů: vlevo povolená (true), vpravo blokovaná (false).
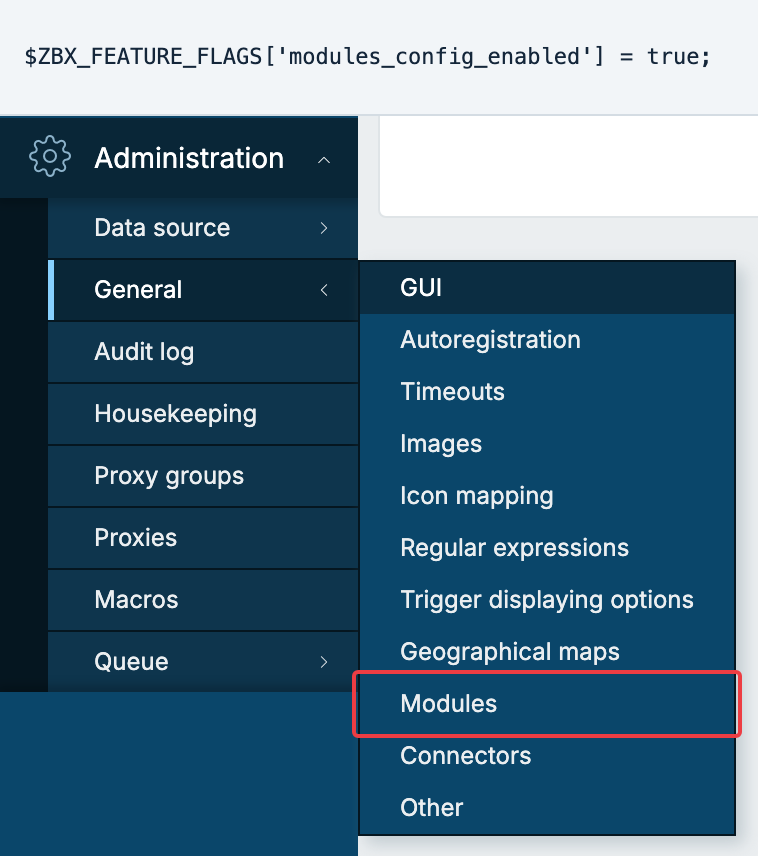
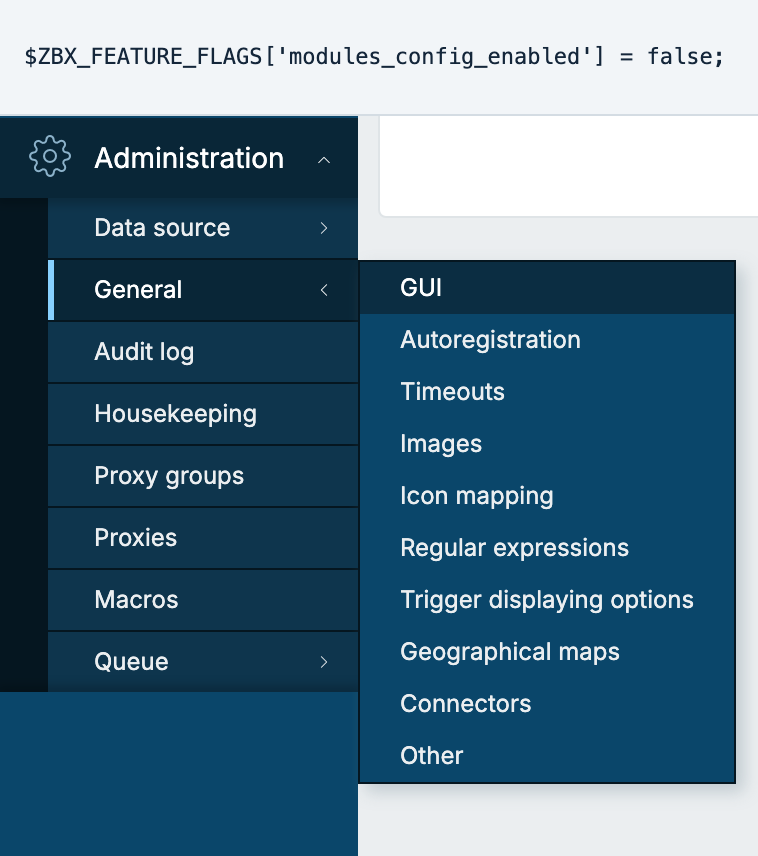
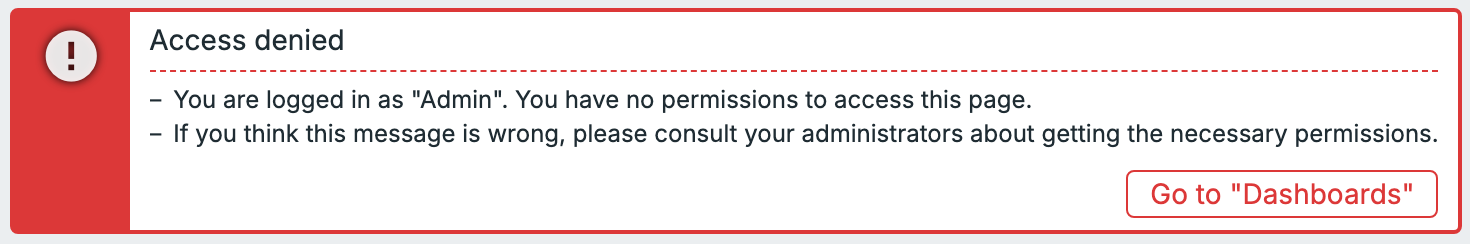
Pokud se někdo pokusí obejít omezení přímým otevřením URL stránky Modules, Zabbix mu přístup odepře a zobrazí tuto hlášku:
Trapper bez starých protokolů a regulární výrazy pro klíče agentů
Trapper serveru a proxy už nepřijímá legacy textové a XML protokoly používané před Zabbixem 1.6. Nejde tedy obecně o všechny verze před 4.x. Před upgradem prověřte velmi staré agenty a vlastní sendery používající tyto historické formáty a nahraďte je podporovaným klientem nebo aktuálním Zabbix protokolem.
Minimální kompatibilní verze klasického Zabbix agenta se tím posouvá z 1.4 na 1.6. Nejde o změnu minima agenta 2, který je podporovaný od řady 4.4.
V konfiguraci agenta (i agenta 2) přibývají AllowKeyRegexp a DenyKeyRegexp. Dosud šlo klíče povolovat jen zástupnými znaky, teď jde napsat pravidlo jako PCRE2 výraz, který musí odpovídat celému klíči. Všechna pravidla AllowKey, DenyKey, AllowKeyRegexp a DenyKeyRegexp se skládají do jednoho seznamu v pořadí, v jakém jsou v souboru, a rozhoduje první shoda:
AllowKeyRegexp=^vfs\.fs\.(size|inode)\[/(var|opt)(/[^,]*)?,.*\]$
DenyKey=system.run[*]
Omezení uživatelů na konkrétní proxy
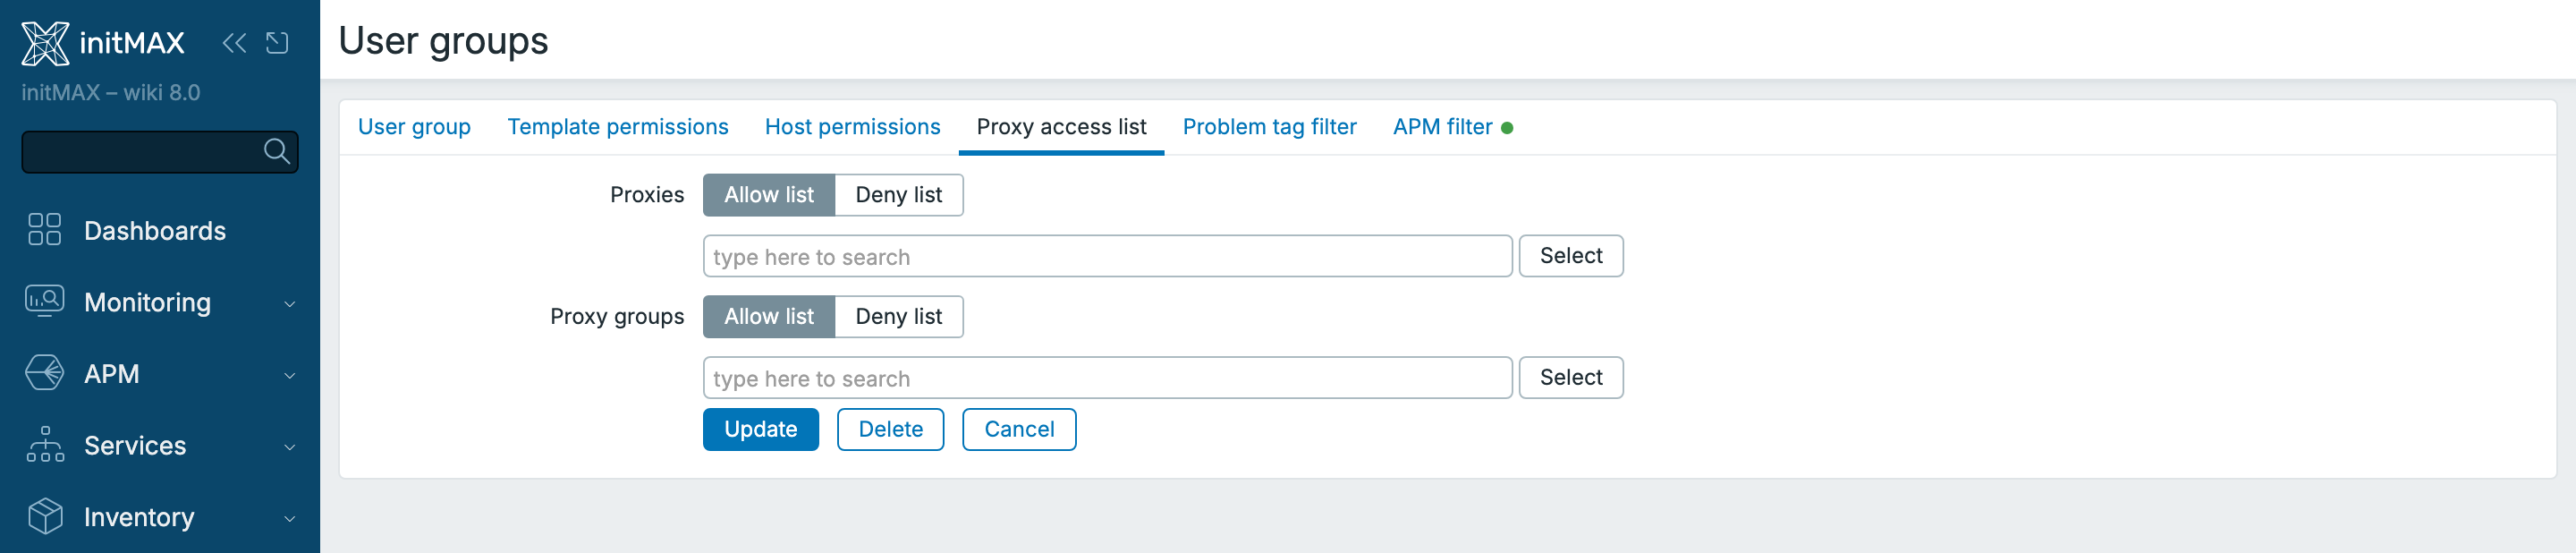
Pro poskytovatele služeb, kteří na jednom Zabbixu obsluhují více zákazníků, je určený Proxy access list v uživatelské skupině: seznam proxy a proxy skupin (allow nebo deny), ke kterým smí uživatelé skupiny přiřazovat hosty a které vidí v discovery. Nově vytvořené skupiny mají výchozí režim allow list, takže bez explicitního povolení uživatel na cizí proxy nedosáhne; hosty monitorované nepřístupnou proxy vidí jako Inaccessible proxy.
Doplňuje je oprávnění uživatelské role Select „Server“ for monitoring and discovery. Určuje, zda uživatel může přiřazovat monitoring přímo serveru. V prostředí s více zákazníky tak můžete omezit nejen výběr proxy a proxy skupin, ale i možnost toto omezení obejít volbou serveru. Proxy access list neurčuje sám o sobě oprávnění ke všem hostům; ta se dál řídí přístupem ke skupinám hostů.
Identita serveru
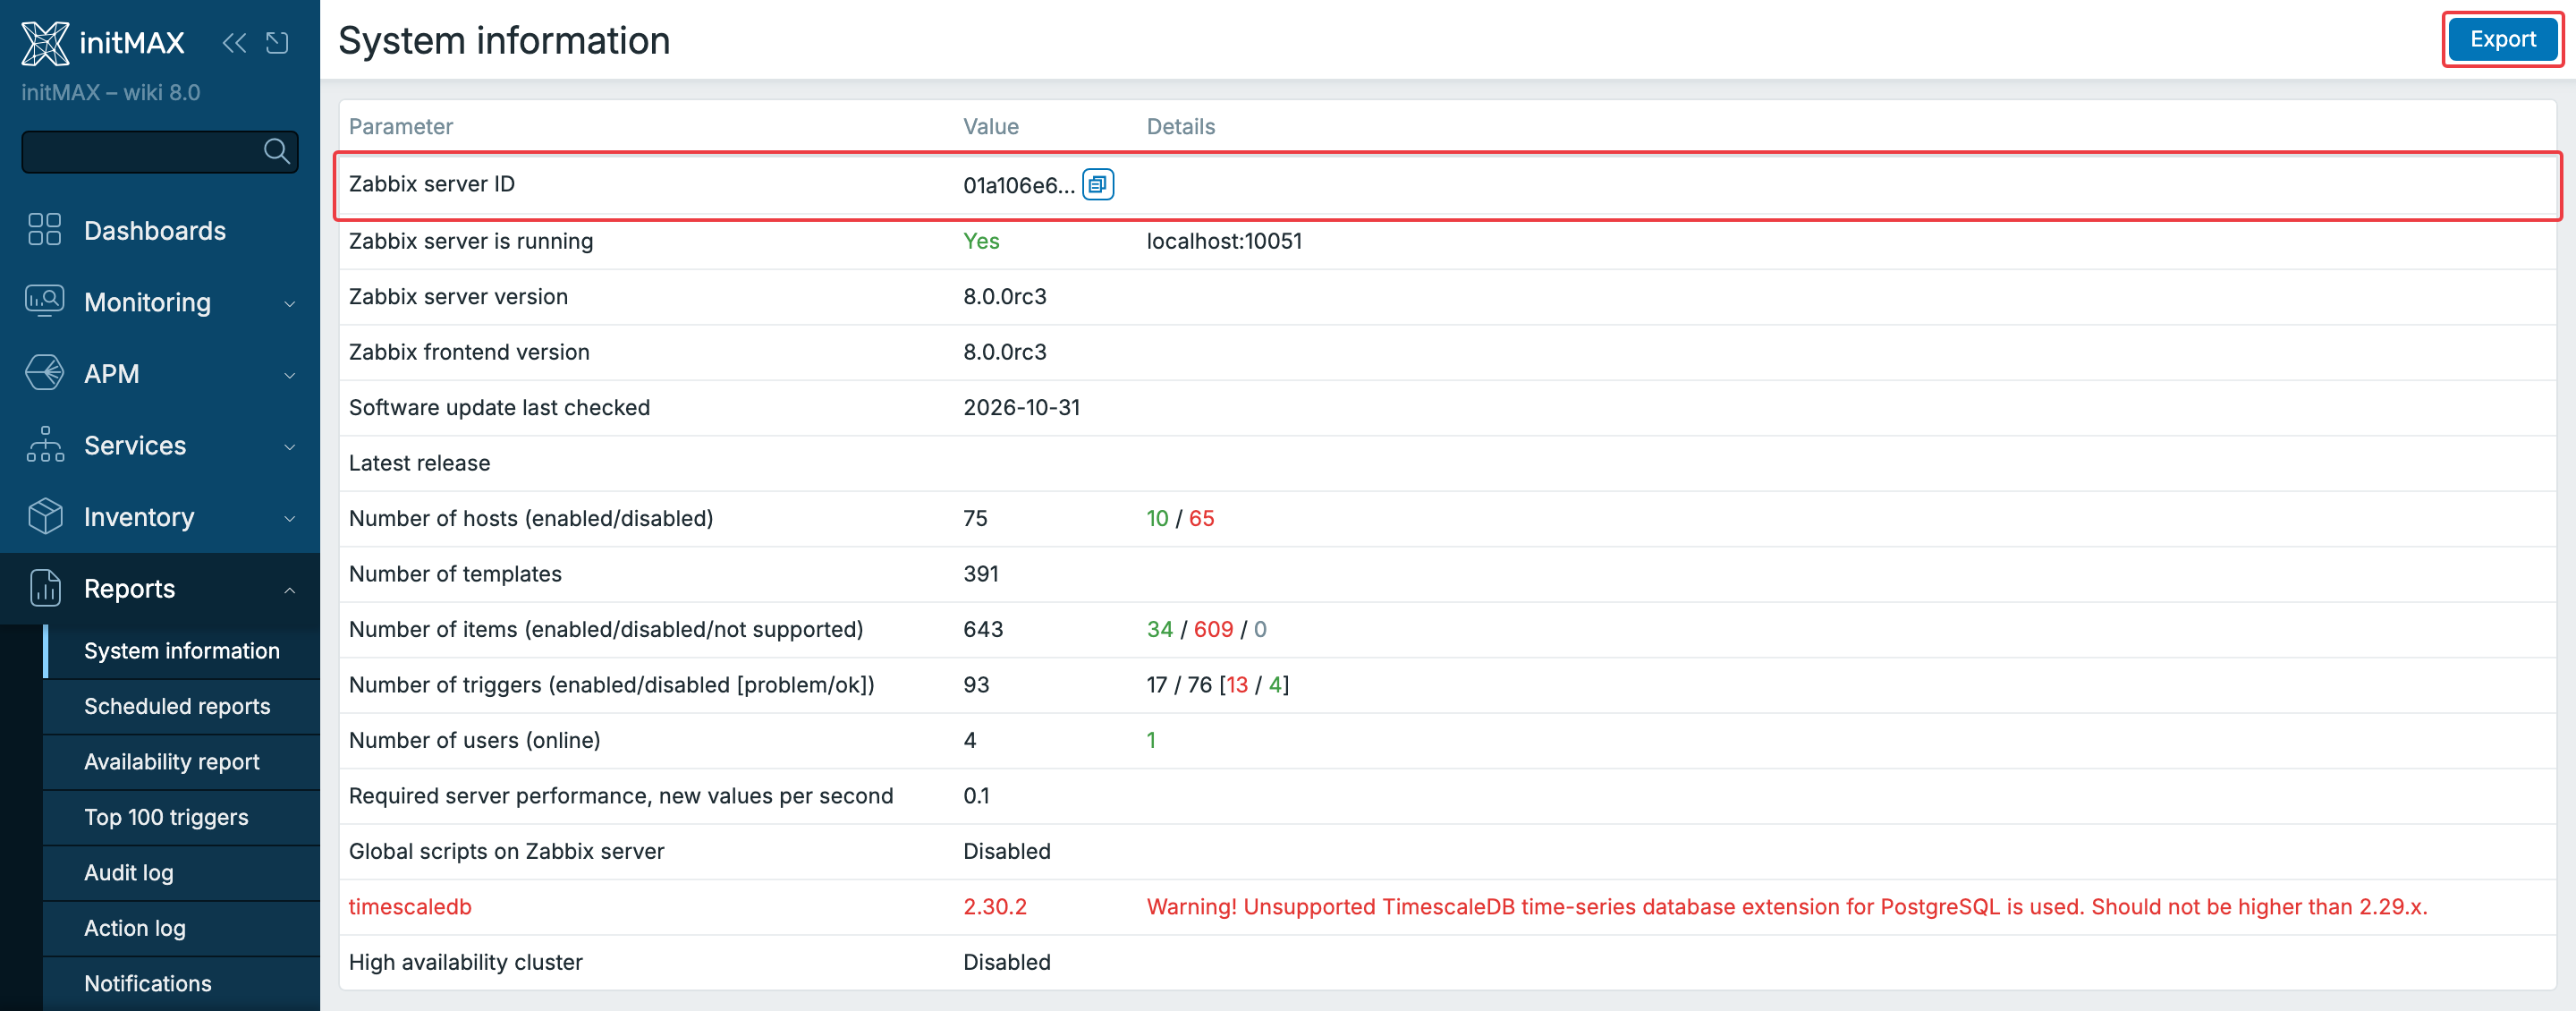
Zabbix server ID je trvalý identifikátor instalace ve formátu UUIDv7. Server ho při prvním spuštění vytvoří a uloží do hlavní databáze. Najdete ho v Reports > System information, odkud lze zkopírovat celou hodnotu. V HA mají všechny uzly společné server ID; nezaměňujte ho s ID jednotlivého HA uzlu.
Mobilní aplikace ho používá k rozlišení instalací a je součástí párovacího QR kódu. Slouží také při ověřování podepsaných API požadavků zařízení (DPoP), které se vážou na konkrétní instanci i volanou metodu. API serverinfo.get podle zadaného ID ověří instanci a vrátí čas posledního kontaktu serveru; v HA jde o aktivní uzel. Tlačítko Export uloží systémový přehled do JSON včetně server ID a případných HA uzlů. Samotné ID není přístupový token.
Co to znamená v praxi
Před upgradem projděte role a integrace, které API používají, a připravte allow listy metod. Zvažte přechod Vault tokenu na AppRole, u agentů převeďte složité AllowKey masky na regulární výrazy a v prostředích s více týmy nastavte feature flags a proxy access listy dřív, než uživatelé začnou instalaci osidlovat.
Údržby a suppression: ad-hoc údržba z problému, potlačení zapsané v události
Údržby v Zabbixu dosud znamenaly plánování: dopředu založit maintenance na skupinu hostů, nastavit okno a doufat, že nikdo nezapomene. Zabbix 8.0 přidává druhou cestu, ad-hoc údržbu spuštěnou přímo z problému na pár kliknutí, rozšiřuje cíle údržby o triggery a názvy událostí a hlavně zapisuje potlačení údržbou do historie události, takže otázka „proč mi nepřišla notifikace“ má konečně odpověď v UI.
Ad-hoc údržba přímo z Problems
Kontextové menu problému má novou sekci Maintenance se čtyřmi volbami: Suppress host, Suppress trigger, Suppress by event name a Suppress by tags. Každá otevře formulář údržby už předvyplněný podle vybraného problému: název Ad-hoc: název události, začátek teď, konec za výchozí periodu a jako cíl host, trigger, název události nebo tagy problému. Stačí zkontrolovat a uložit.
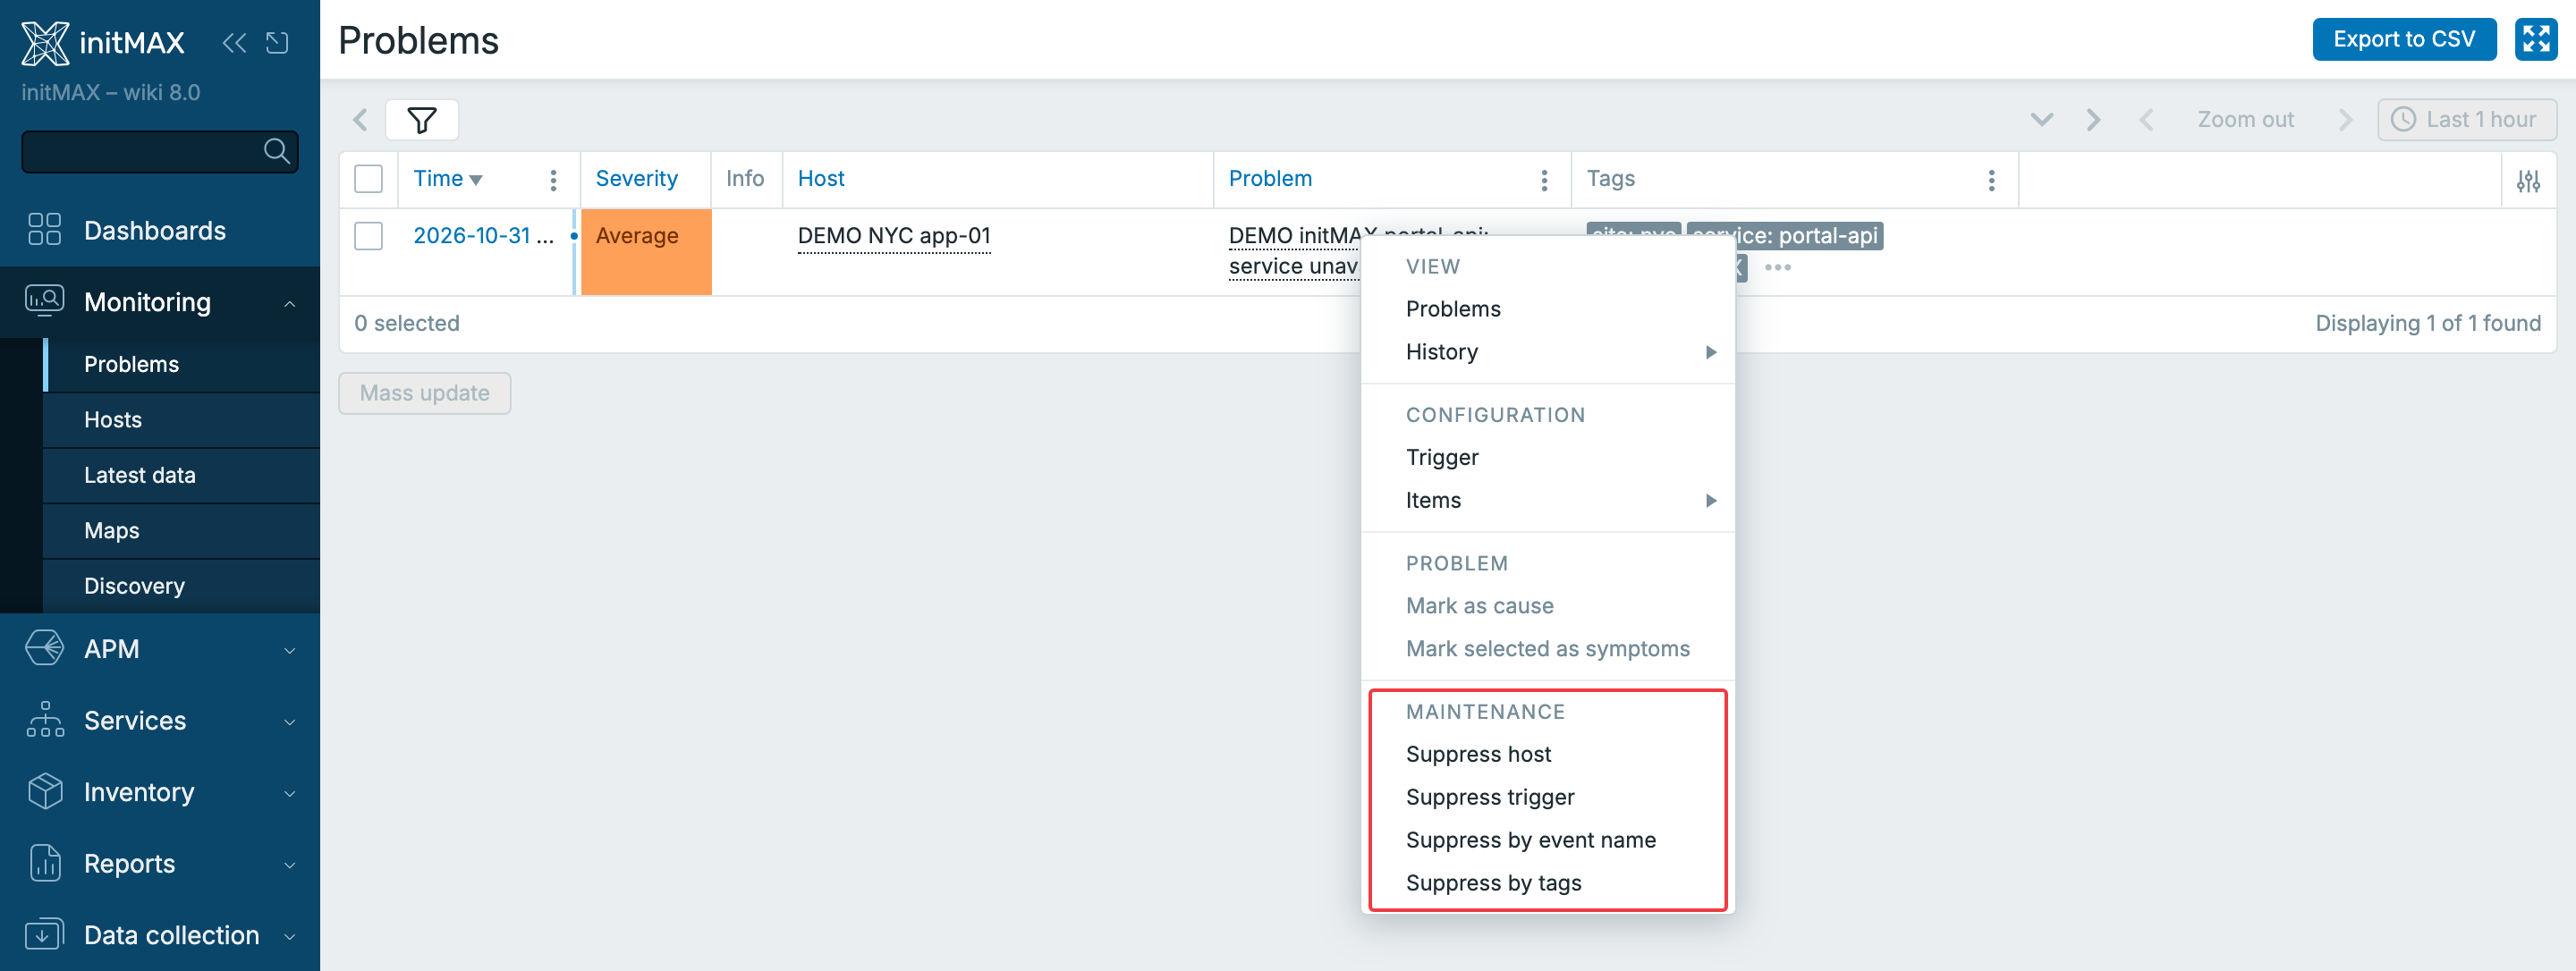
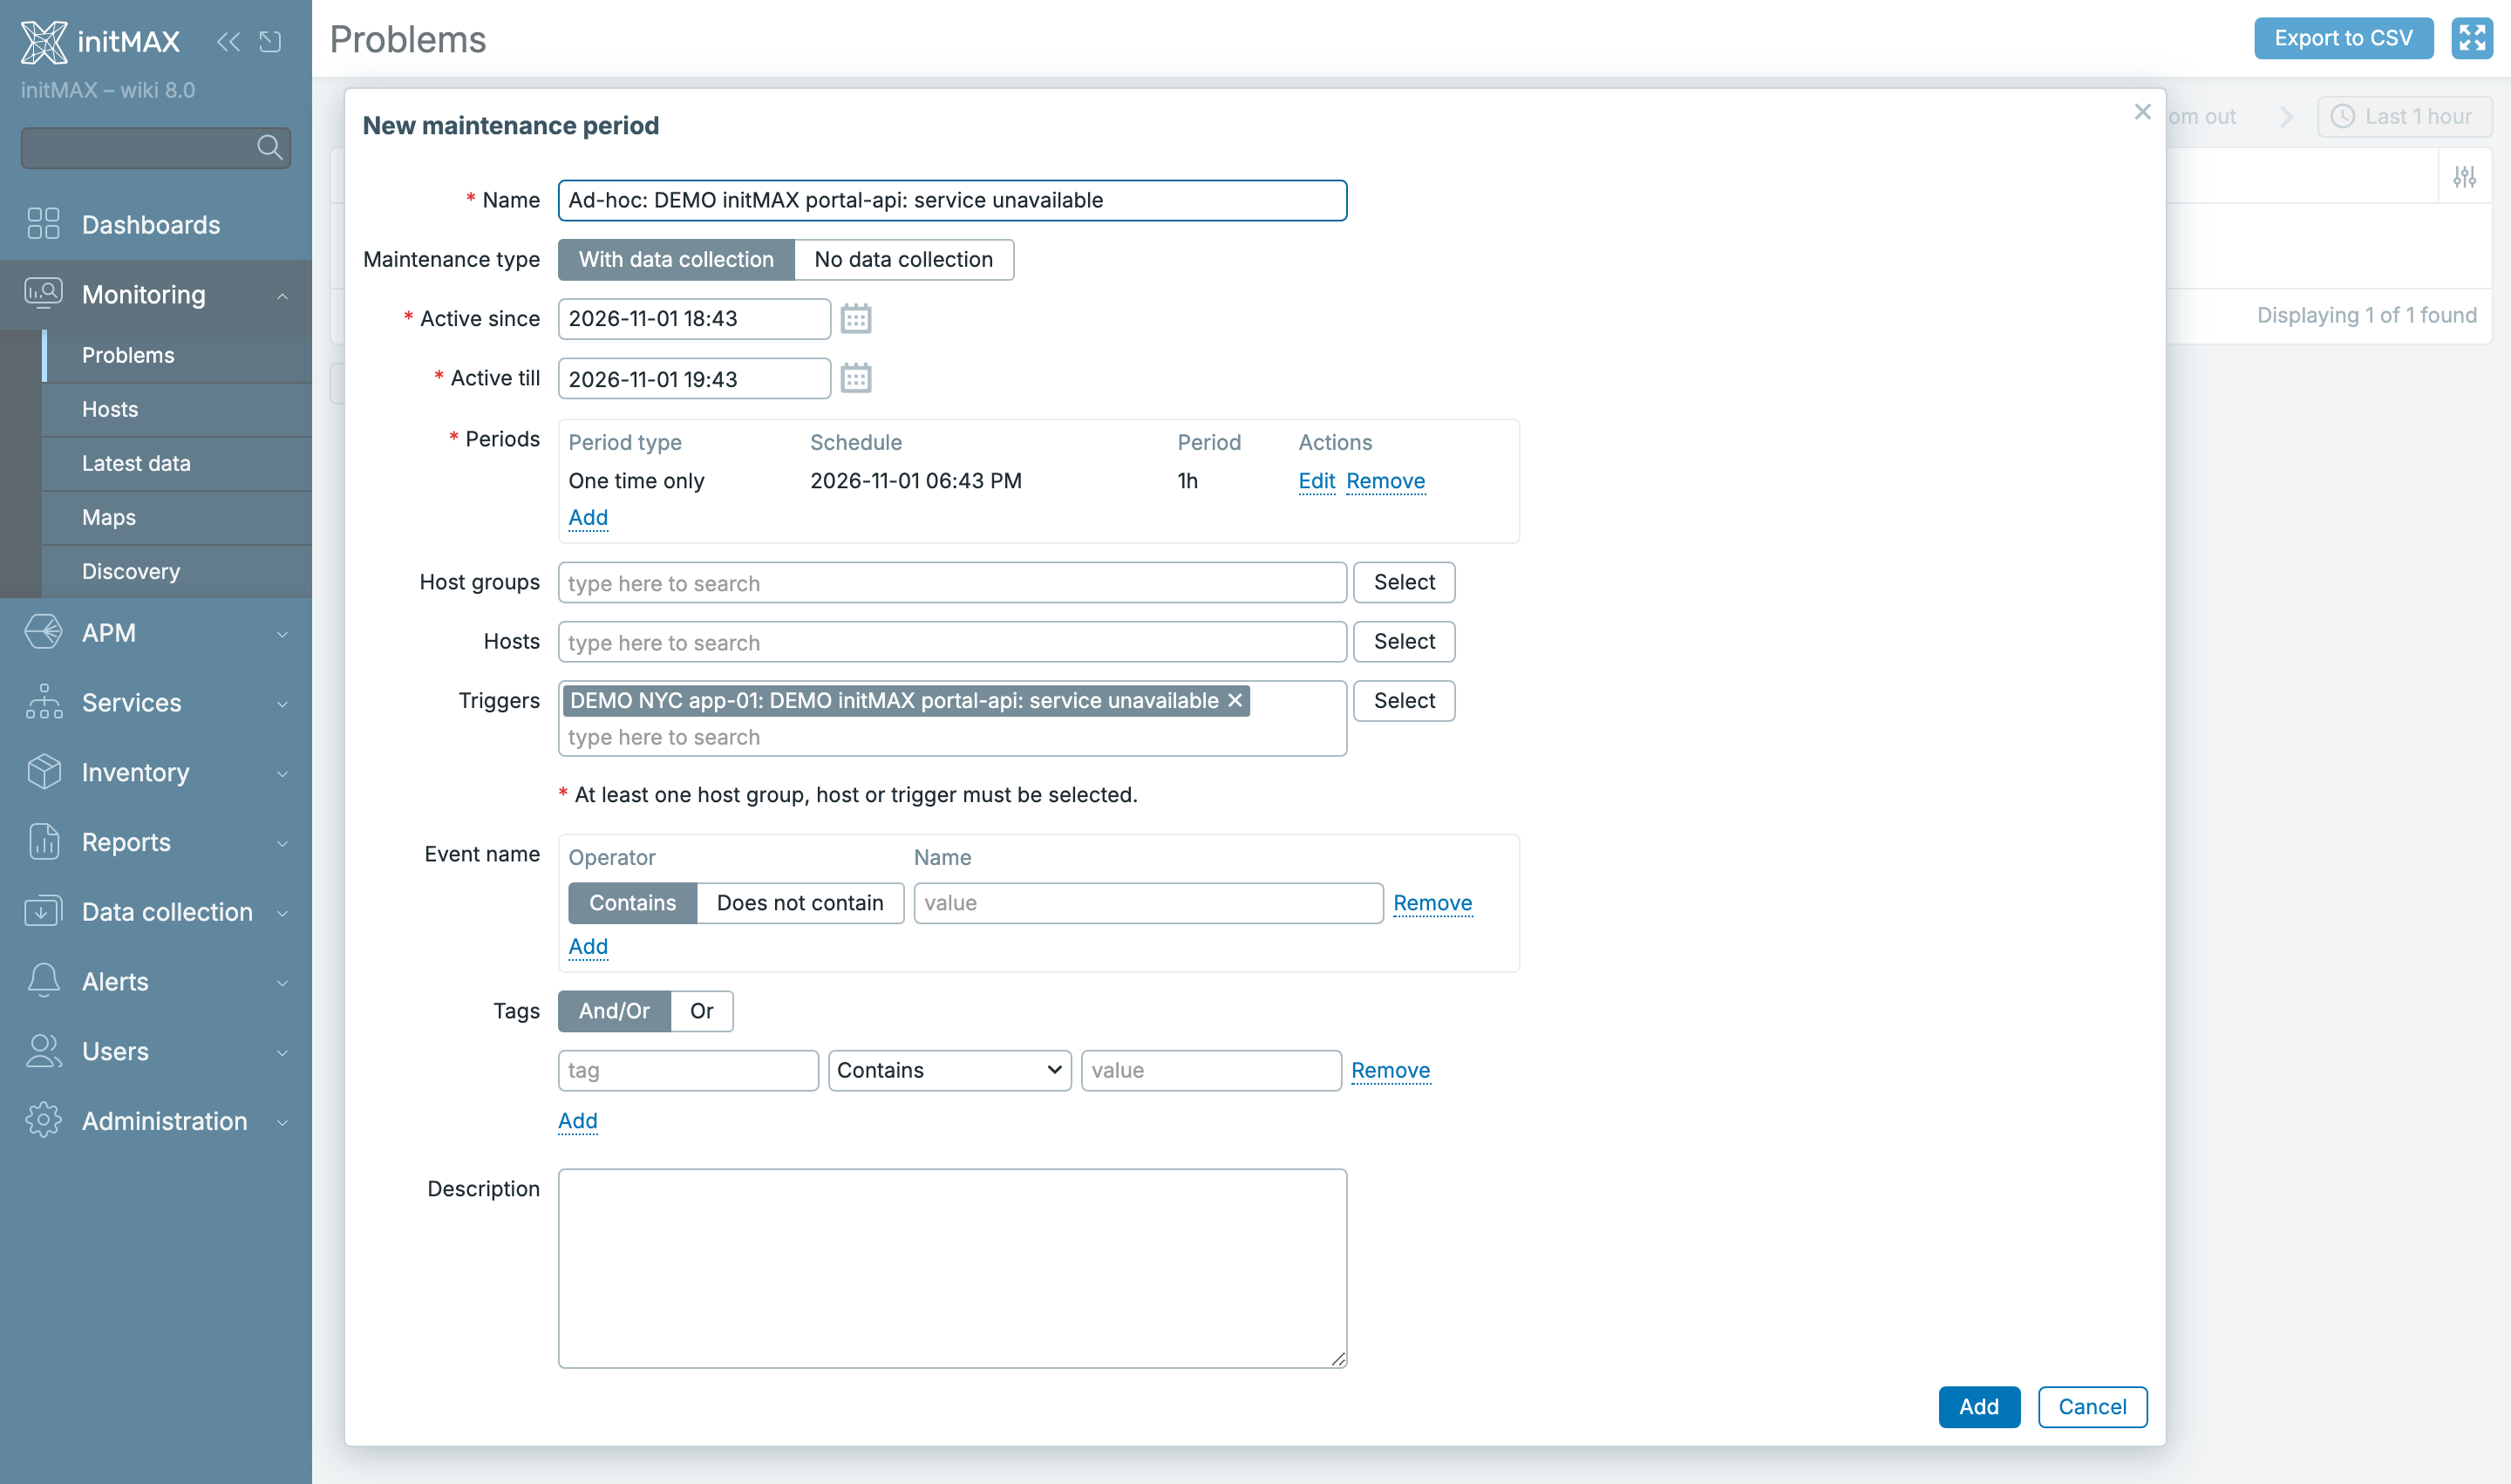
Údržba otevřená přes Suppress trigger má předvyplněný trigger vybraného problému, název i časové okno. Délka se přebírá z nastavení Default maintenance period v profilu uživatele; v této ukázce je to jedna hodina. Před uložením lze údaje upravit.
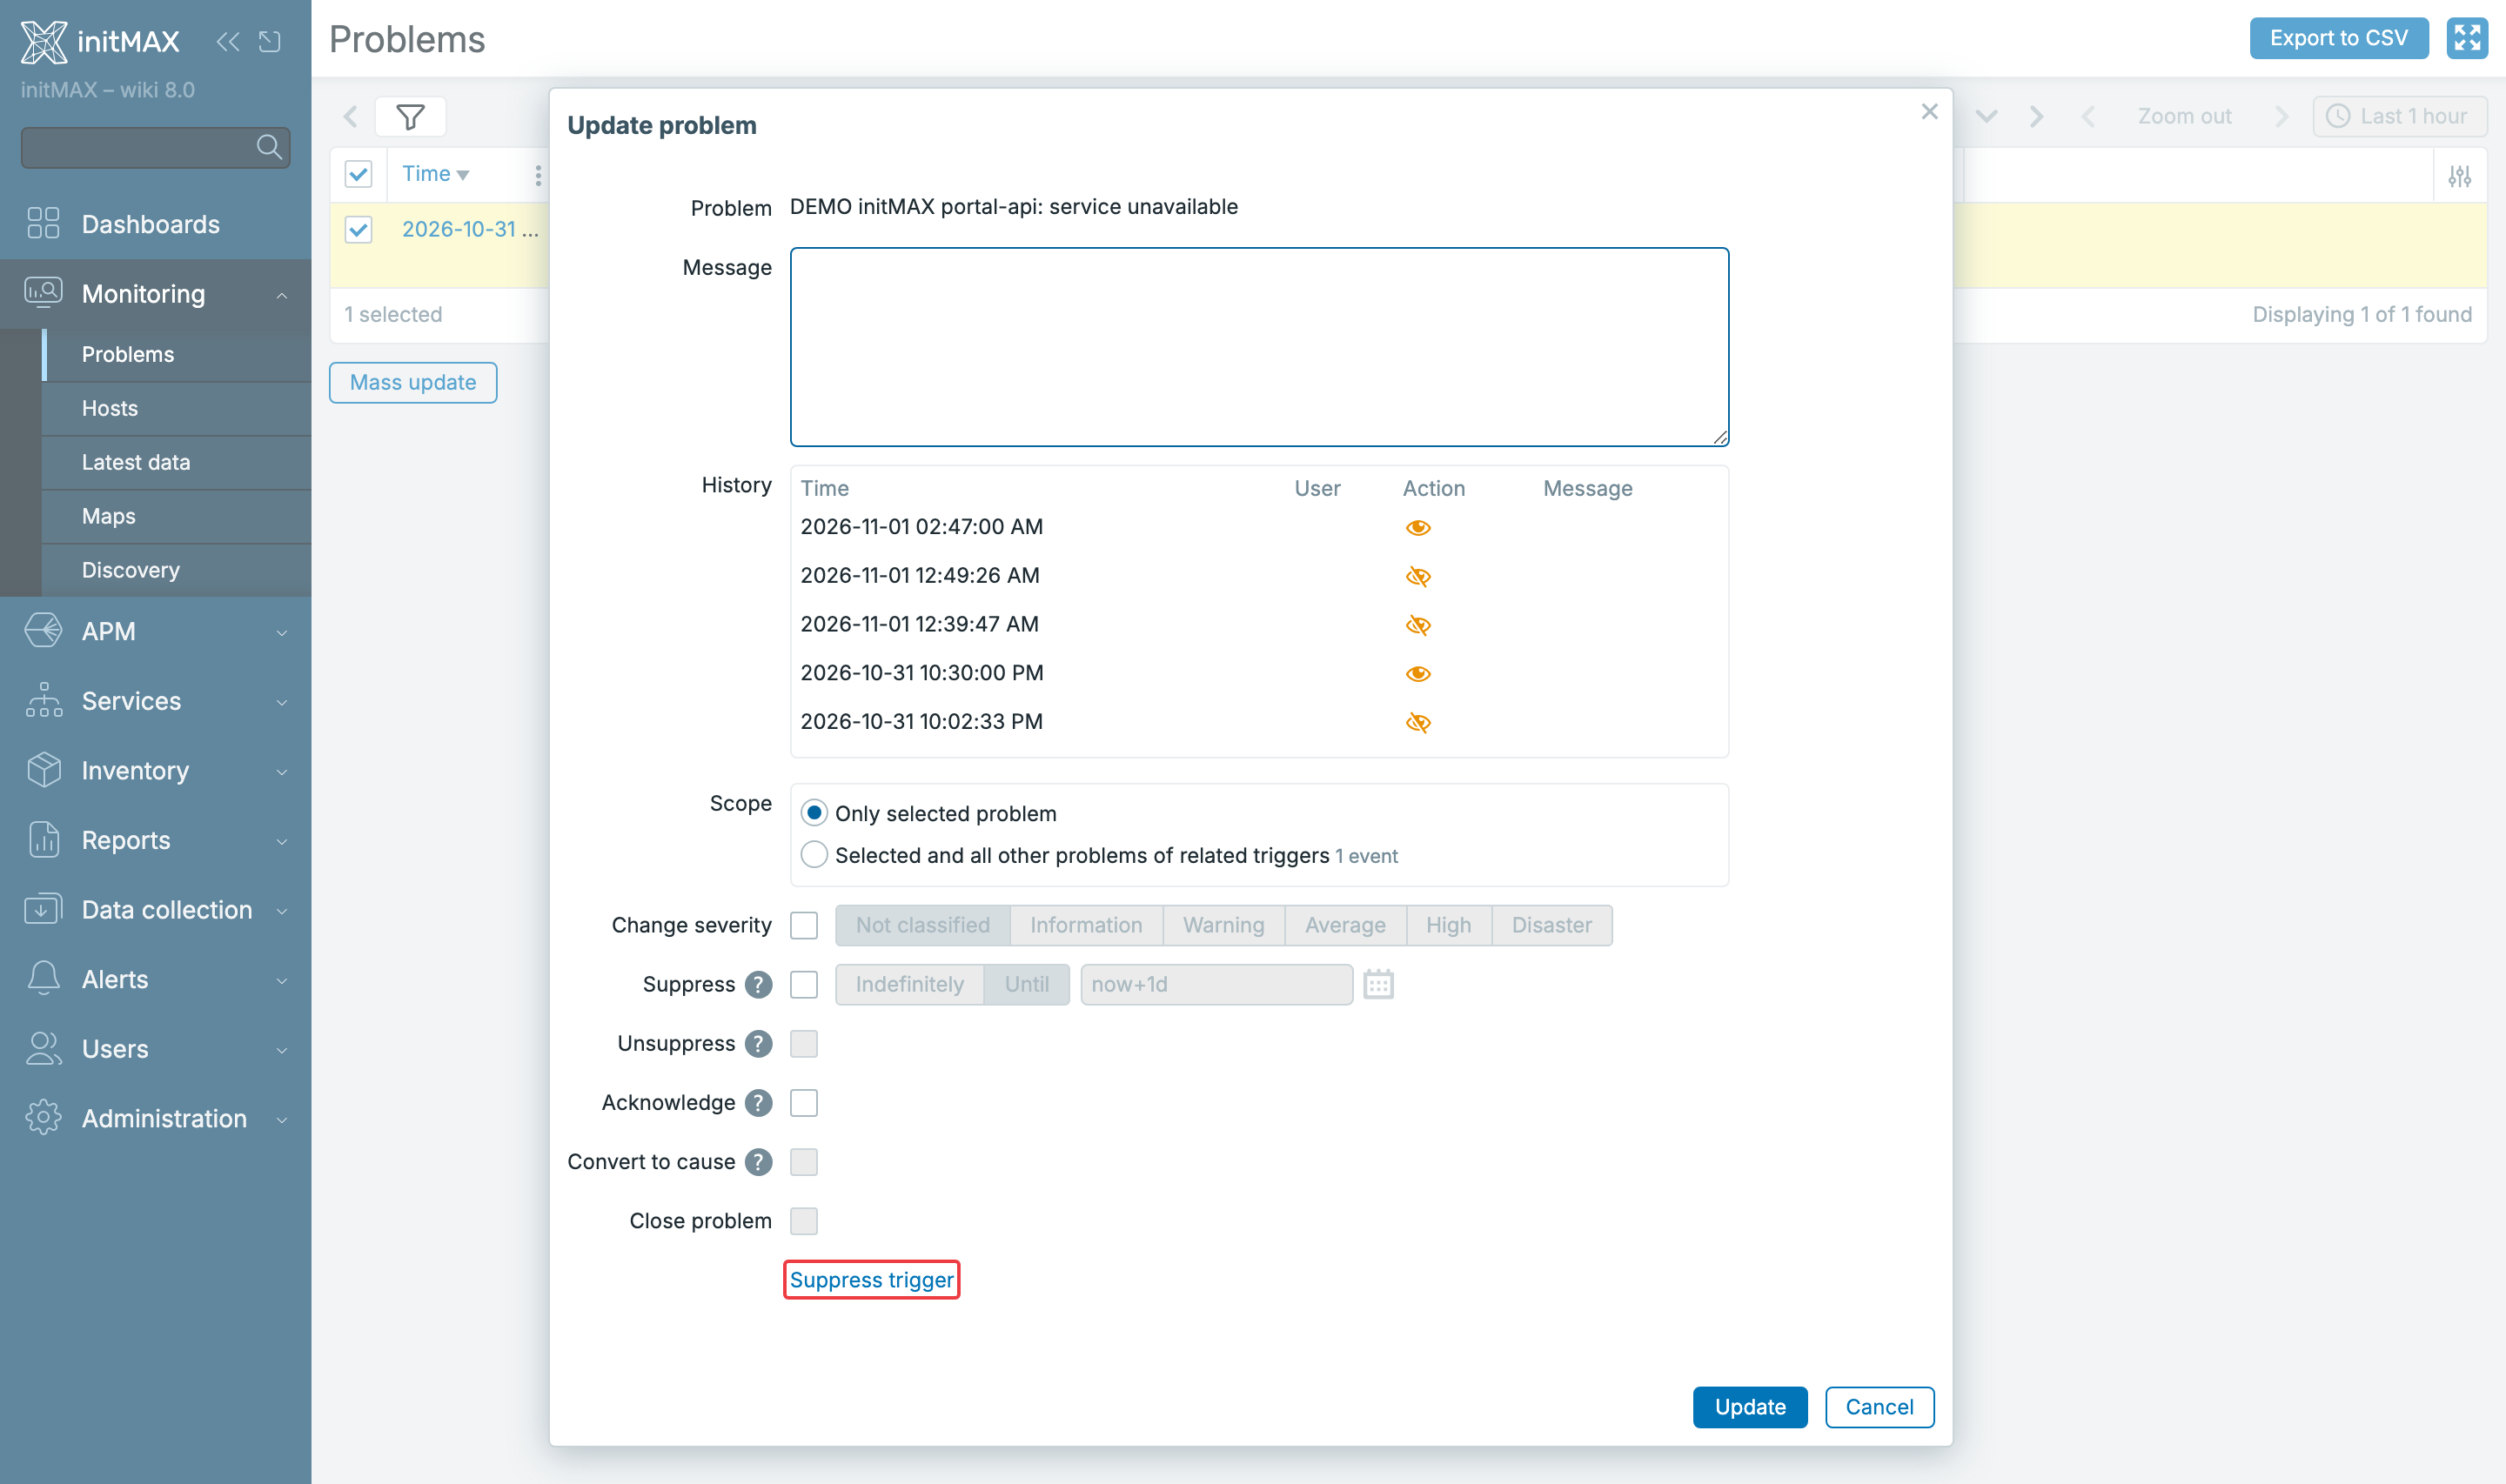
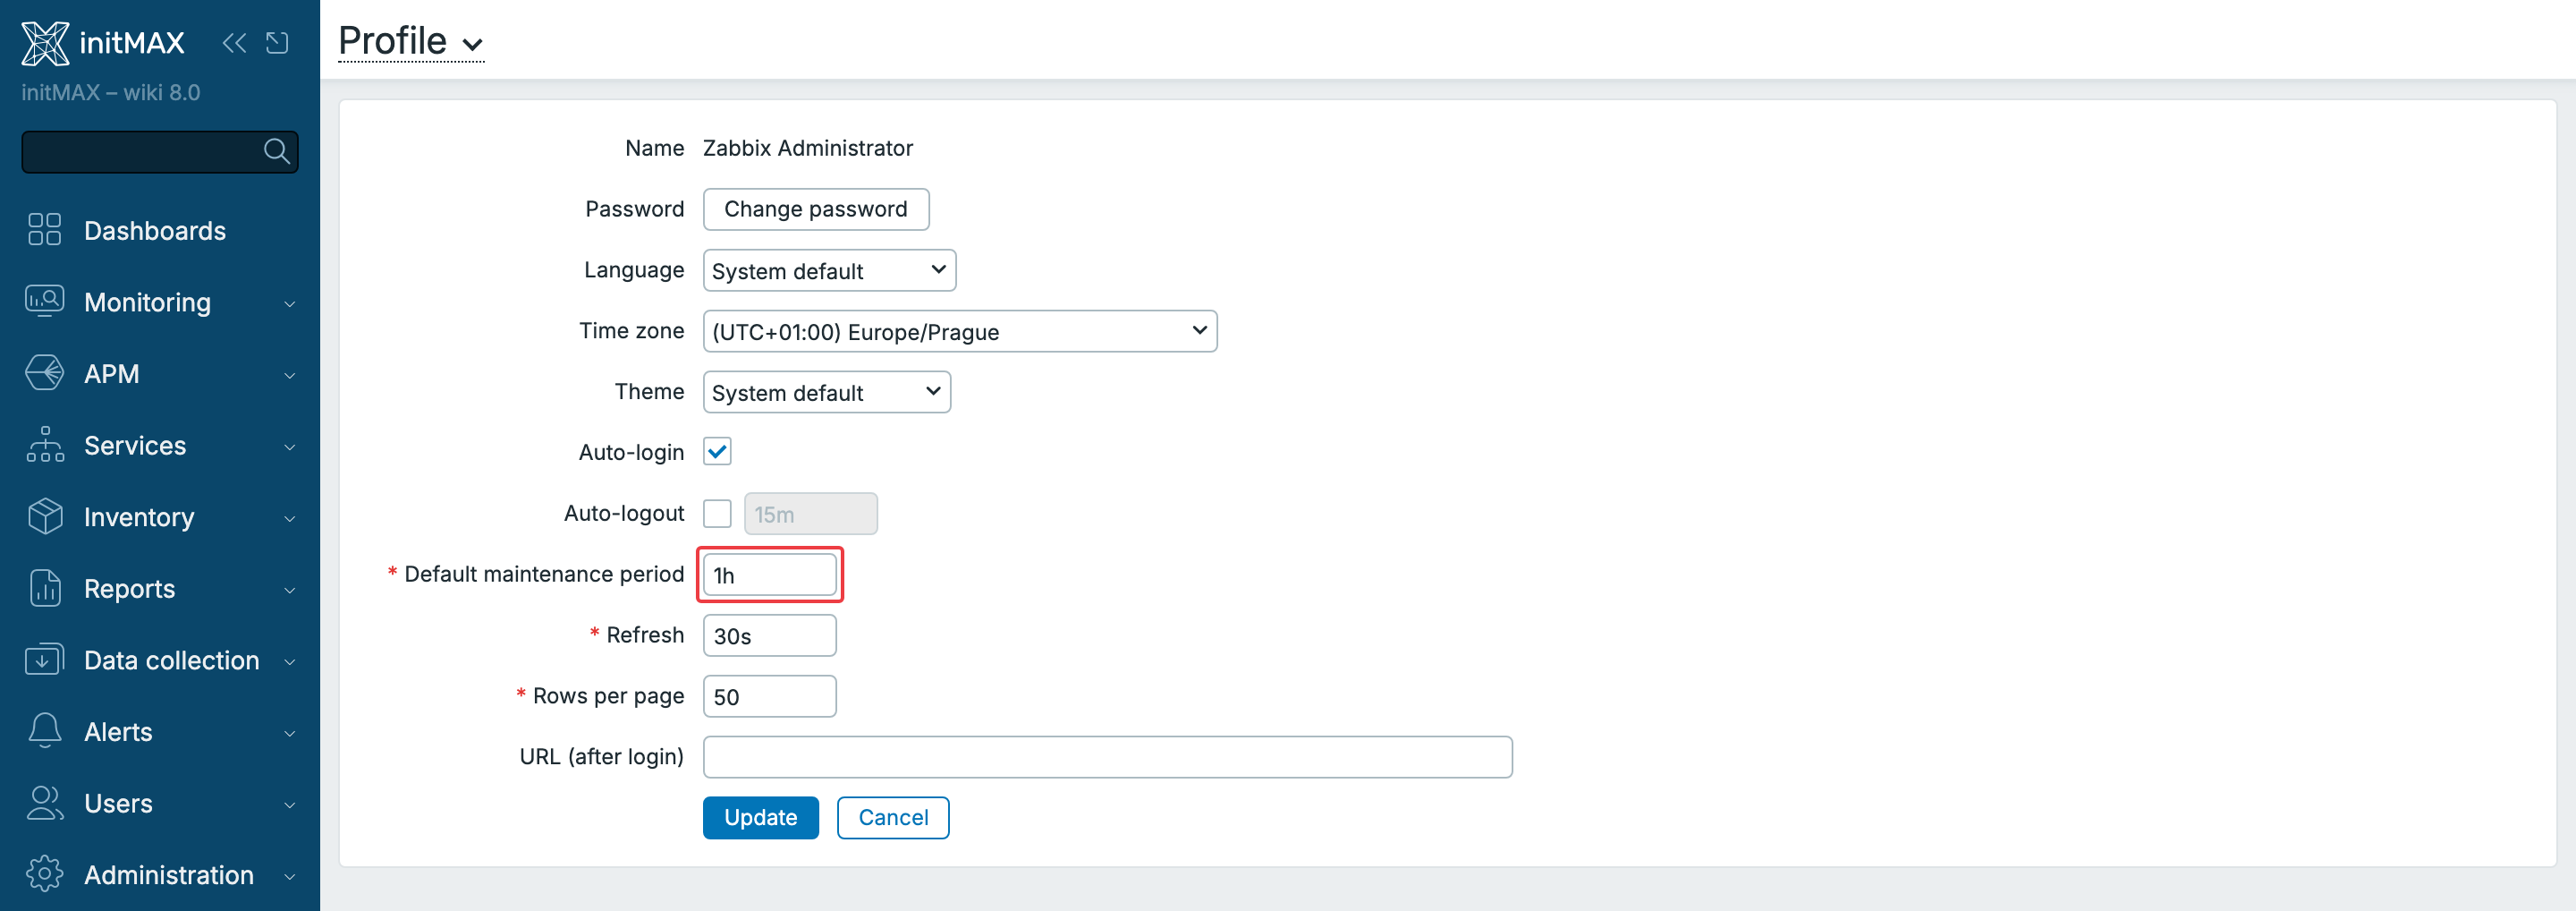
Stejný odkaz Suppress trigger je i v dialogu Update problem, a při hromadné aktualizaci více problémů se z něj stane Suppress triggers s odpovídajícím počtem triggerů. Délku okna určuje nové pole Default maintenance period v profilu uživatele (výchozí 1 hodina), takže operátor, který typicky řeší incidenty do 30 minut, si nastaví 30m a ad-hoc údržba se za něj nikdy nezapomene ukončit. Volby se zobrazí jen uživatelům, kteří mají v roli povolené vytváření údržeb a mají editační práva na daný host nebo trigger.
Odkaz Suppress trigger v dialogu Update problem.
Příklad nastavení výchozí doby údržby na jednu hodinu v uživatelském profilu pomocí pole Default maintenance period:
Možnost nastavení údržby na trigger nebo název události pomocí API
Údržby bylo možné přes API vytvářet už dříve. Zabbix 8.0 nově přidává cílení na triggery a podmínky podle názvu události. U maintenance.create a maintenance.update se nastavují pomocí triggers a event_names; při čtení přes maintenance.get slouží selectTriggers a selectEventNames. Tyto možnosti vyžadují údržbu se sběrem dat (maintenance_type=0).
Můžete tak potlačit jediný trigger disku a ostatní monitoring hosta ponechat aktivní, nebo omezit údržbu na problémy s „certificate expires“ v názvu. Stejné volby najdete i ve formuláři údržby. Operátory tagů navíc rozšiřují Does not equal a Does not contain. Následující příklad kombinuje vybraný trigger s podmínkou na název události; ID triggeru a časové údaje nahraďte vlastními:
{
  "jsonrpc": "2.0",
  "method": "maintenance.create",
  "params": {
    "name": "Ad-hoc: certificate renewal",
    "maintenance_type": 0,
    "active_since": 1788080400,
    "active_till": 1788084000,
    "triggers": [
      {
        "triggerid": "12345"
      }
    ],
    "event_names": [
      {
        "operator": 2,
        "value": "certificate expires"
      }
    ],
    "timeperiods": [
      {
        "timeperiod_type": 0,
        "start_date": 1788080400,
        "period": 3600
      }
    ]
  },
  "id": 1
}
Potlačení údržbou je vidět v historii události
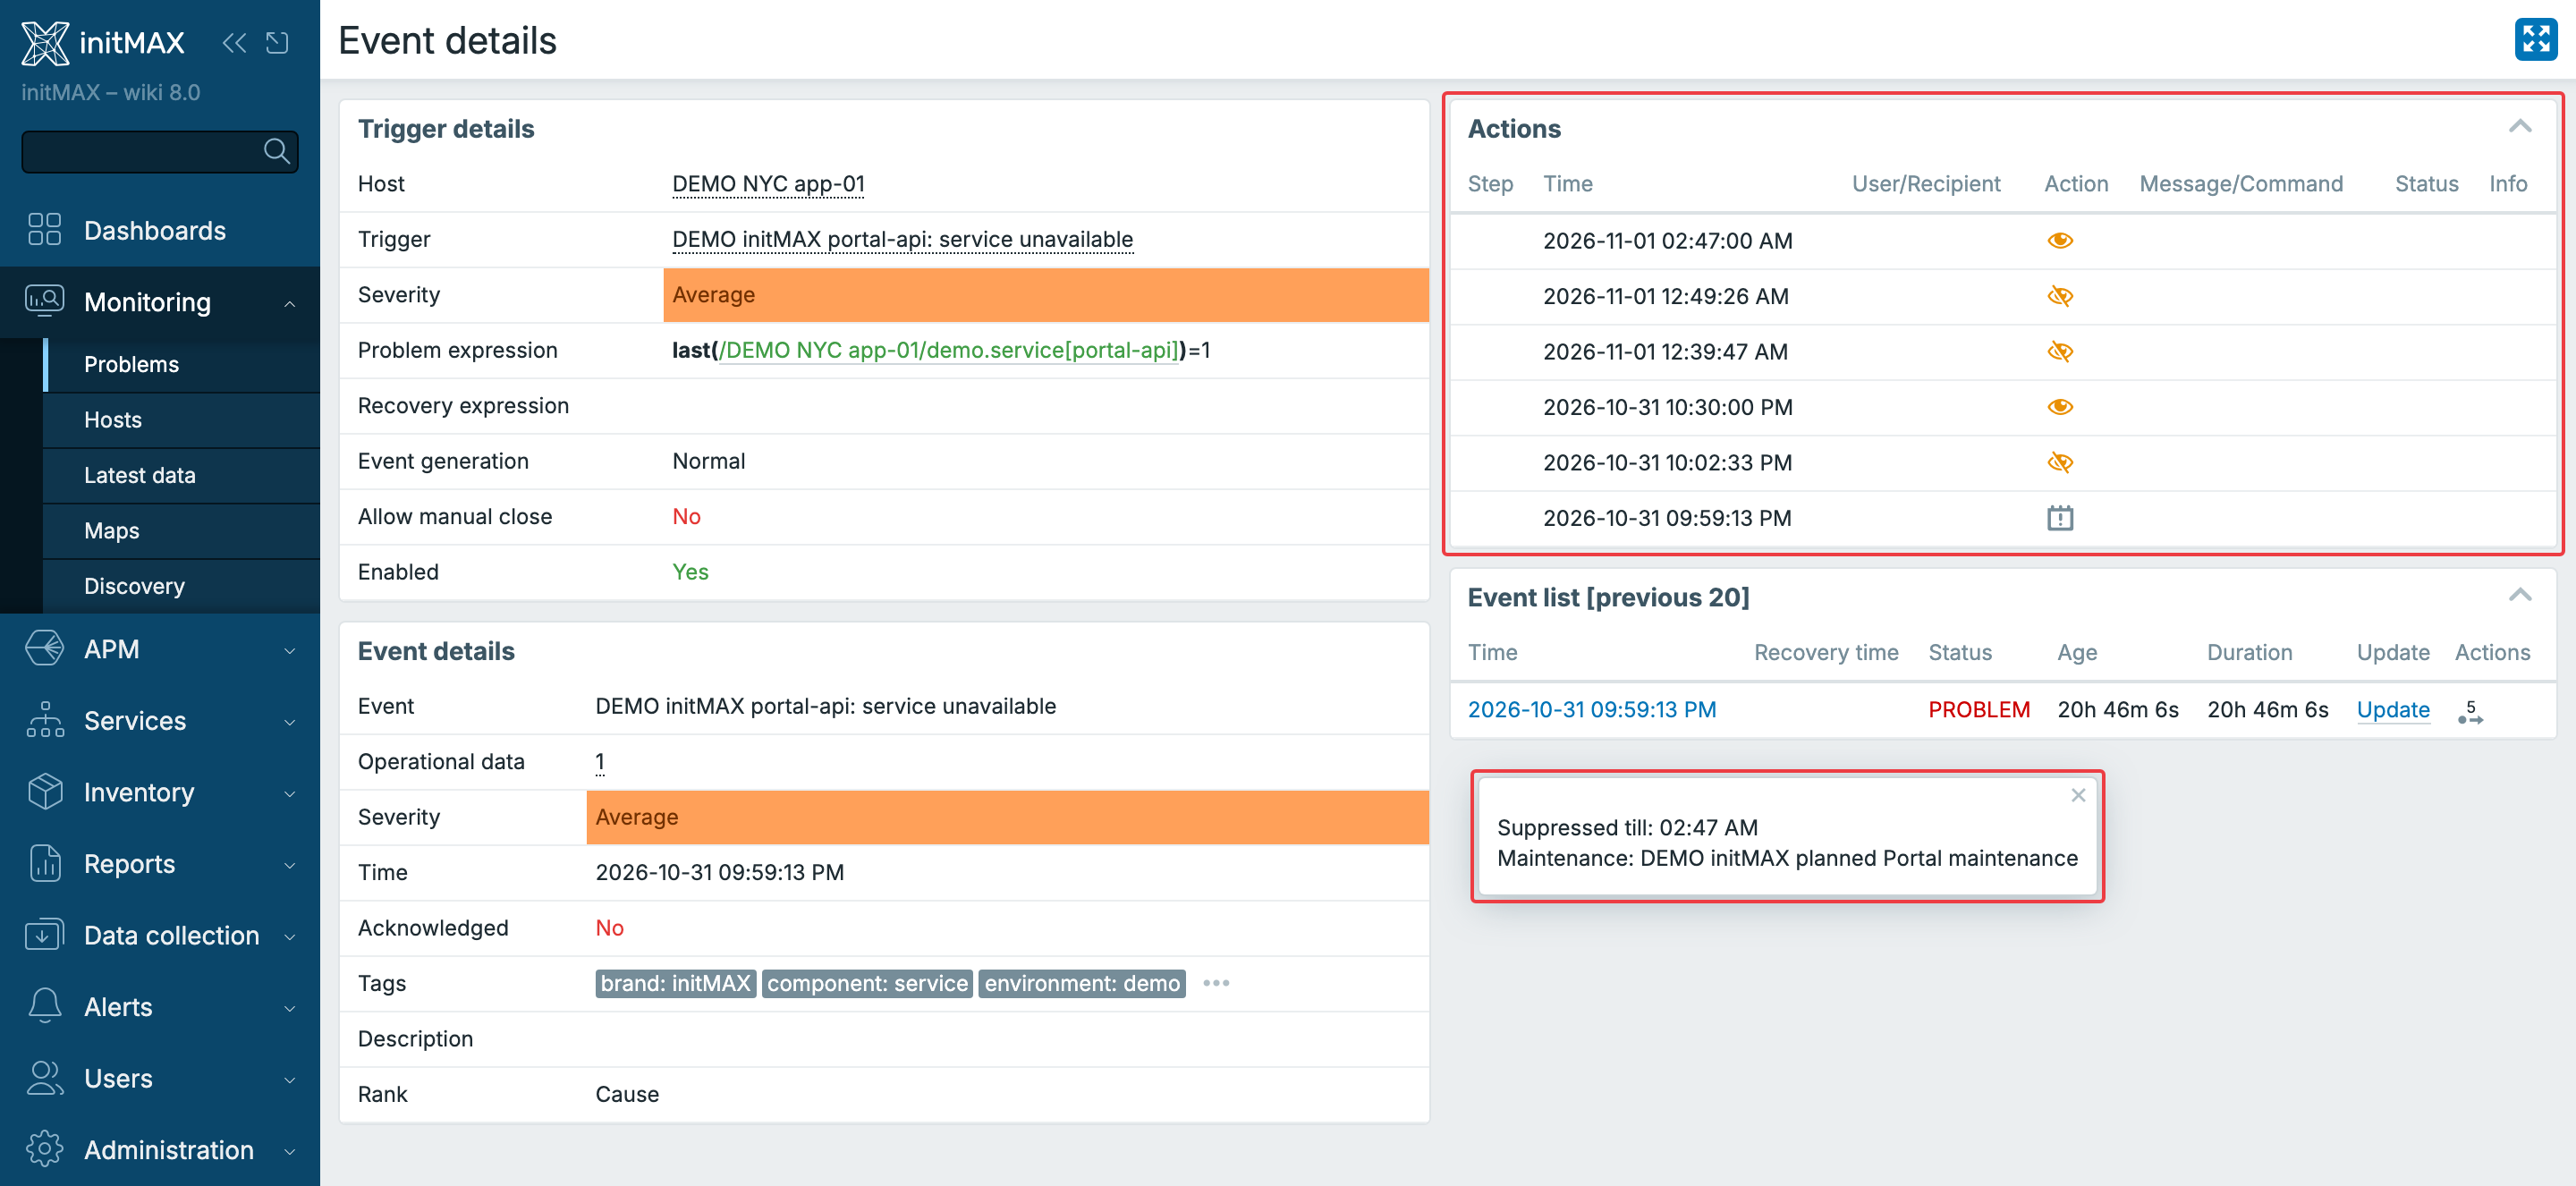
Doteď údržba problém tiše skryla a po jejím skončení nezbyla žádná stopa, proč konkrétní událost nevyvolala akci. Server v 8.0 zapisuje každé potlačení i odpotlačení údržbou jako záznam v historii události, spolu s údržbou, která ho způsobila, a časem, do kdy potlačení platilo. V Event details se objeví v sekci Actions jako ikona přeškrtnutého oka s nápovědou Suppressed till … / Maintenance: …, po skončení údržby přibude Unsuppressed by maintenance. Stejná informace je v API: event.get s selectAcknowledges vrací záznamy s action 512 (potlačeno) nebo 1024 (odpotlačeno), maintenanceid a suppress_until. Součástí změny je i přesnější zpracování překrývajících se údržeb a úprav běžící údržby.
Podmínka Proxy group v discovery a autoregistraci
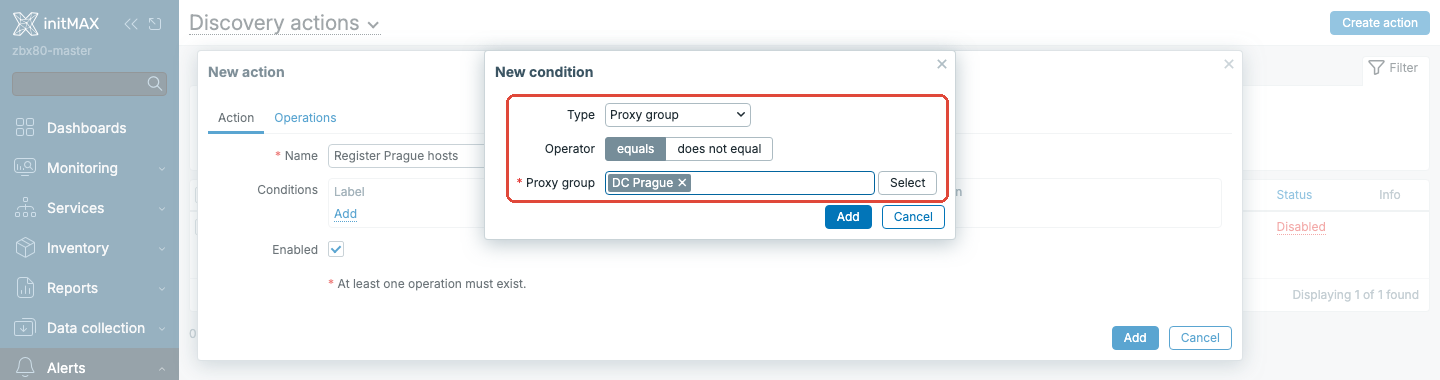
Akce síťového discovery a autoregistrace mají nový typ podmínky Proxy group (equals / does not equal). Kdo provozuje proxy skupiny per lokalita nebo per zákazník, může teď napsat akci „hosty přihlášené přes skupinu DC Prague zařaď do skupiny Prague a přilinkuj šablonu X“ bez vyjmenovávání jednotlivých proxy, a při přidání proxy do skupiny se nic nemusí měnit. Zároveň byla opravena podmínka Proxy v autoregistraci tak, aby se chovala stejně jako v discovery.
Co to znamená v praxi
Nastavte uživatelům rozumnou Default maintenance period a naučte operátory používat Suppress trigger místo vypínání triggerů, které se pak zapomenou zapnout. Při auditu incidentů si zvykněte otevřít Event details: záznam o potlačení údržbou je nový zdroj pravdy pro otázku, proč se neposlal alert. A v prostředích s proxy skupinami přepište discovery a autoregistrační akce z výčtu proxy na podmínku Proxy group.
Widget Scatter plot
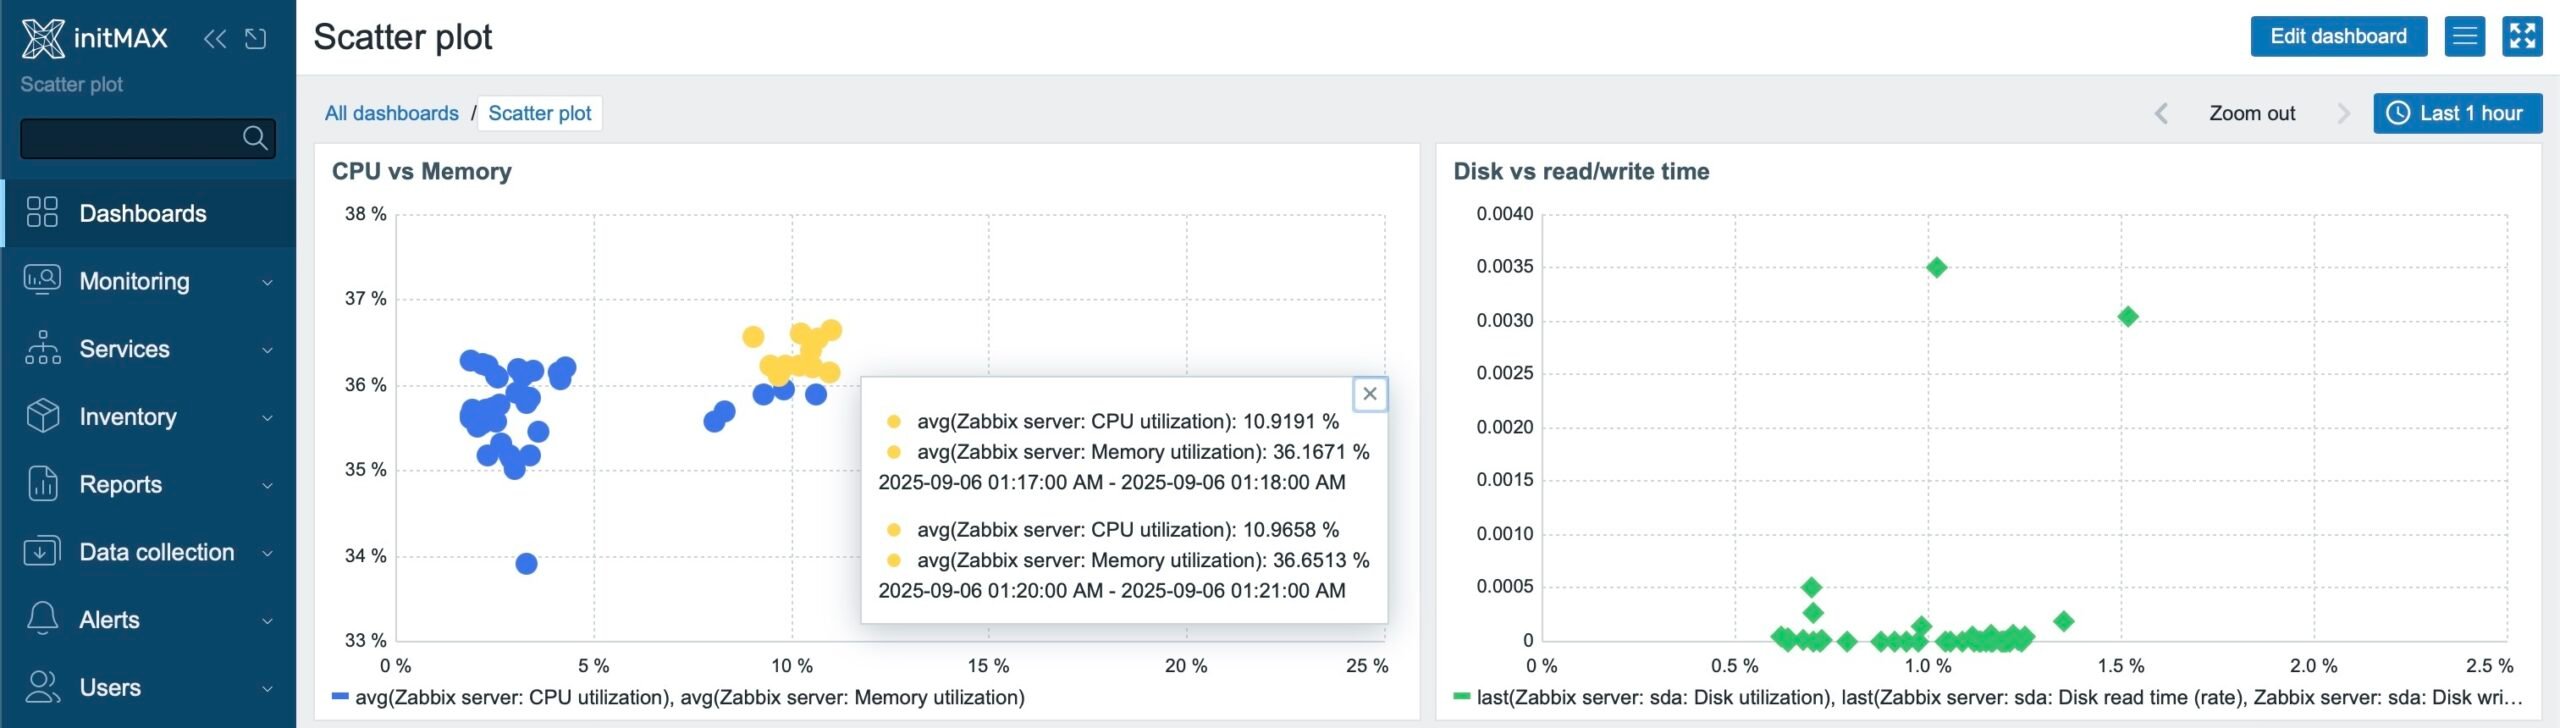
Jednoduše: vezmete dvě metriky (X a Y osa) a Zabbix vám pro každý host/časový úsek vykreslí body. Na jeden pohled tak uvidíte korelaci (nebo naopak její chybění), shluky problémových strojů a anomálie, které v klasickém časovém grafu snadno zaniknou.
Přínosy
- Vztahy metrik: např. „když roste CPU, roste i RAM?“
- Outliery: rychlá detekce vyčnívajících serverů.
- Vizuální triáž: okamžitá priorita, kam se dívat.
Jak funguje
- Datasety: více sad; každá má X‑Axis item a Y‑Axis item.
- Filtrování hostů: Host patterns / Host groups / Host tags.
- Agregace: Aggregation interval (např. 1m) + funkce (např. avg) → jeden bod/okno.
- Vzhled: volba markeru a velikosti; tooltips s hodnotami; time shift pro srovnání období.
Prahy (thresholds)
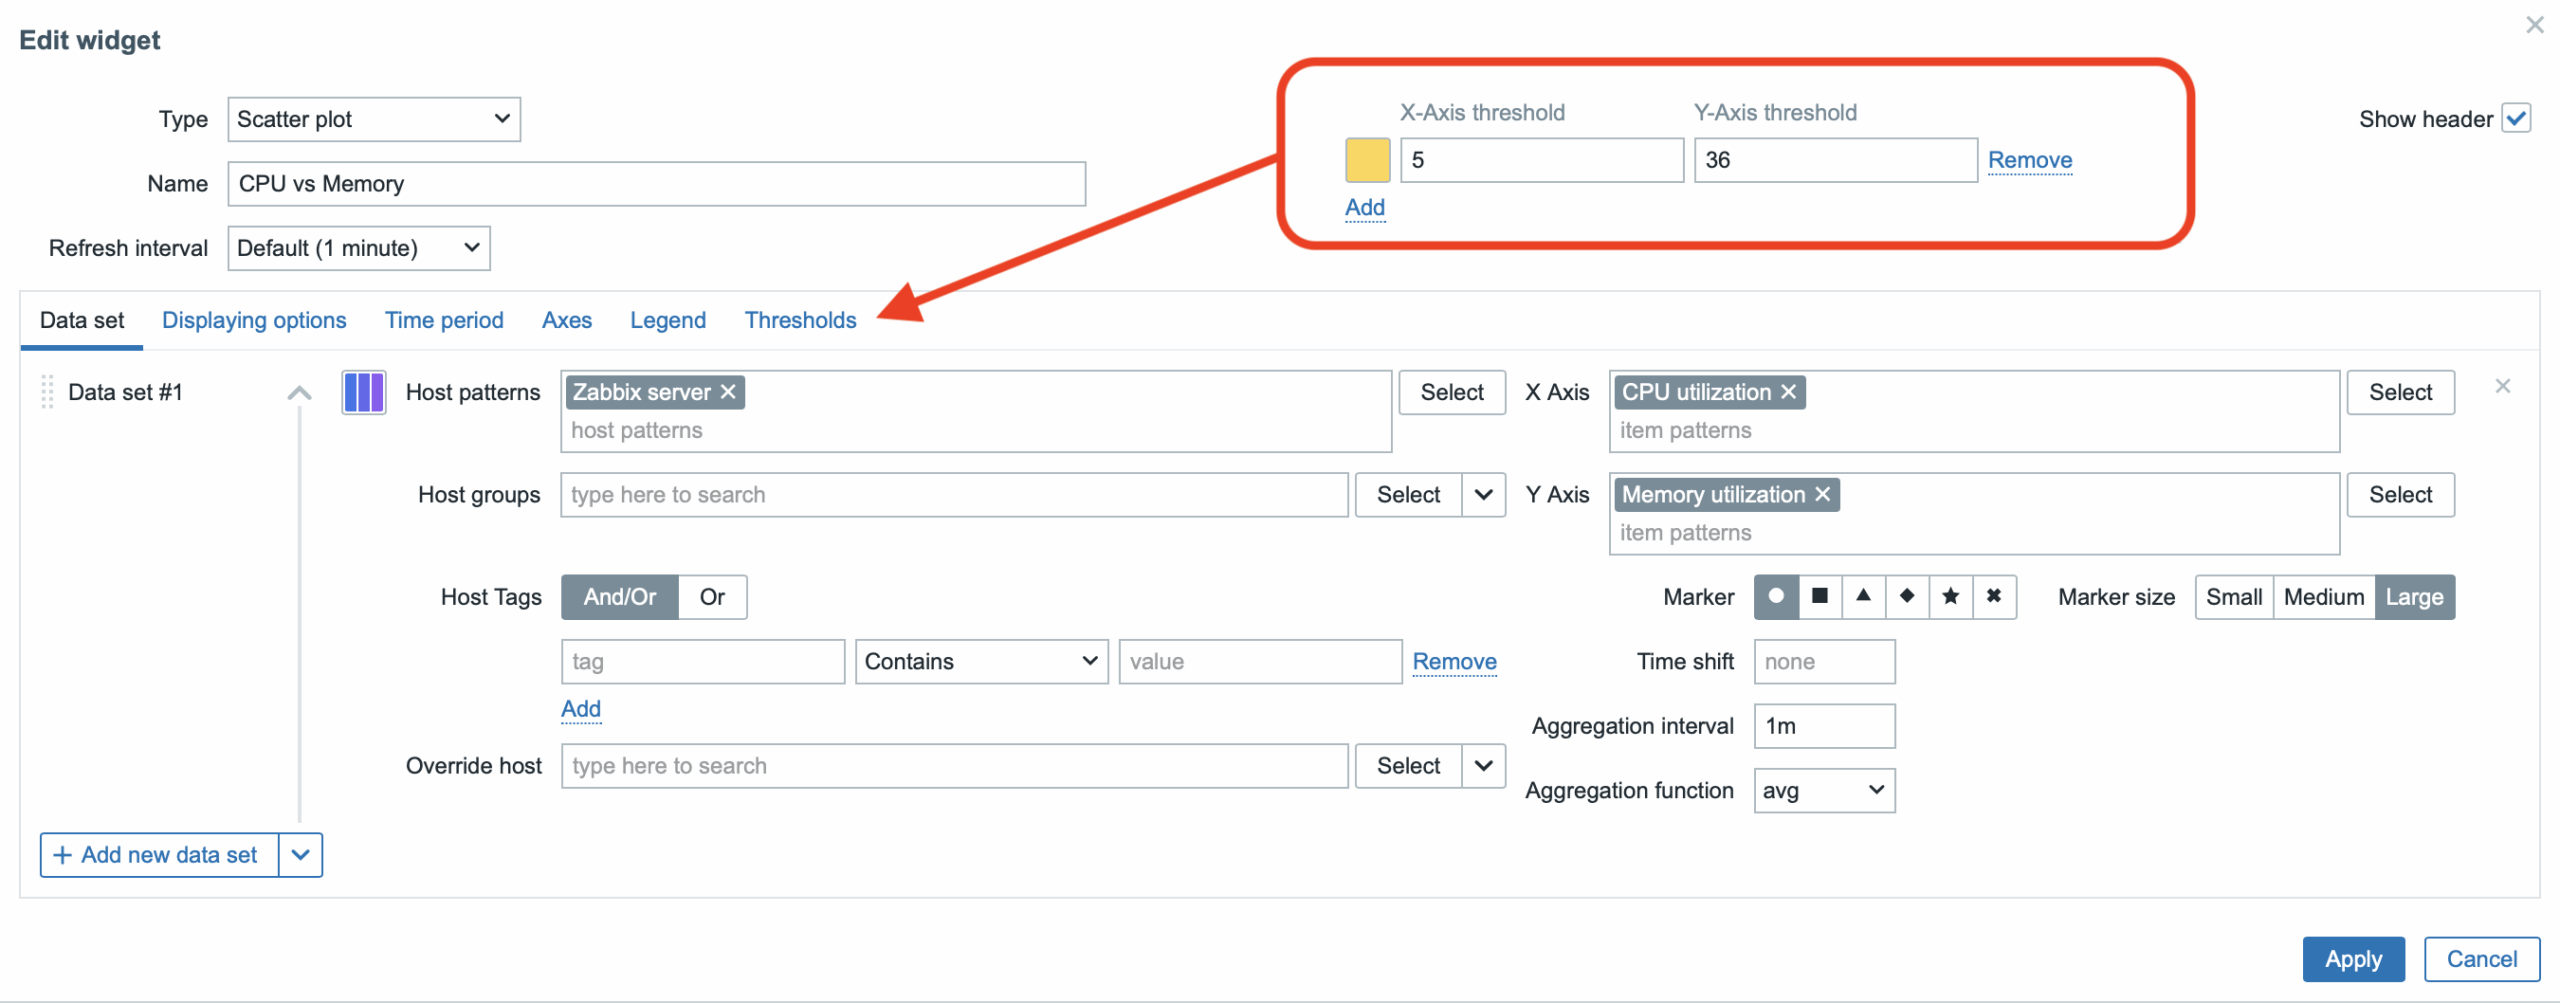
Kombinované podmínky pro X a Y mění barvu bodu, např. X ≥ 5 AND Y ≥ 36. Více pravidel = více barev → anomálie jsou okamžitě viditelné. (Na obrázku)
Příklady scénářů
- CPU load vs. Memory usage
Osa X: průměrné zatížení CPU
Osa Y: procento obsazené RAM
→ Hned vidíte, jestli hosty s vysokým CPU mají i vysokou RAM zátěž. Skvělá první diagnostika „CPU bound“ vs. „RAM bound“. - Disk usage vs. I/O latency
Osa X: procento využití disku
Osa Y: odezva (ms)
→ Odhalí servery s přetíženým storage. Kombinace vysoké využití + vysoká latence je červená vlajka pro I/O. - Network traffic vs. Error rate
Osa X: odchozí / příchozí traffic (bps)
Osa Y: chybovost (dropped packets, errors)
→ Najdete stroje, které sice nemají velký provoz, ale mají hodně chyb – typicky špatné linky, duplex, MTU, driver. - Response time vs. Availability (služby / aplikace)
Osa X: průměrný response time (ms)
Osa Y: procento dostupnosti (%)
→ Rozliší „pomalé, ale stabilní“ vs. „rychlé, ale nespolehlivé“ služby. Strategický pohled pro prioritizaci práce týmu.
ClickHouse backend a výrazná vylepšení pro Elastic
Velkou novinkou je podpora ClickHouse databáze jako volitelného úložiště pro historická data. Hlavní motivací je bezesporu propojení s novou podporou JSON typu dat – právě u takového objemu a struktury dat dává analytický backend typu ClickHouse perfektní smysl.
Koncept i konfigurace jsou velmi podobné tomu, co už řada z vás zná z volitelného napojení na Elastic. Zabbix tak může historická data ukládat do alternativního backendu bez zásahu do základní architektury. Do ClickHouse lze ukládat všechna historická data kromě typu BIN, což pokrývá drtivou většinu běžných i pokročilých use-casů.
Typy historie lze rozdělit mezi ClickHouse, Elasticsearch a hlavní SQL databázi. V následujícím příkladu používáme stejné rozdělení ve frontendu i na serveru:
- ClickHouse:
uint,dbl,log,textajson. - Elasticsearch:
str, tedy typ Character. - Hlavní SQL databáze: binární historie
bin; konfigurace Zabbixu v ní zůstává i při použití externích history providerů.
Jde o příklad, nikoli povinné rozdělení. Typy zvolte podle zátěže a požadavků na provoz; každý typ historie přiřaďte nejvýše jednomu externímu provideru.
Frontend konfigurace (Zabbix UI / frontend)
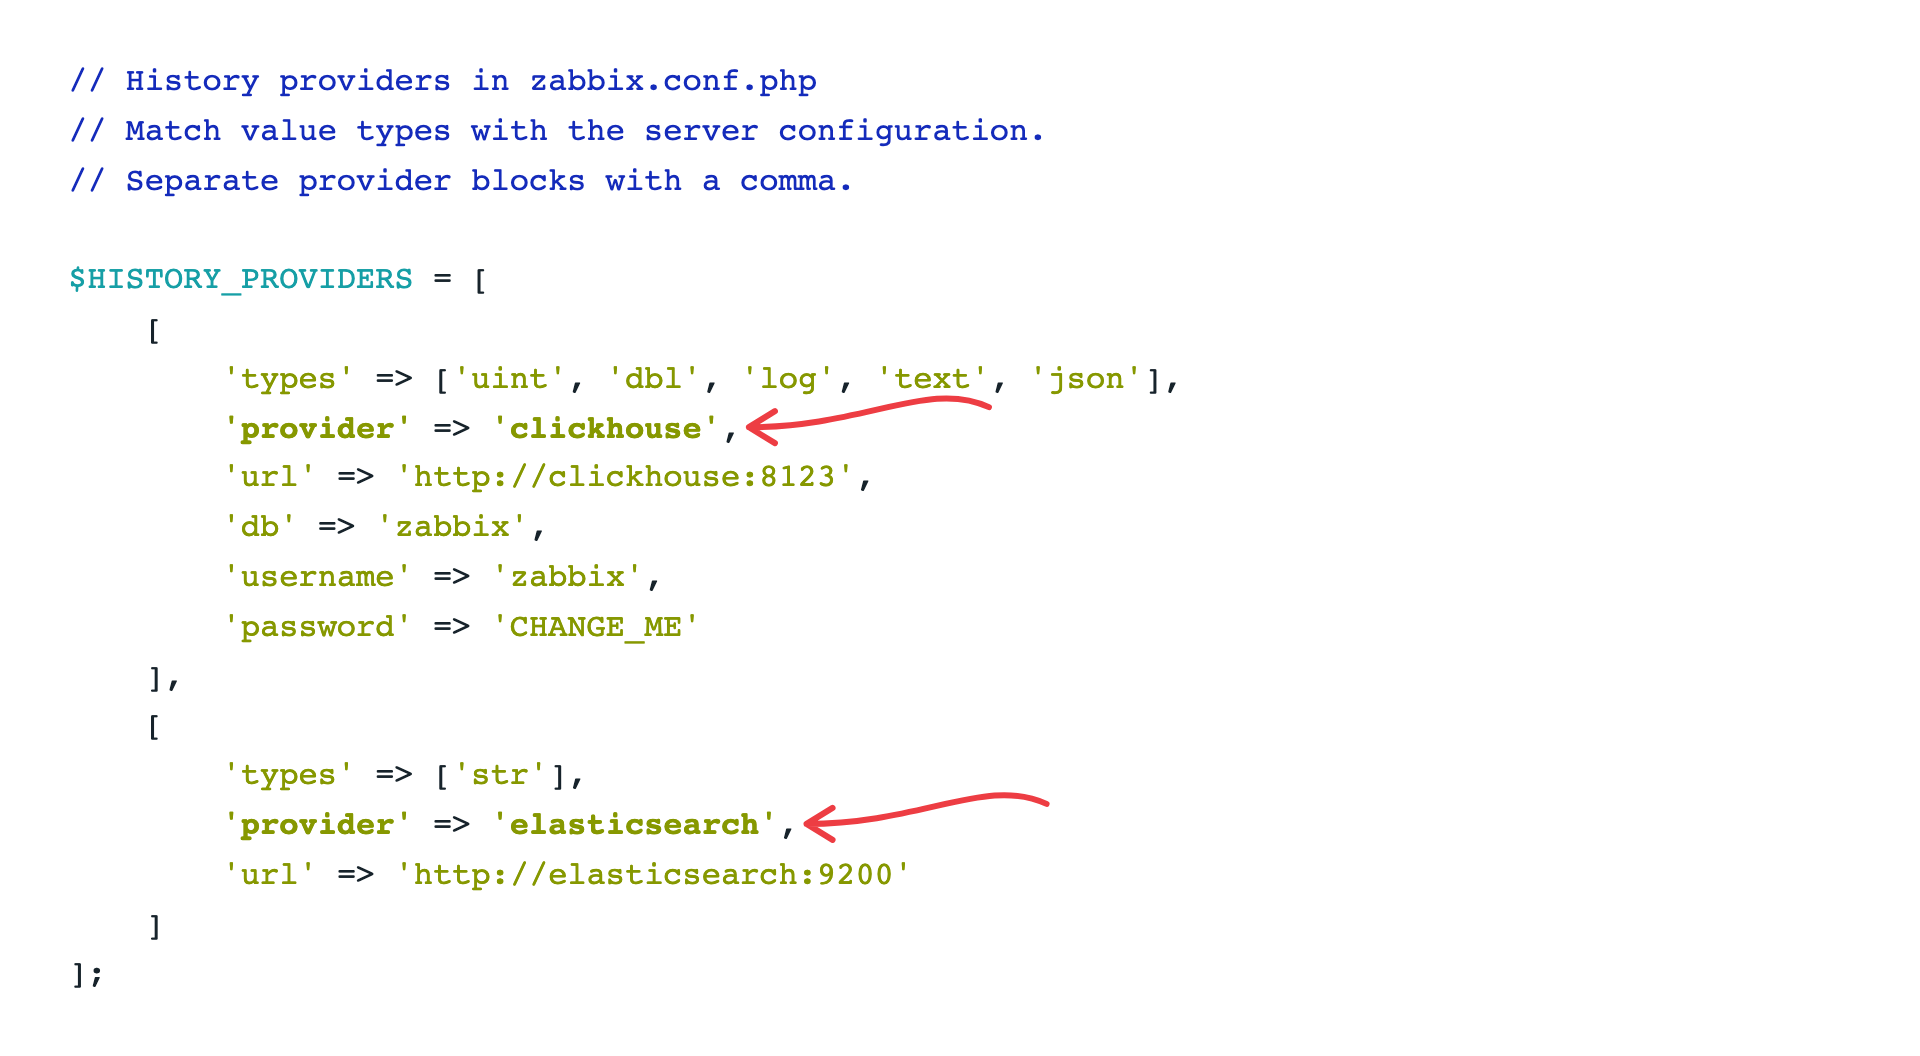
Konfigurace ve frontendu je definovaná v /etc/zabbix/web/zabbix.conf.php pomocí pole $HISTORY_PROVIDERS. Každý backend tvoří samostatnou položku pole; bloky jsou proto oddělené čárkou podle standardní PHP syntaxe.
V této ukázce je jako první ClickHouse pro uint, dbl, log, text a json. Následuje Elasticsearch pro str, tedy typ Character. Jde o zvolené rozdělení, nikoli omezení backendů: oba umějí i ostatní uvedené typy, ale jeden typ nelze současně přiřadit dvěma providerům. Stejné rozdělení musí být nastavené i na Zabbix serveru.
Binární hodnoty (bin) nelze ukládat přes tyto providery do ClickHouse ani Elasticsearch. Zůstávají v primární SQL databázi Zabbixu. Formát přenosu RowBinary u ClickHouse není podporou binárního typu položky.
Server konfigurace (Zabbix server)
Druhá část nastavení je pak v /etc/zabbix/zabbix_server.conf, kde se jednotlivé providery definují samostatně po řádcích jako opakovaná direktiva HistoryProvider. Na rozdíl od frontendu nejde o “seznam položek”, ale o konfiguraci ve stylu provider;options, přičemž samotné volby (url=..., db=..., username=...) jsou oddělené čárkami.
HistoryProvider=clickhouse;value_types="uint,dbl,log,text,json",url=http://clickhouse:8123,db=zabbix,username=zabbix,password=CHANGE_ME
HistoryProvider=elasticsearch;value_types=str,url=http://elasticsearch:9200
Použití externího backendu ověřte také v Zabbix server logu. Při startu server vypíše název history provideru a detekovanou verzi, například pro ClickHouse následující zprávy. Rozdělení datových typů porovnejte s value_types v konfiguraci a ověřte skutečný zápis i čtení dat; samotný záznam v logu takový test nenahrazuje.
retrieving history provider "clickhouse" information
history provider "clickhouse" version "26.8.17.4"
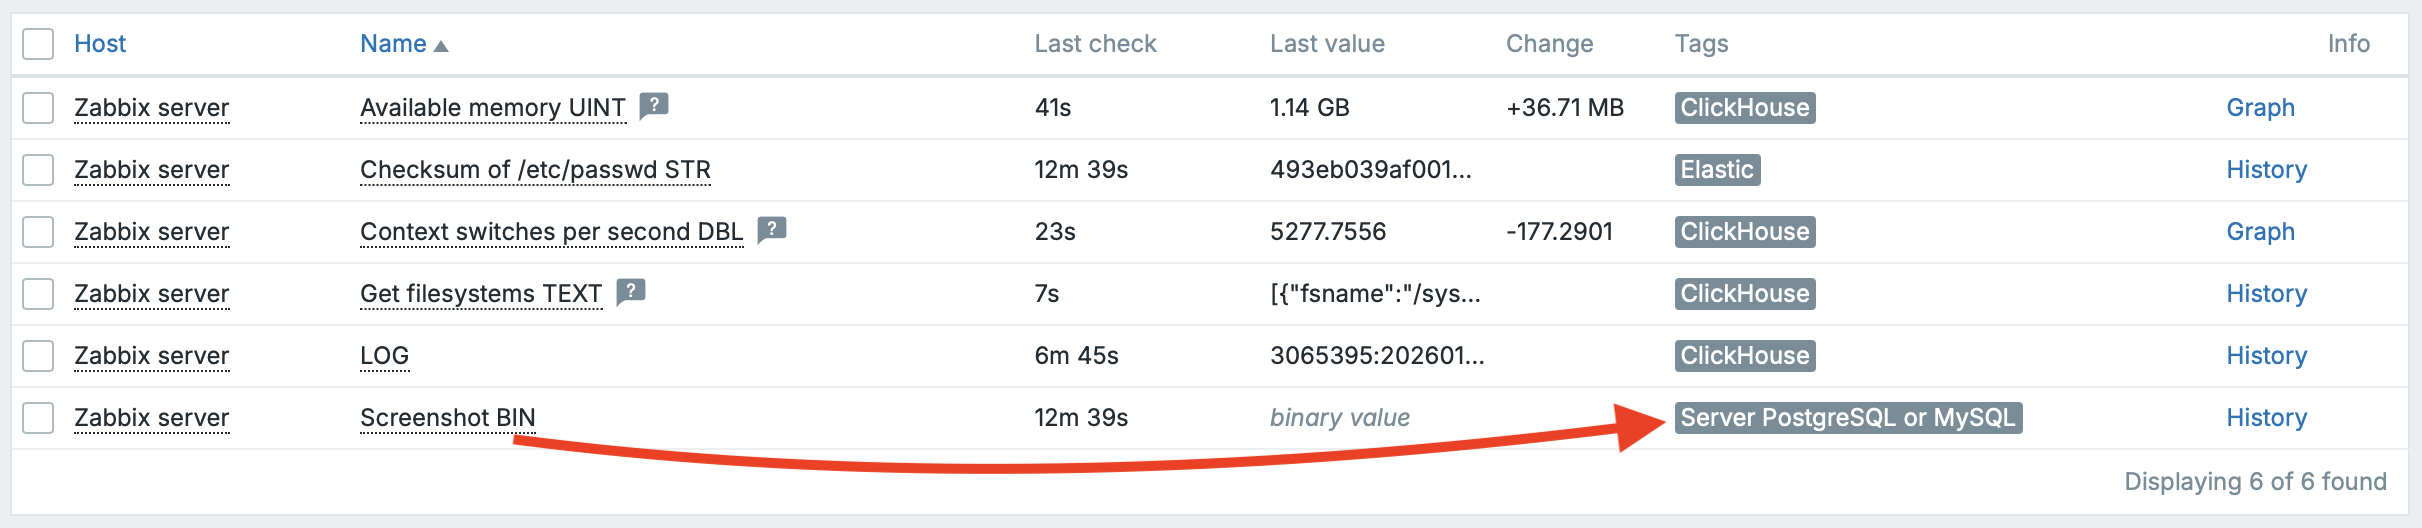
Data pak ve frontendu vypadají úplně stejně – z pohledu UI není žádný rozdíl mezi tím, zda jsou historická data uložená v PostgreSQL, ClickHouse nebo Elasticu. Zabbix transparentně zobrazuje poslední hodnoty, historii i grafy bez ohledu na použitý backend; výjimkou jsou pouze BIN hodnoty, které zůstávají uložené v primární databázi serveru (PostgreSQL/MySQL).
ClickHouse podporuje i clusterové schéma. Schema skripty přijímají --cluster a vytvářejí lokální tabulky a nad nimi Distributed tabulky. Běžná historie se rozděluje podle itemid; u APM traces je shardovací klíč odvozený od TraceId, aby spany jednoho trace směřovaly společně. Zabbix umí zjistit TTL i přes distribuovanou tabulku. Dostupnost Keeperu, replikace, stabilní přístupový bod a zálohování ale zůstávají součástí návrhu databáze, nikoli automatickým důsledkem přepínače --cluster.
ClickHouse zde není v dokumentaci označený jako experimentální integrace. Jde o jiné úložiště než Elasticsearch. Podporovaný rozsah běžné historie je 26.3.0.0–26.9.x.x; pro APM telemetrii je minimum přísnější, 26.8.17.4. ClickHouse nenahrazuje hlavní konfigurační databázi Zabbixu.
Elasticsearch
Zabbix 8.0 podporuje Elasticsearch 8.0 až 9.5.x pro ukládání historie. Tato podpora již není experimentální. Při upgradu ověřte, že verze backendu odpovídá aktuálním požadavkům Zabbixu, a zkontrolujte konfiguraci připojení.
Elasticsearch backend upravuje síťovou komunikaci a více využívá opakované použití spojení (connection reuse). Tím snižuje režii navazování spojení; skutečný dopad na výkon závisí na dotazech, objemu dat a konkrétním nasazení.
Multi-host connection string pro PostgreSQL backend
Za nás je toto jedno z nejlepších praktických vylepšení pro PostgreSQL backend vůbec. Možnost zadat do DBHost více host:port adres v jednom řetězci (oddělených čárkou) a nechat Zabbix, aby si při startu sám našel první dostupný read-write uzel, výrazně zjednodušuje nasazení i provoz – hlavně v HA prostředích. V praxi to často znamená méně závislostí na externím load balanceru a elegantnější, “self-contained” konfiguraci přímo v Zabbixu.
DBHost=pg-primary.example.com:5432,pg-secondary.example.com:5432
DBName=zabbix
Více databázových uzlů umí použít i frontend. V $DB['SERVER'] lze uvést seznam host:port; při více adresách přidává PostgreSQL backend frontendu target_session_attrs=read-write a timeout připojení. Je tedy potřeba rozlišovat přímé připojení k PostgreSQL od připojení přes pooler.
Pokud frontend používá lokální PgBouncer s transaction poolingem, musí správný zapisovatelný uzel vybrat i PgBouncer. Samotná změna Zabbixu tento krok nevyřeší. Sledujeme proto upstream PR #1534: podpora target_session_attrs v PgBounceru, který výběr backendu řeší. Návrh zatím není sloučený ani vydaný; do té doby je třeba zachovat funkční směrování na primary, například přes VIP, load balancer nebo odpovídající HA integraci.
Nová možnost ukládání dat ve formátu JSON
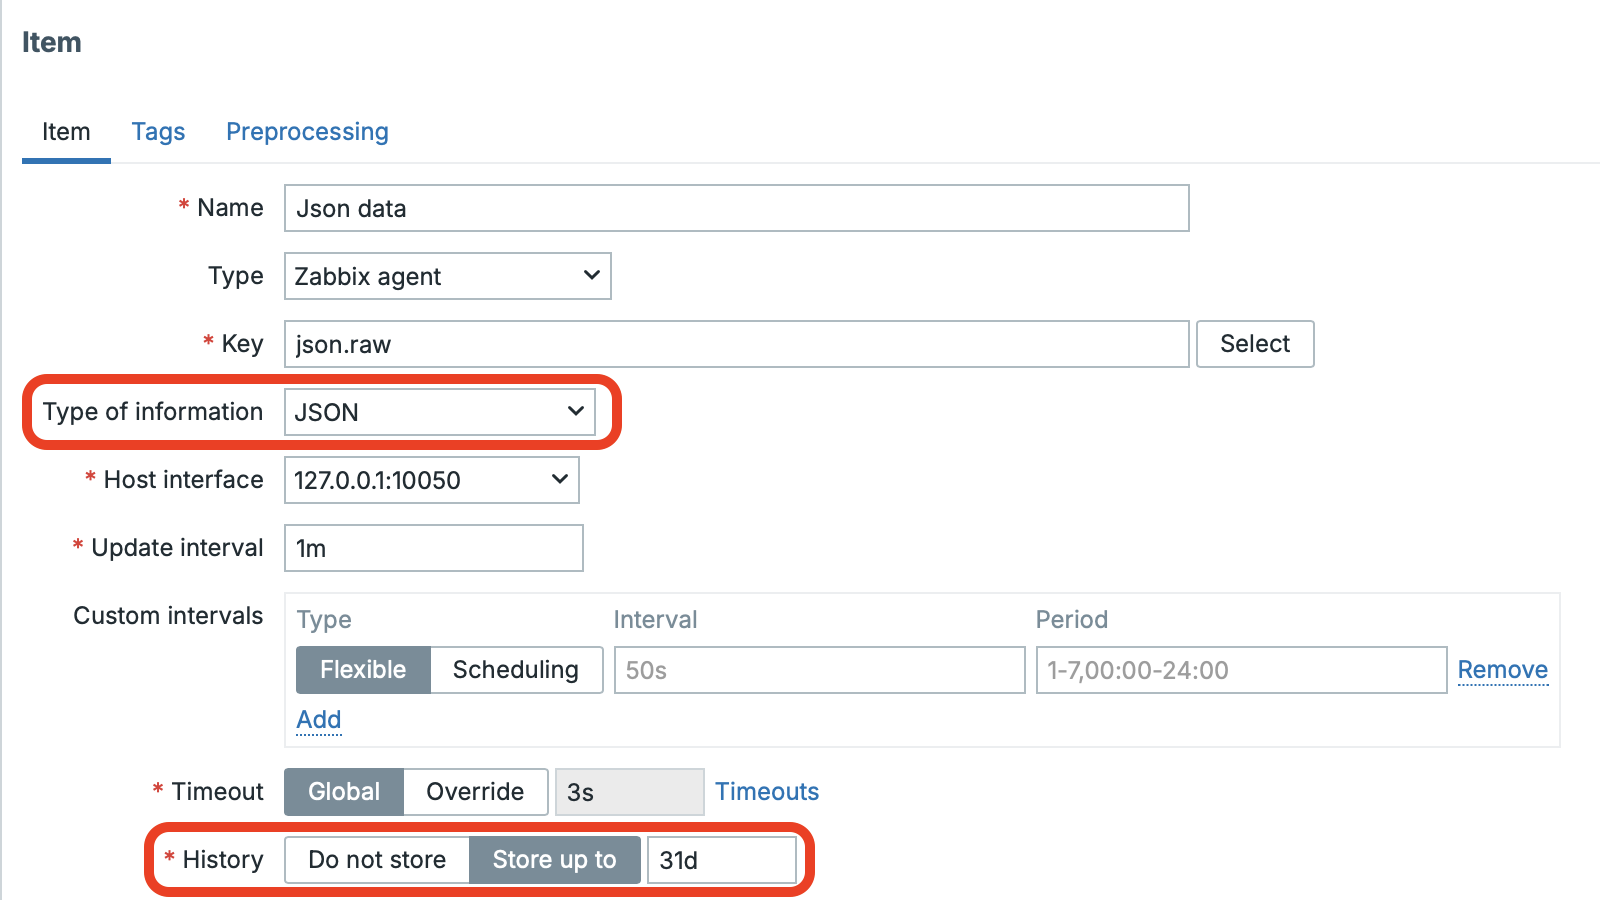
Zabbix nově ukládá hodnoty položek také v typu JSON, na serveru i proxy. JSON už nemusí být jen řetězec v textové položce. Neplatný JSON se odmítne; podporované jsou položky a prototypy položek s výjimkou typu Calculated. U TimescaleDB je při upgradu potřeba ručně nakonfigurovat hypertabulku history_json. Podporu ukládání JSON má také Elasticsearch.
Typ JSON lze použít u master i závislých položek. Z jednoho masteru tak můžete uchovat celý dokument a zároveň vybrat jednotlivé hodnoty do dalších položek.
Primární využití vidíme u velkého množství master itemů. Maximální velikost takto uložených dat v rámci jednoho zápisu je 128 MiB.
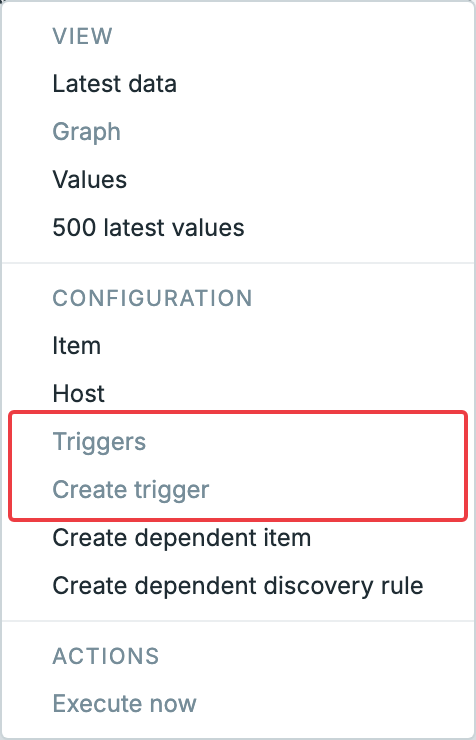
Stejně jako u typu Binary nelze nad položkou typu JSON vytvářet přímo triggery. Potřebné hodnoty vyberte preprocessingem do závislých číselných nebo textových položek; nad těmito položkami už lze triggery používat.
Přibyl Export a Import dashboardů
Konečně přibyla i možnost exportu a importu dashboardů. Podobnou věc jste sice mohli řešit už přes API, ale bylo potřeba přesně namapovat jednotlivé entity podle jejich ID – jinak import neproběhl.
Teď máte v rozhraní k dispozici dvě tlačítka: jedno pro Export (ve formátu, jak ho ze Zabbixu znáte) a druhé pro Import.
Tlačítko Import najdete v pravém horním rohu přehledu dashboardů, hned vedle Create dashboard.
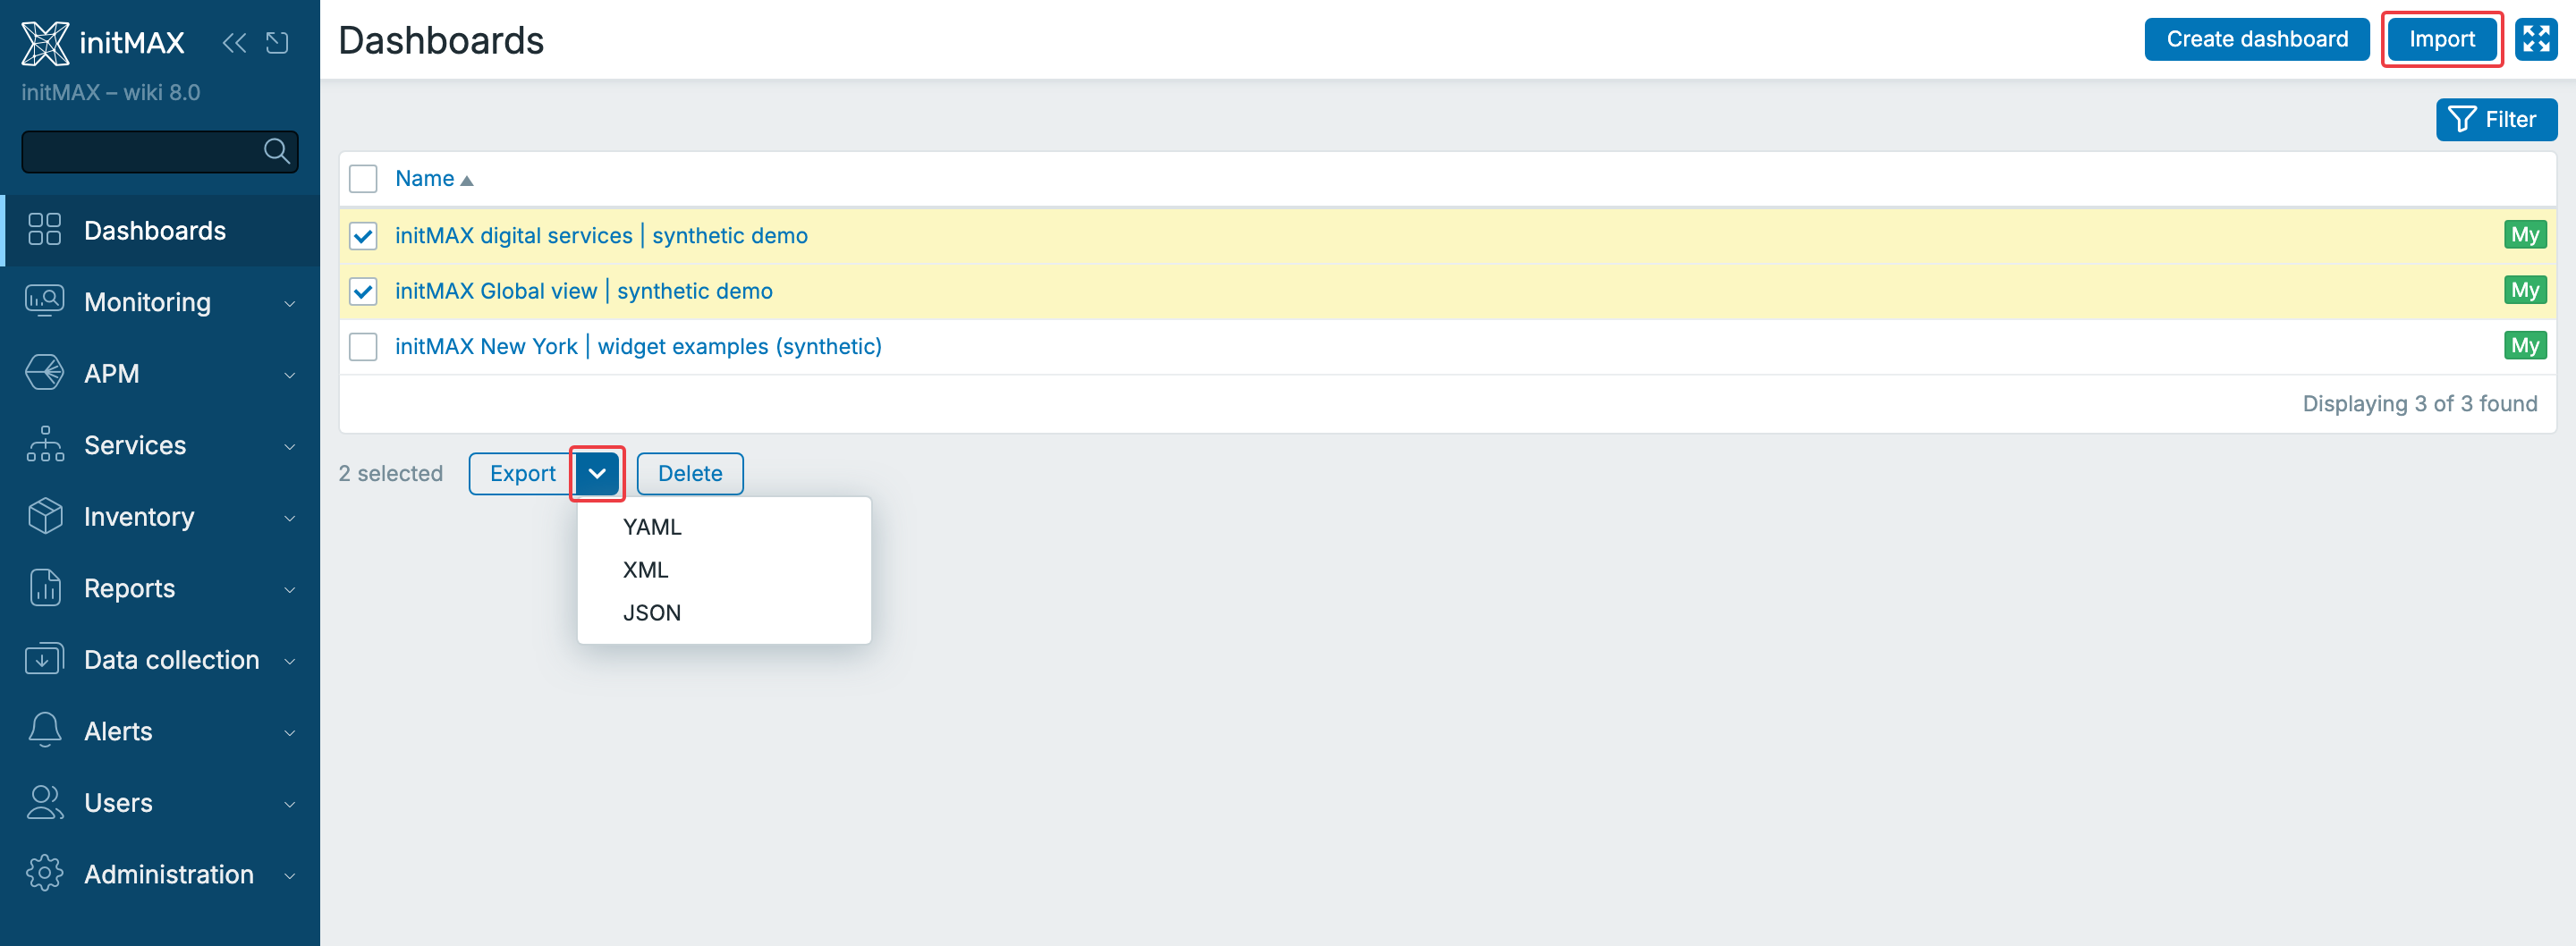
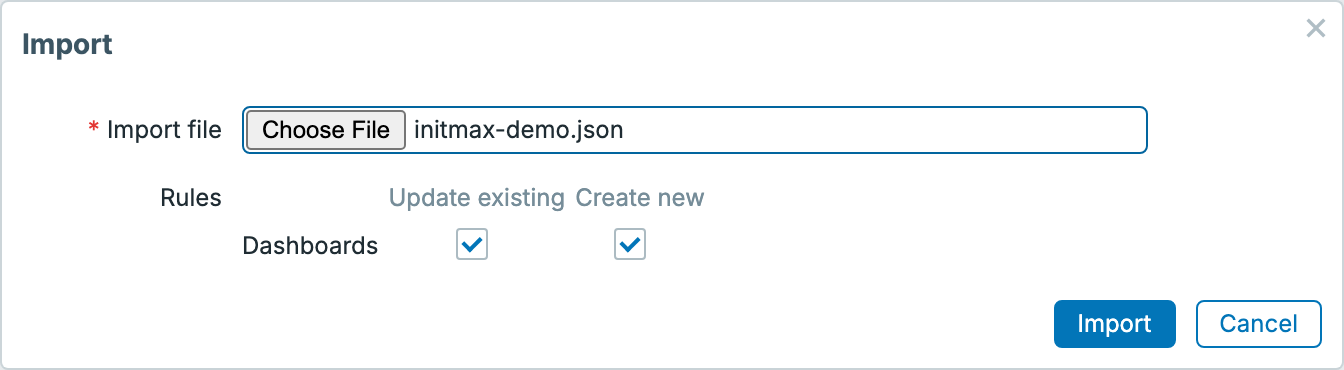
Samotný import je intuitivní: můžete vytvářet úplně nové dashboardy a pokud už existují, můžete aktualizovat ty stávající. Import samozřejmě umí přenést i stránky (pages), pokud je v dashboardech používáte.
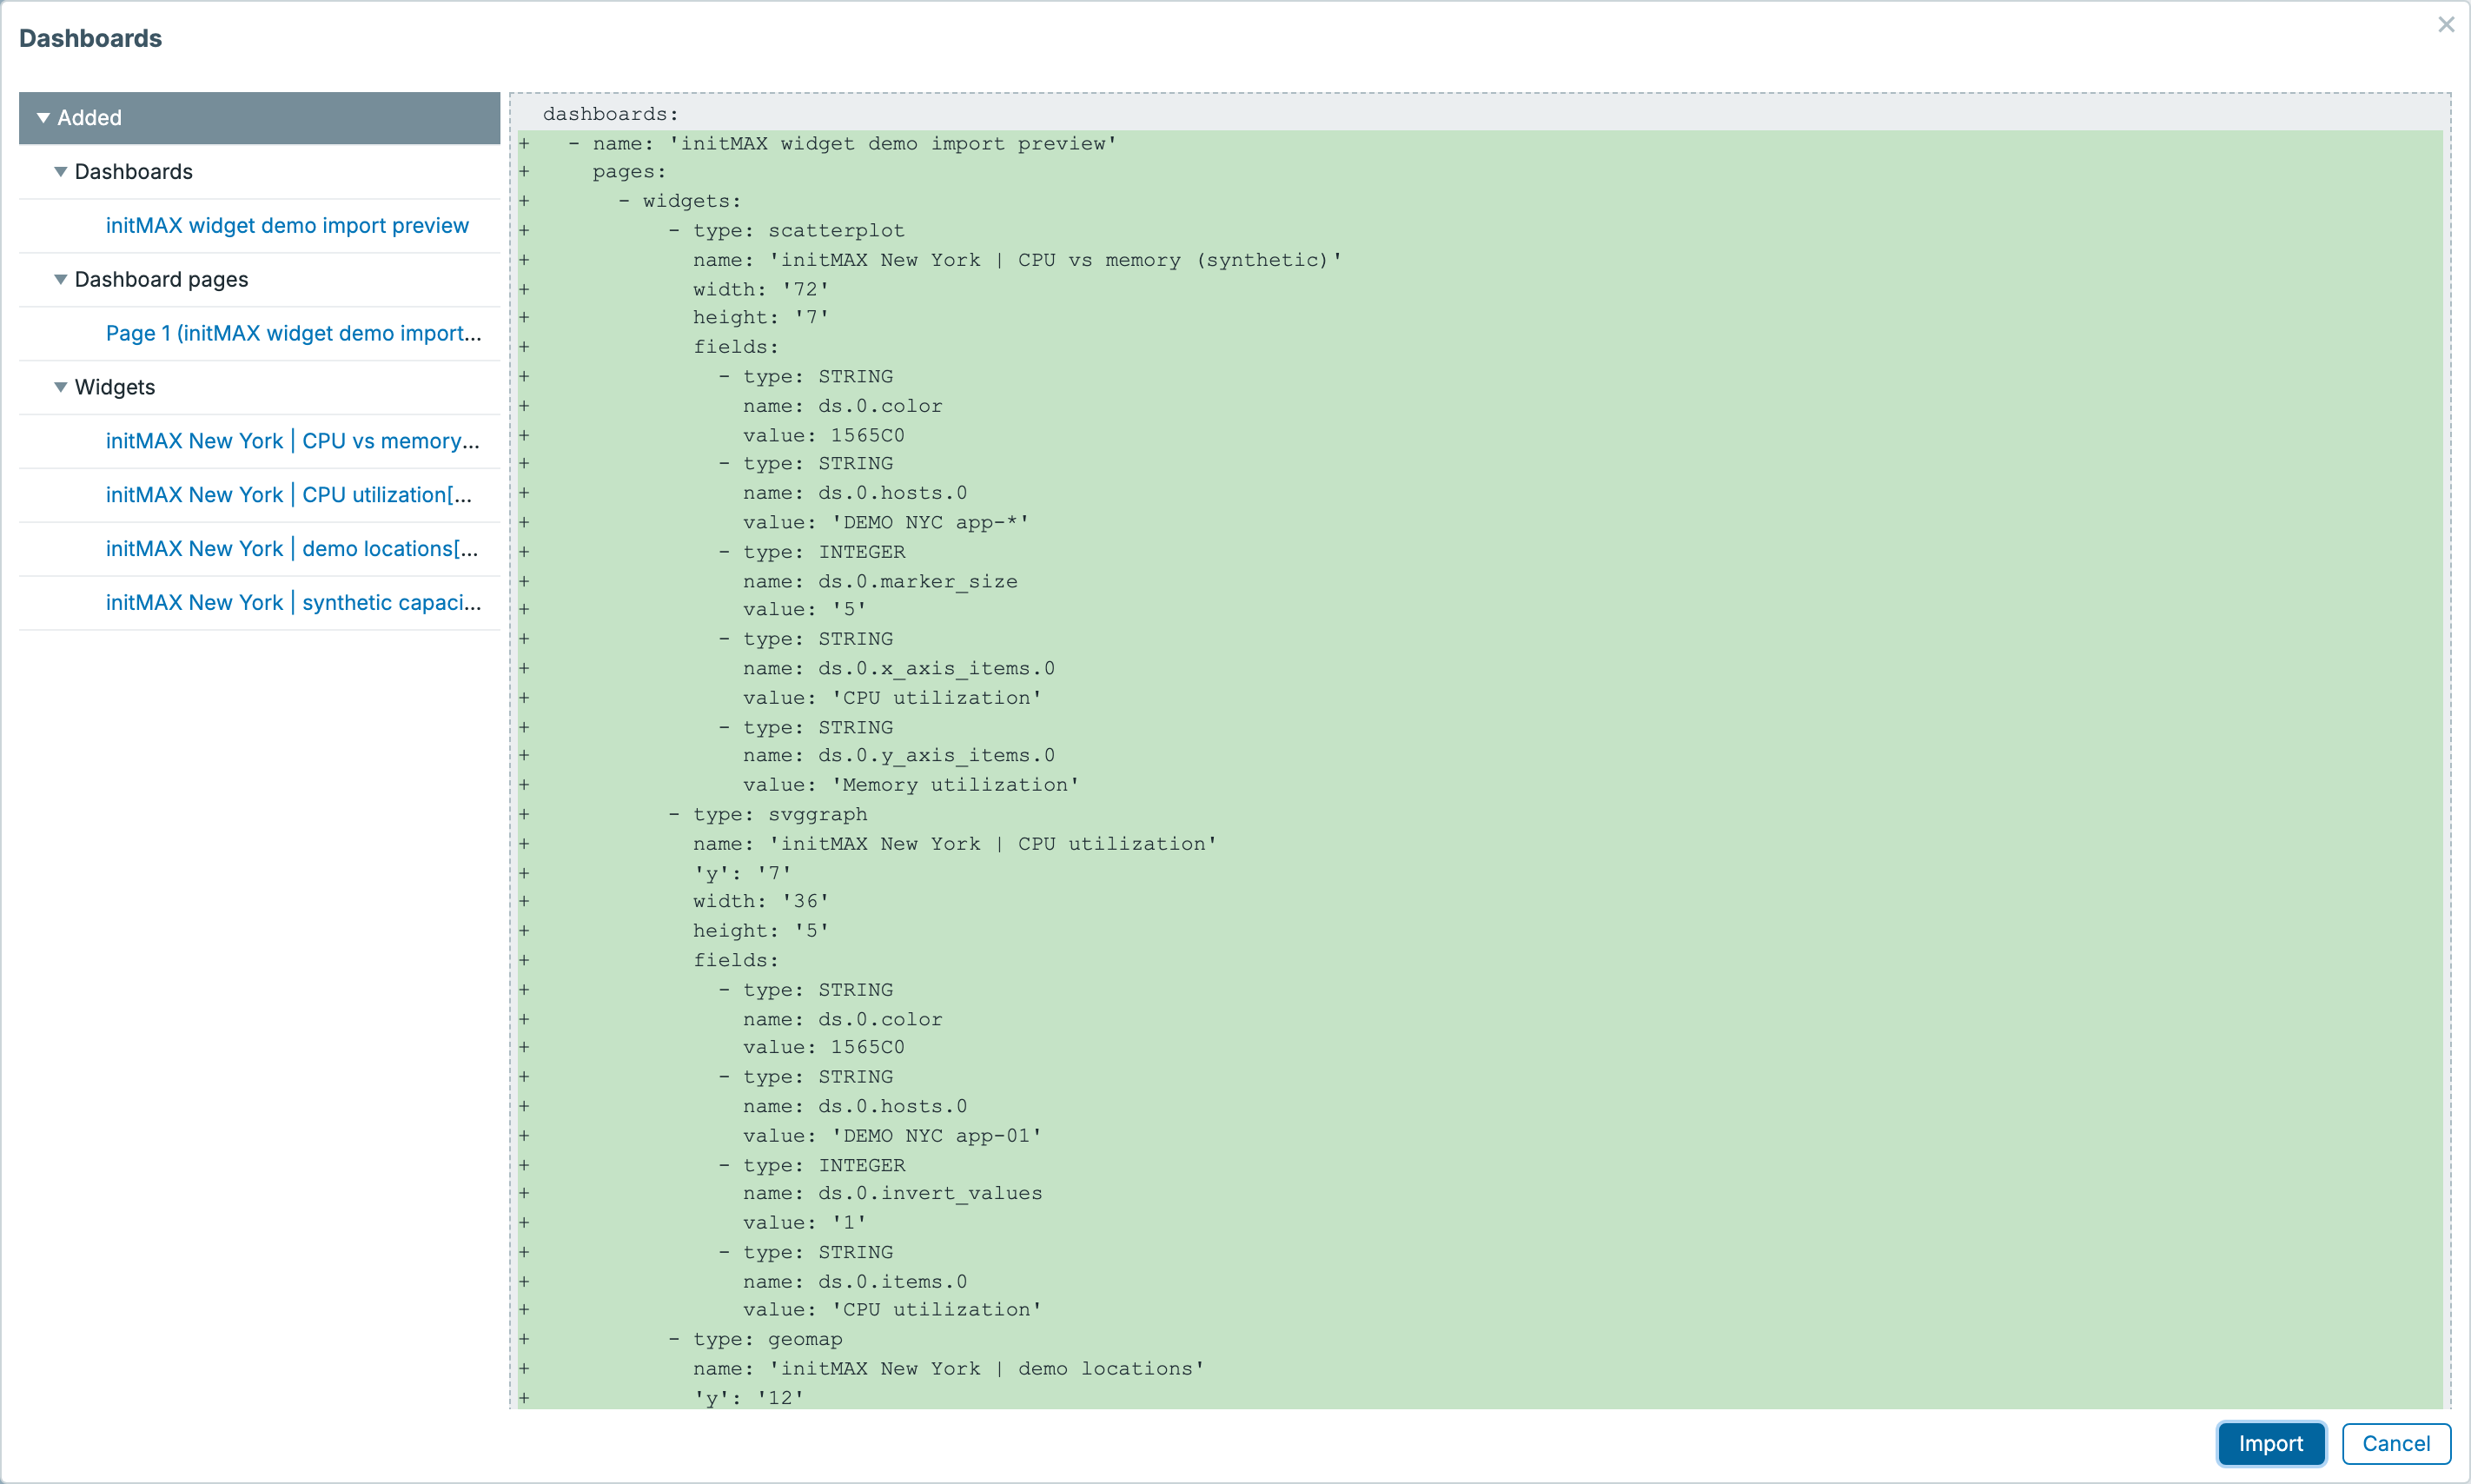
Před samotným importem navíc uvidíte přehled, které části se přidají, které se smažou a které se aktualizují – a to včetně konkrétních změn.
Při importu globálních dashboardů se hosty dohledávají podle technického názvu a položky podle hosta a klíče, nikoli podle původních ID. Nenalezené odkazy na hosty a položky import vynechá. Pokud projde ostatními kontrolami, dashboard se uloží, platné vazby zůstanou zachované a Zabbix zobrazí upozornění na vynechané reference.
V naší syntetické ukázce odkaz míří na neexistující DEMO NYC app-01 RENAMED. Import se skutečně dokončil a zobrazil hlášku na následujícím obrázku. Dotčené widgety zůstaly bez vazby na položky a je nutné je překonfigurovat; nestačí tedy zkontrolovat jen zelené potvrzení úspěchu.
Neznamená to, že projde libovolný chybný import. Neplatný formát nebo nedostatečná oprávnění jej mohou dál zastavit. Dashboardy uvnitř šablon se navíc importují jinou cestou a chybějící reference nadále odmítají.

Clustering v GeoMap widgetu
Ve widgetu GeoMap lze nastavit shlukování hostů. Režim Auto seskupování řídí automaticky; v režimu Zoom level určujeme úroveň přiblížení, od které se shlukování vypne. Při hodnotě 8 se od zoomu 8 zobrazují jednotlivé markery. Snížení hodnoty na 5 je tedy rozbalí dříve, už při menším přiblížení. Vyšší hodnota naopak zachová shluky déle.
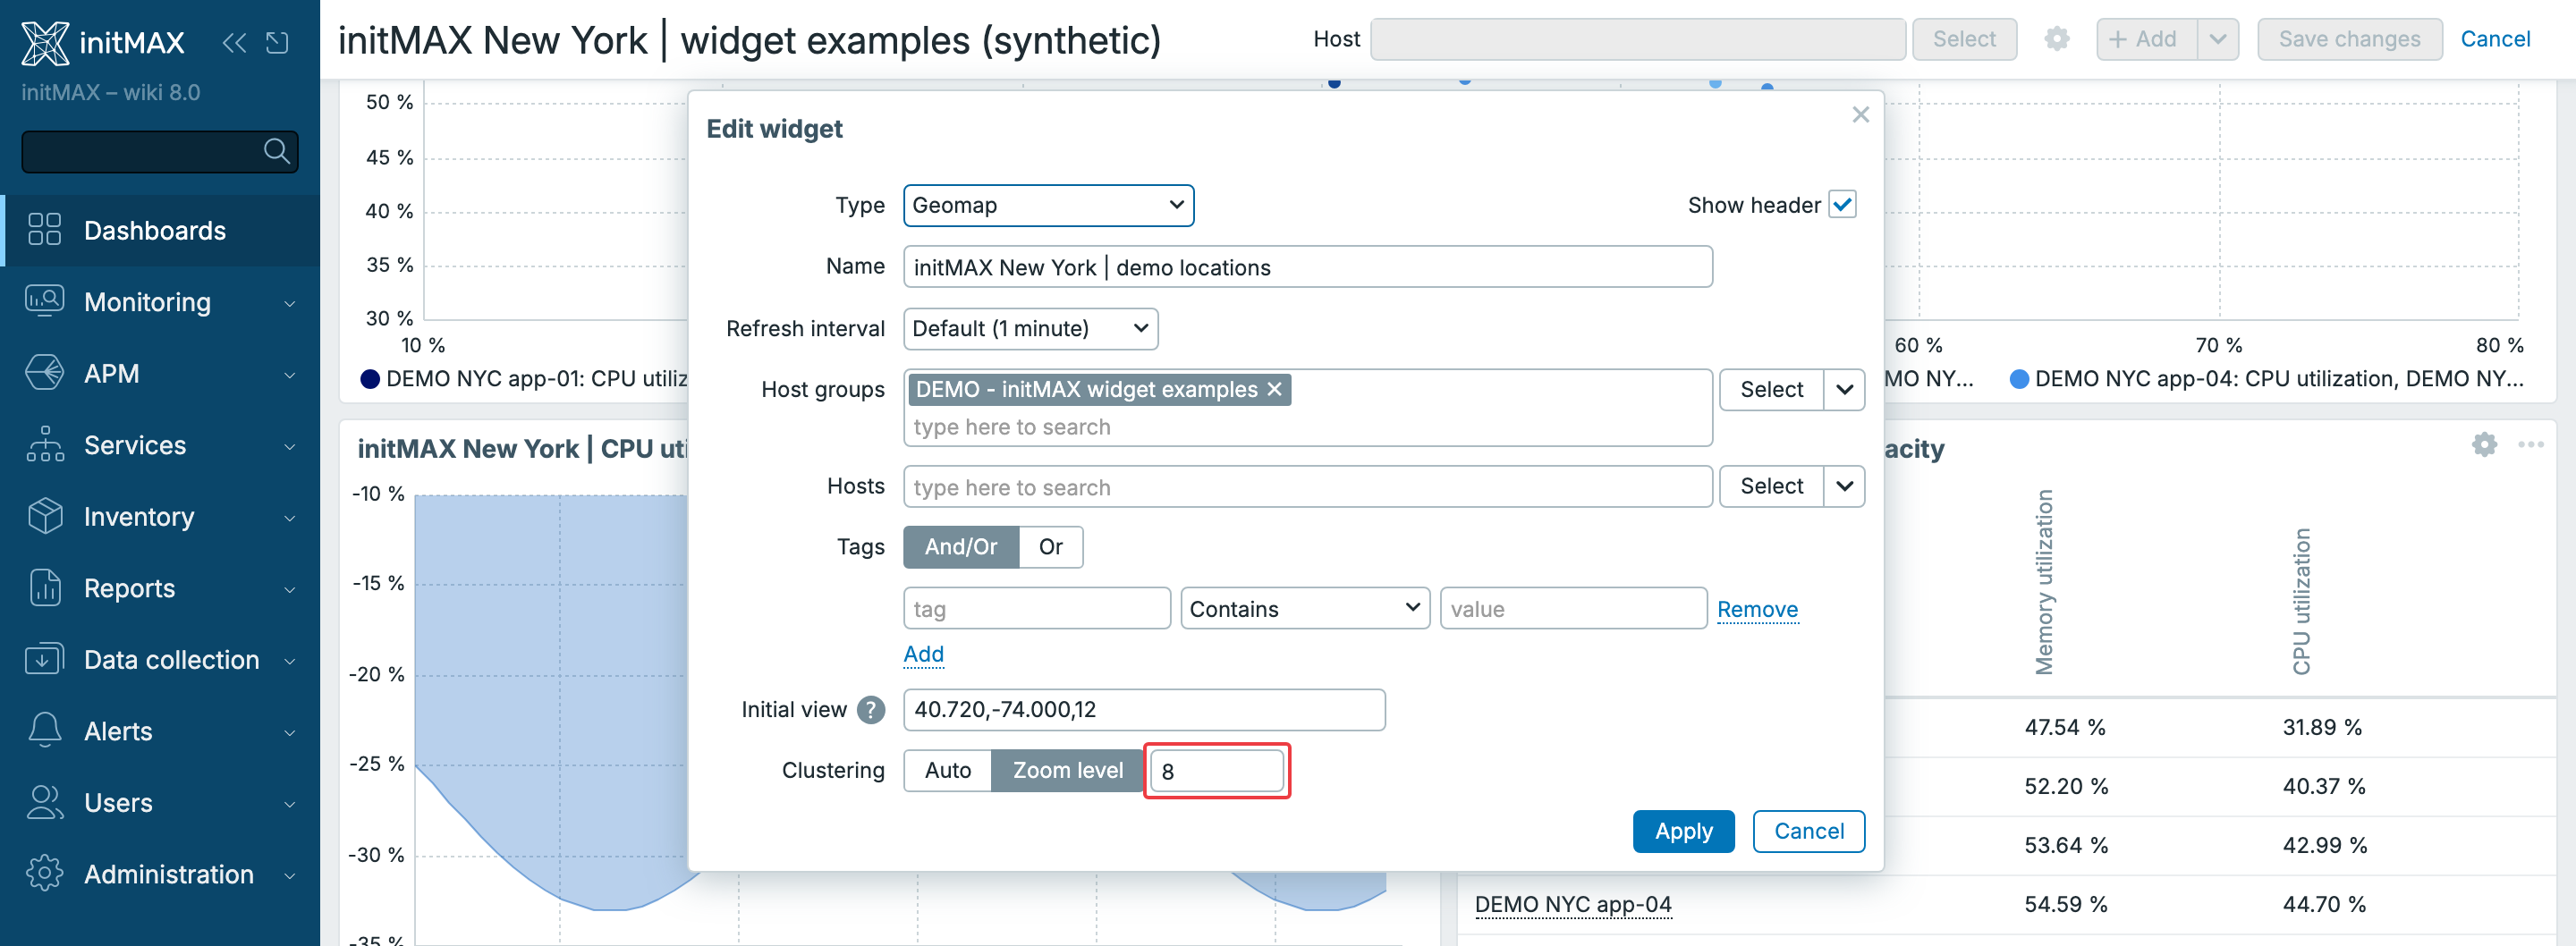
Video: shlukování v GeoMap.
Vizuální indikátor zděděného tagu
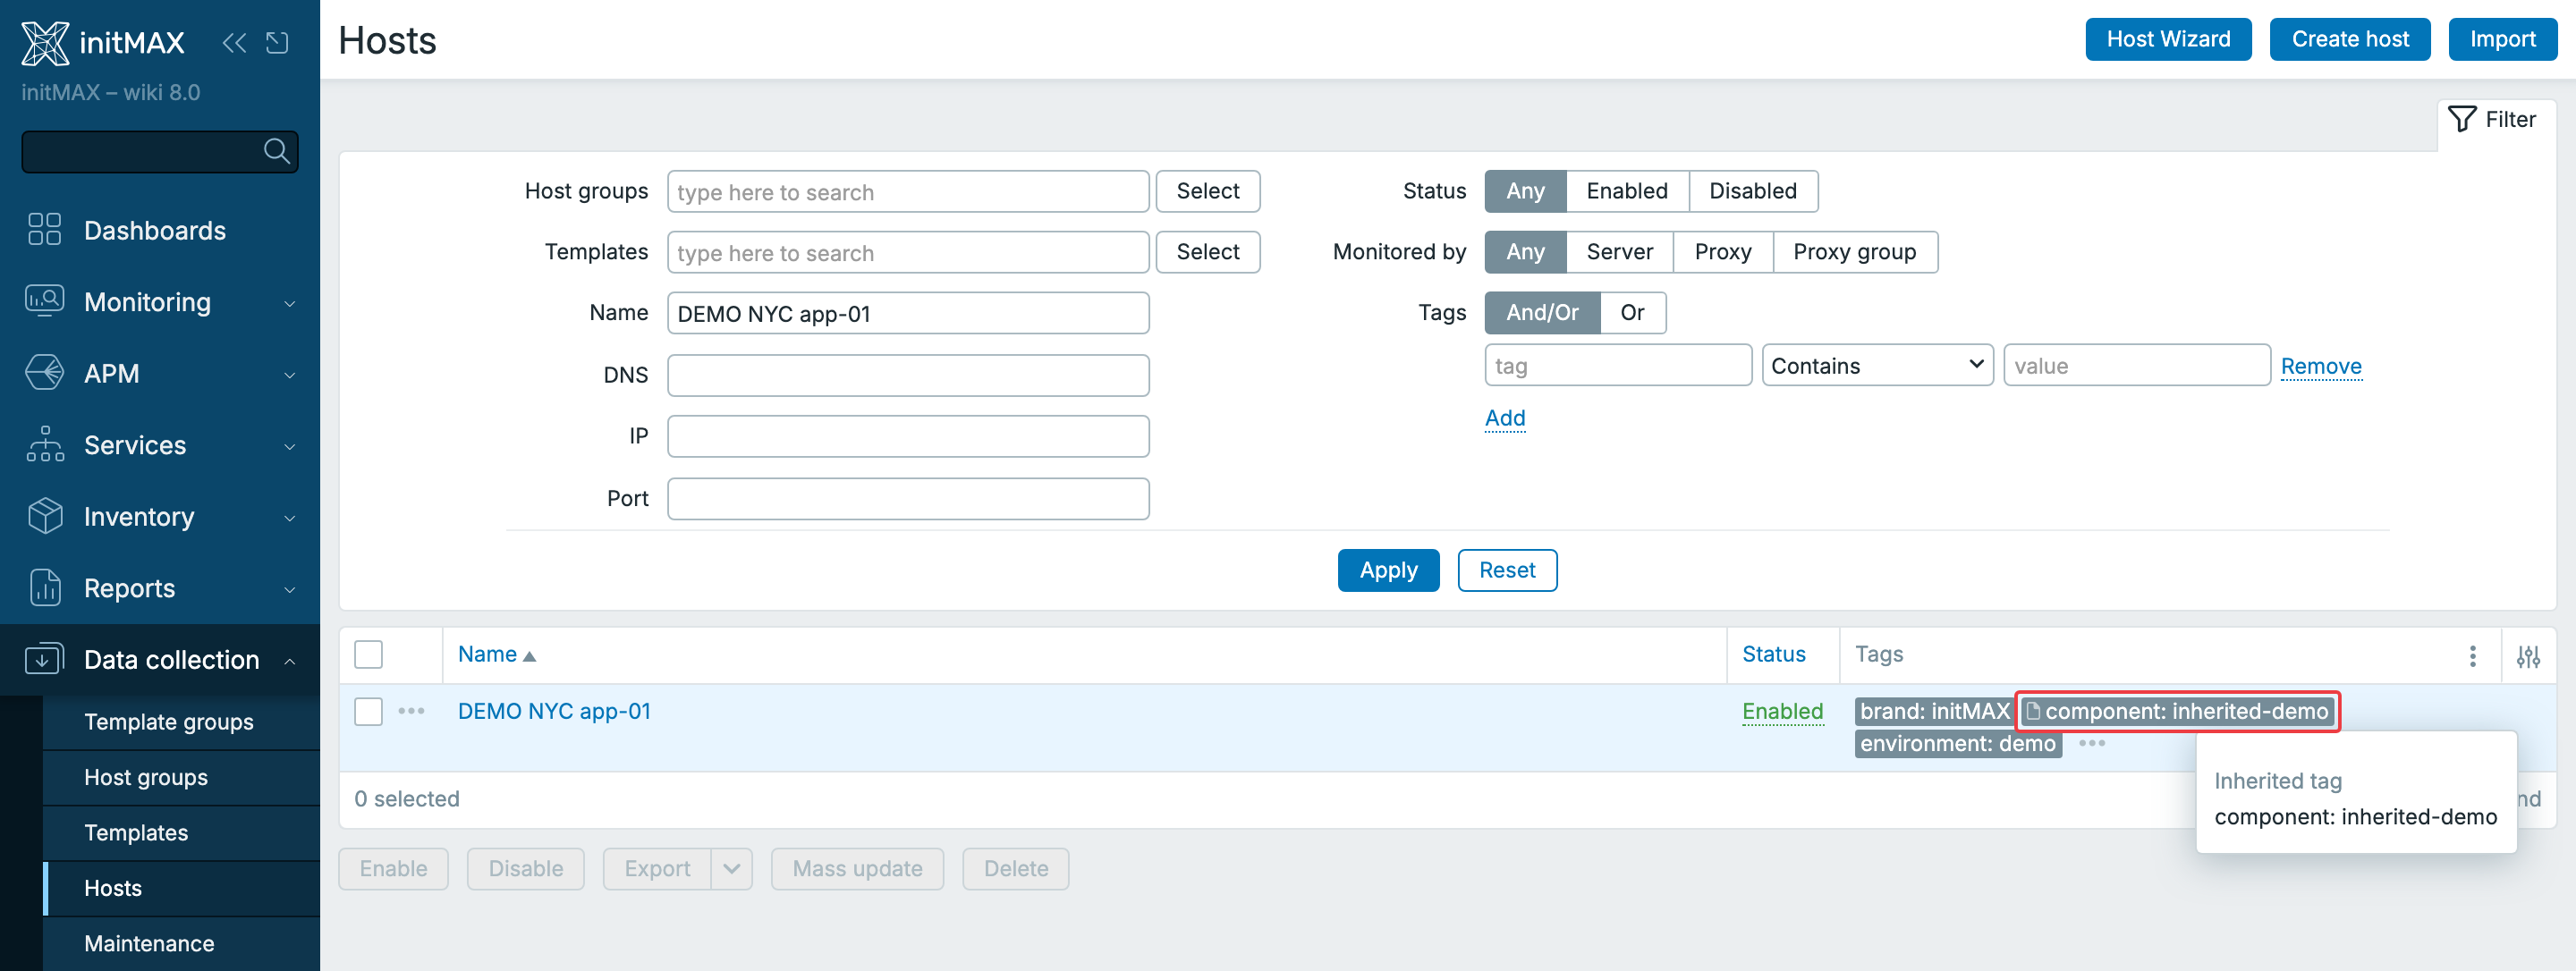
Zabbix teď dělá ze zděděných tagů plnohodnotnou součást UI, takže na první pohled poznáte, jestli tag pochází ze šablony / nadřazeného objektu, nebo jestli byl vytvořen přímo na aktuální úrovni. To je zvlášť praktické ve velkých prostředích, kde má mnoho objektů stejné názvy a spoléháte na tagy pro routování, filtrování a konzistentní klasifikaci napříč hosty, šablonami, položkami a triggery.
V seznamových pohledech jsou zděděné tagy označené malou ikonou stránky/dokumentu na levé straně „pilulky“ tagu a po najetí myší se zobrazí tooltip typu „Inherited tag“ (jak je zvýrazněno na screenshotu). Tagy bez této ikony nejsou zděděné – byly přidané přímo na dané úrovni. V příkladu níže je většina tagů zděděná, zatímco initMAX je nezděděný tag vytvořený lokálně, takže je rozdíl okamžitě vidět.
Vlastní tagy u triggerů z trigger prototypů
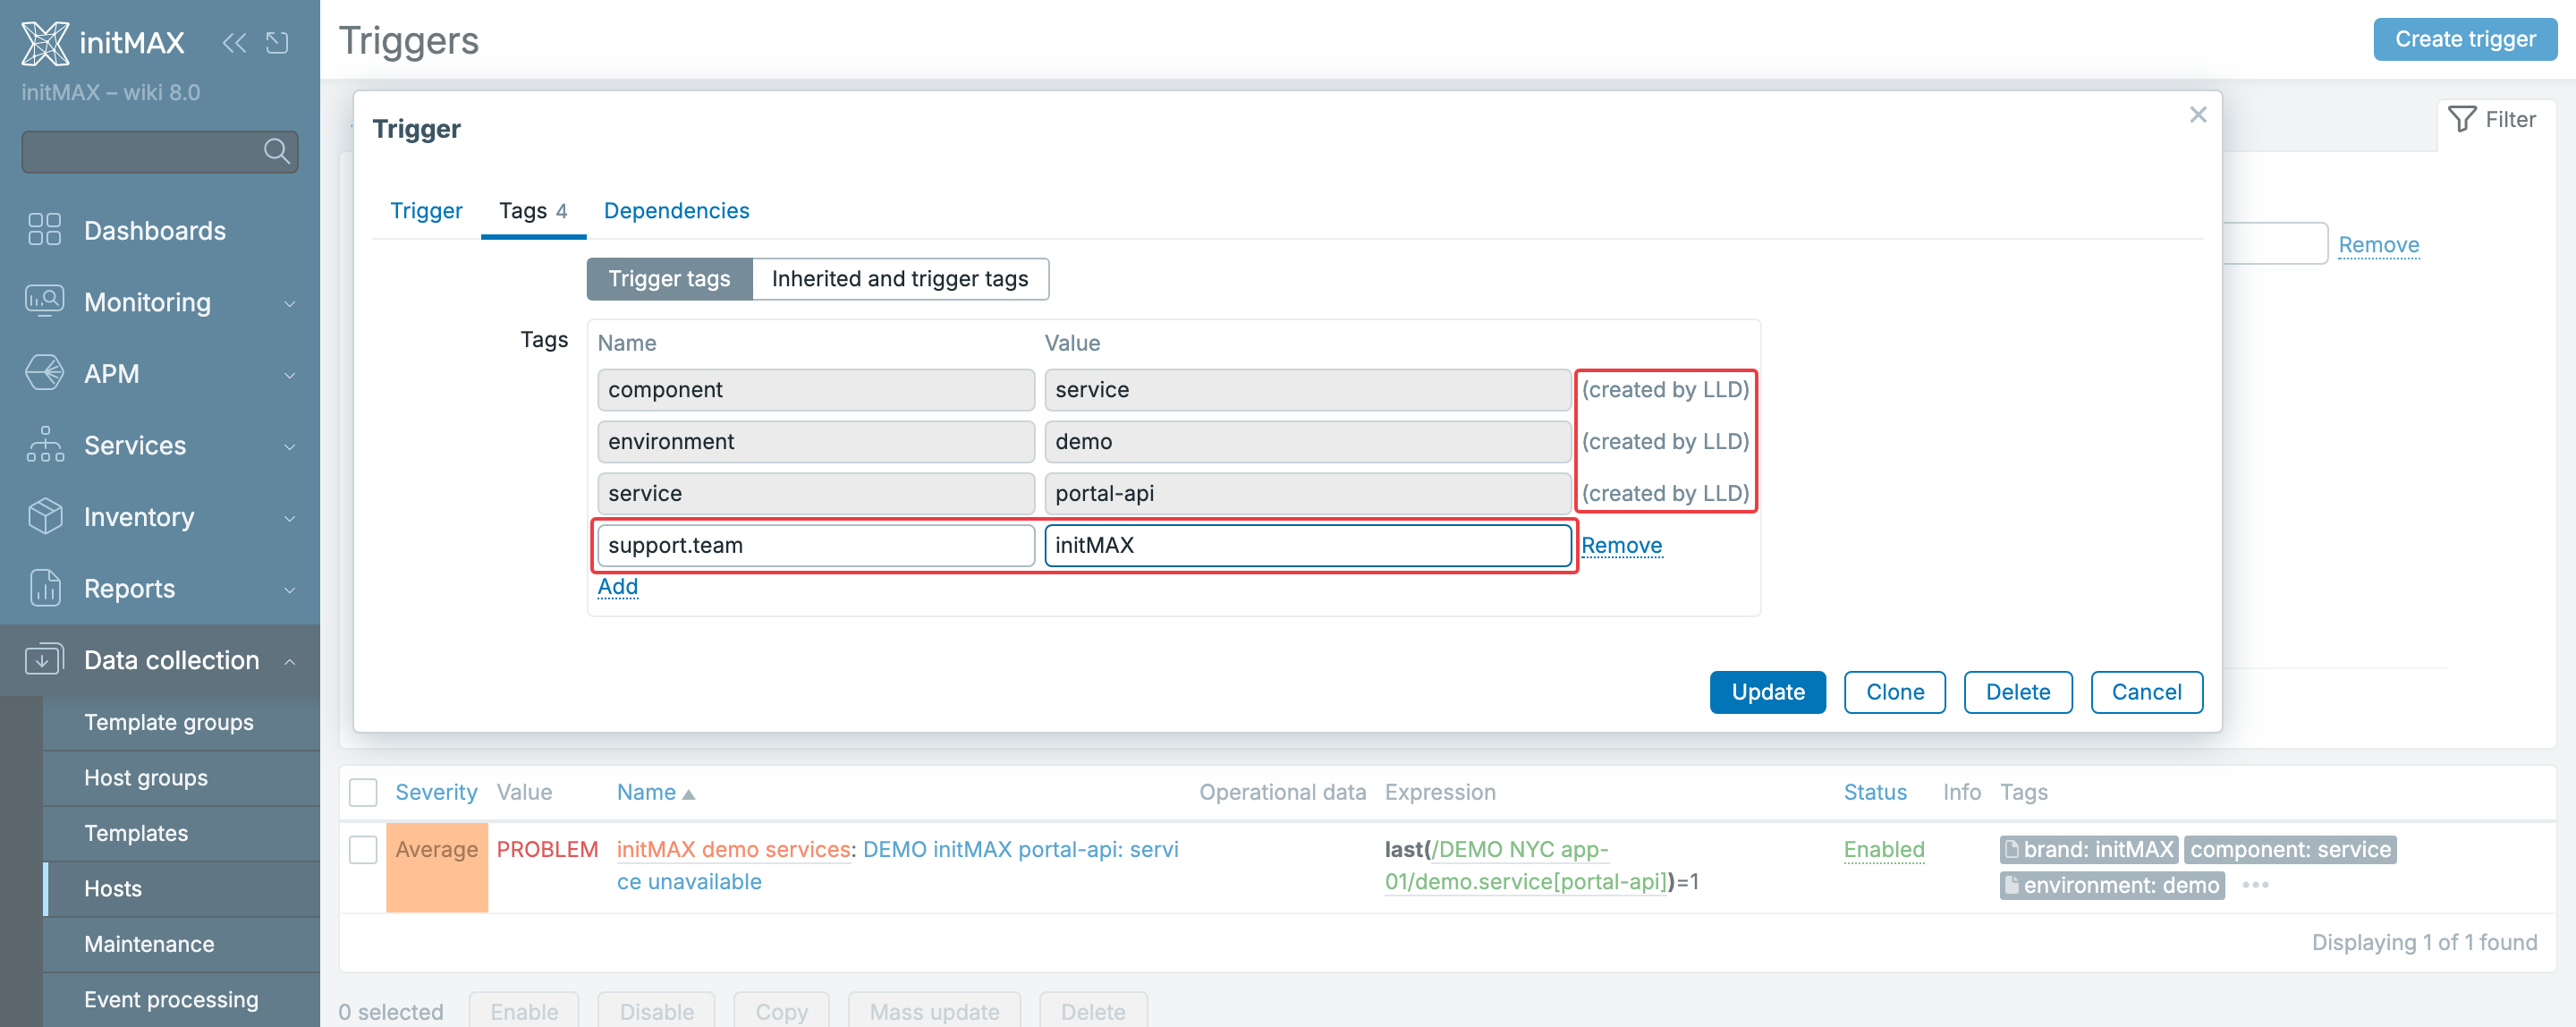
Tato funkce umožňuje přiřazovat vlastní tagy triggerům, které jsou vytvářené z trigger prototypů.
Je to obzvlášť užitečné pro řízení notifikací (odesílat / neodesílat upozornění podle tagů) a pro označování triggerů podle konkrétních služeb, týmů nebo případů použití. Díky tomu je možné přesnější směrování alertů, filtrování a korelace na úrovni služeb.
Možnost upravit tabulkové zobrazení u vybraných stránek
Na podporovaných stránkách můžete pomocí Customize table v pravém horním rohu zobrazovat a skrývat sloupce, měnit jejich pořadí i šířku. Sloupec Tag value zobrazí hodnotu konkrétního tagu a umožňuje vlastní název. Sloupec Tags lze duplikovat a kopii přejmenovat, takže si vedle sebe připravíte několik odlišných pohledů na tagy.
Kde je to dostupné:
- Monitoring → Hosté (Hosts)
- Monitoring → Nejnovější data (Latest data)
- Monitoring → Problémy (Problems)
- Sběr dat (Data collection) → Hosté (Hosts)
- Sběr dat (Data collection) → Šablony (Templates)
Rozložení se ukládá do uživatelského profilu; je osobní a ostatním uživatelům se nepřenese. Pro správu a sdílení uložených filtrů nabízíme také userfilterMAX. Uložený filtr a rozložení sloupců jsou dvě různé věci.
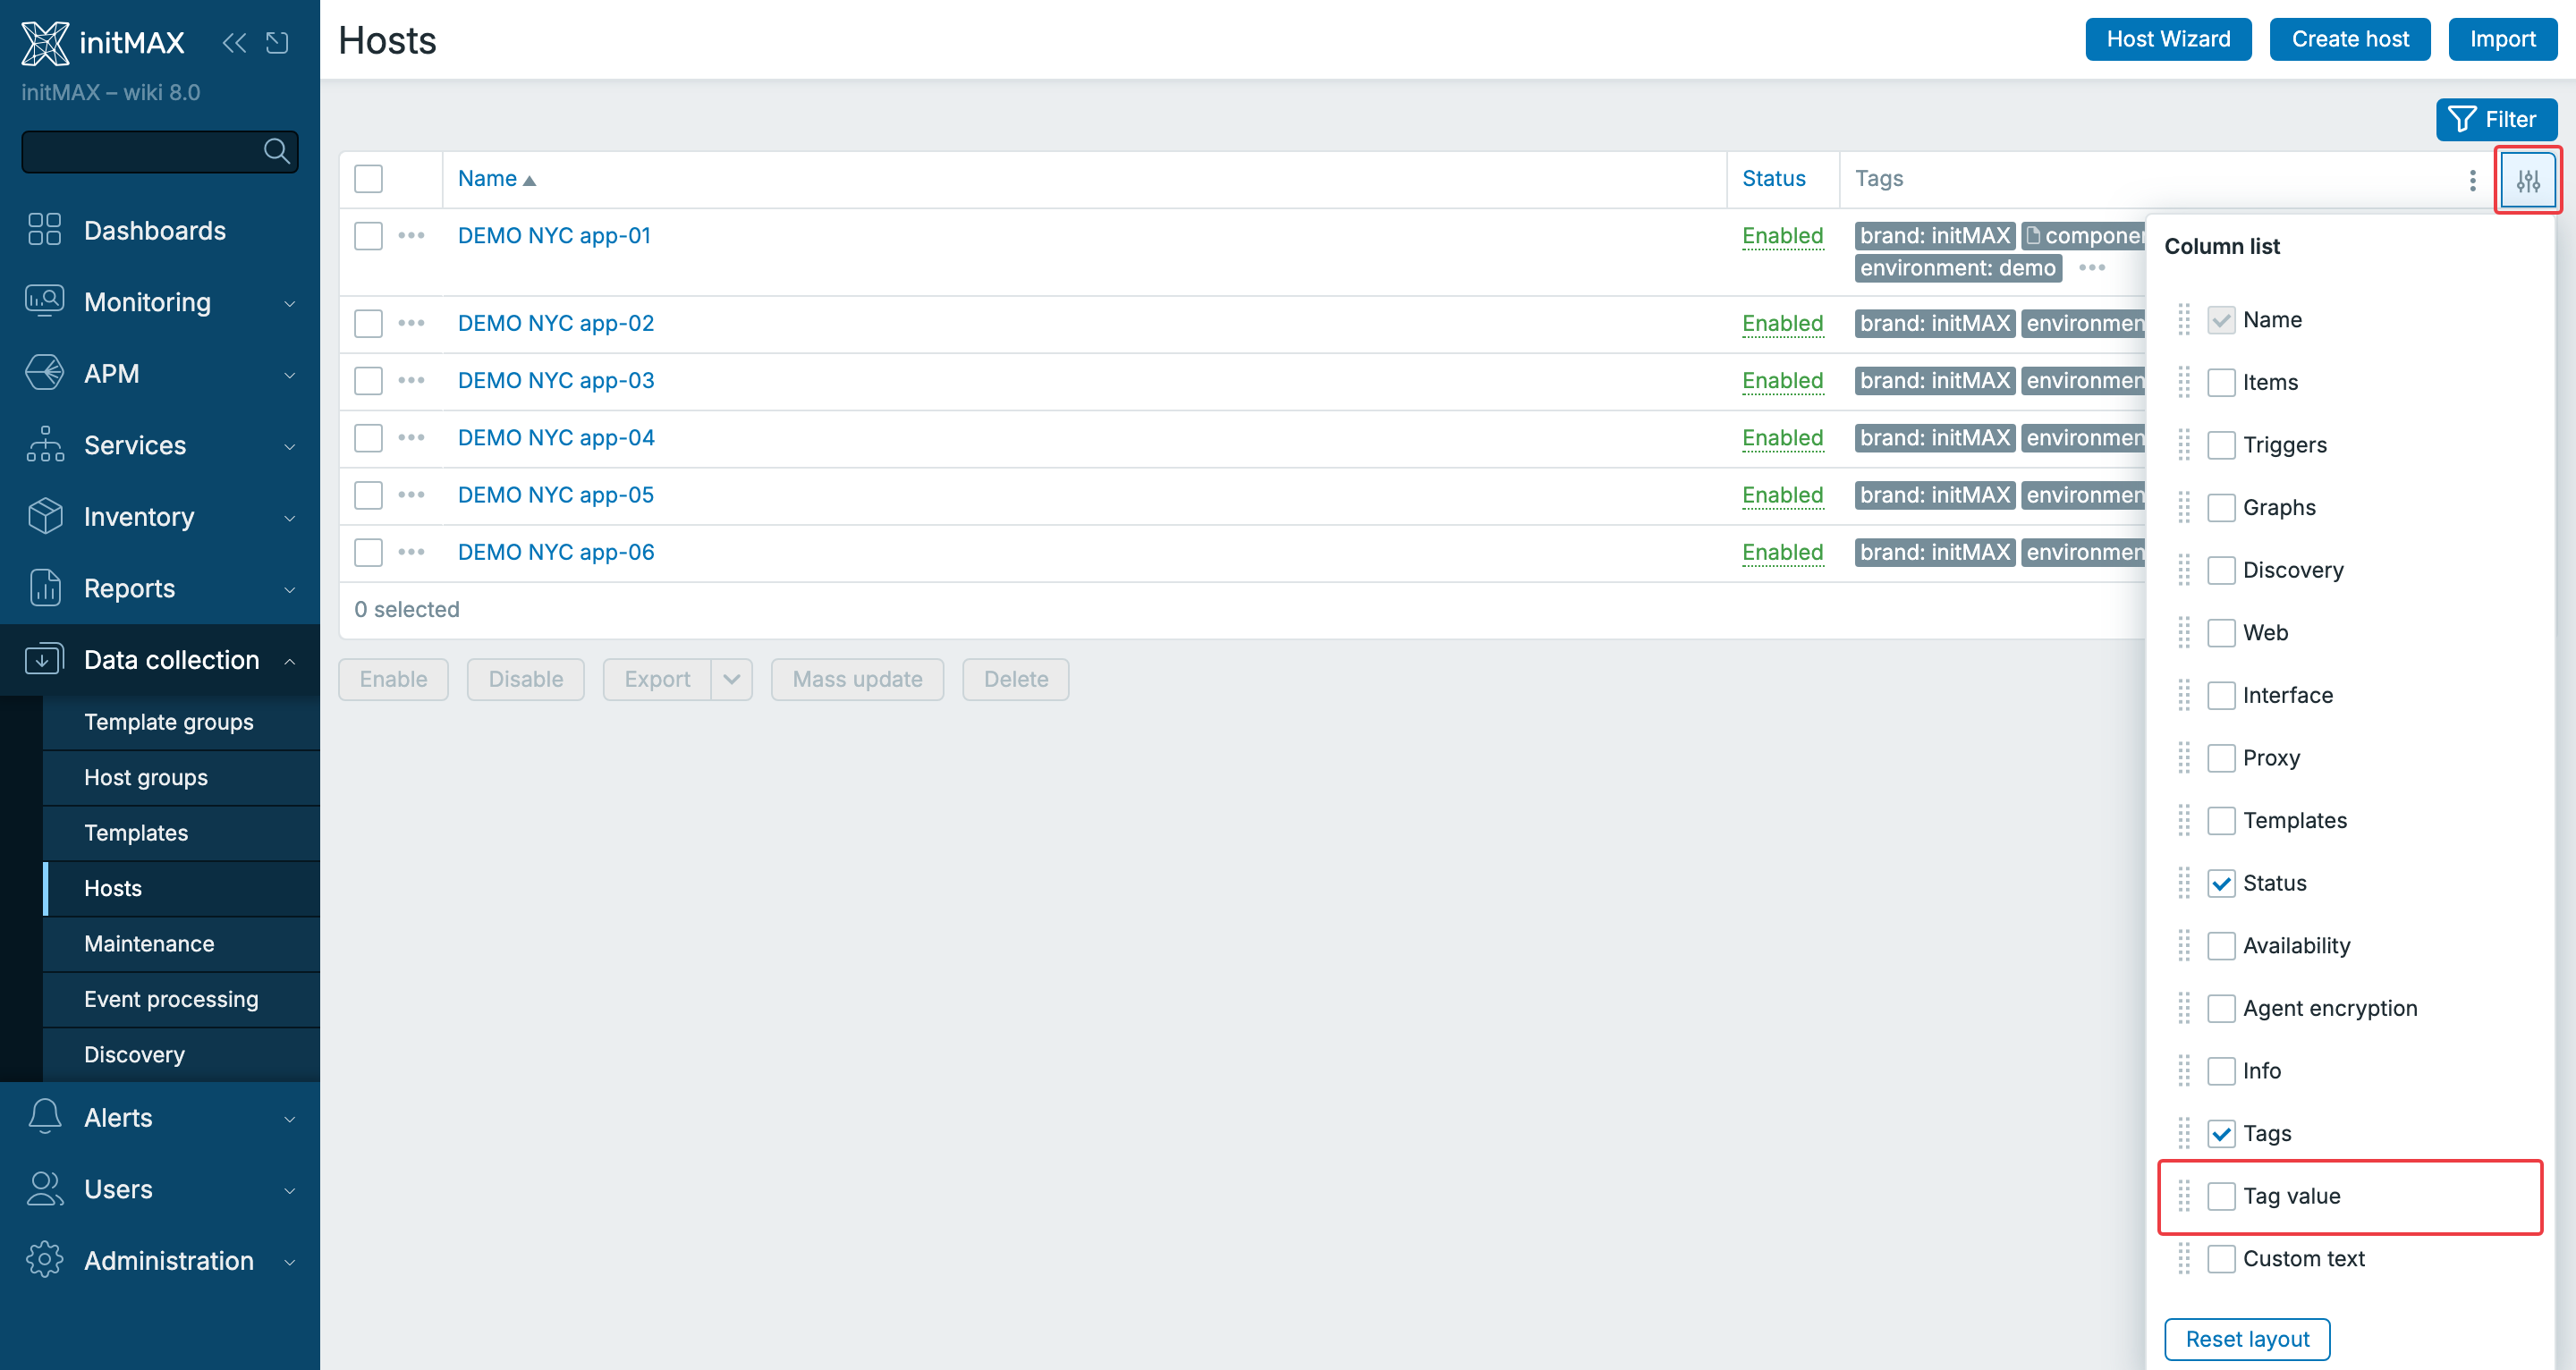
V ukázce přidáváme přes Customize table sloupec Tag value. Do Tag name zadáme brand a sloupec pojmenujeme Brand. U našich demonstračních hostů pak zobrazuje hodnotu initMAX, nikoli celý seznam jejich tagů. Červené rámečky označují nastavení i nový sloupec.
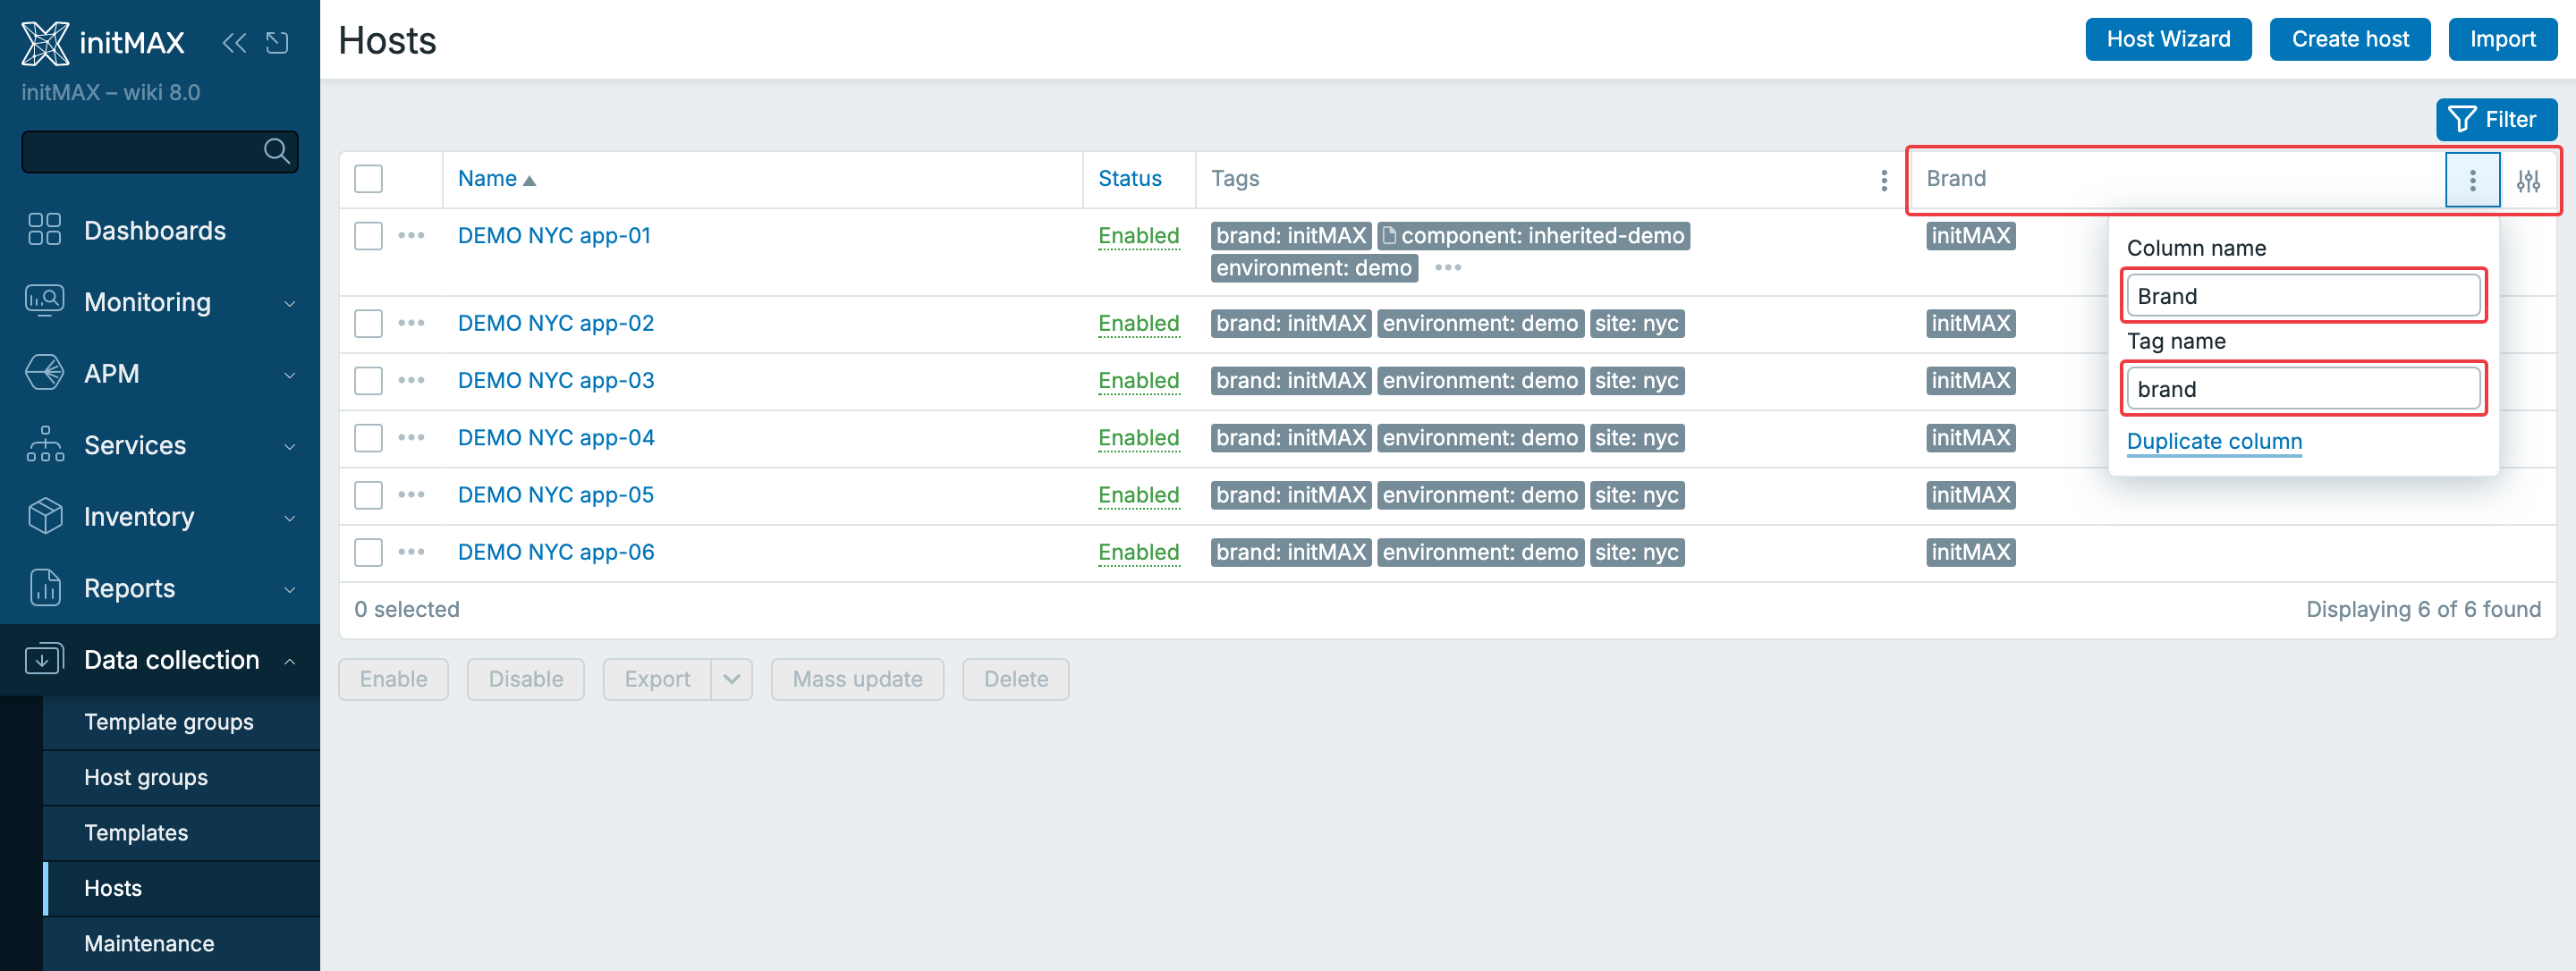
V Data collection > Hosts přidáme tagový sloupec Brand, skryjeme Status, nový sloupec přesuneme doleva a zvětšíme jeho šířku.
Video: úprava tabulky Hosts.
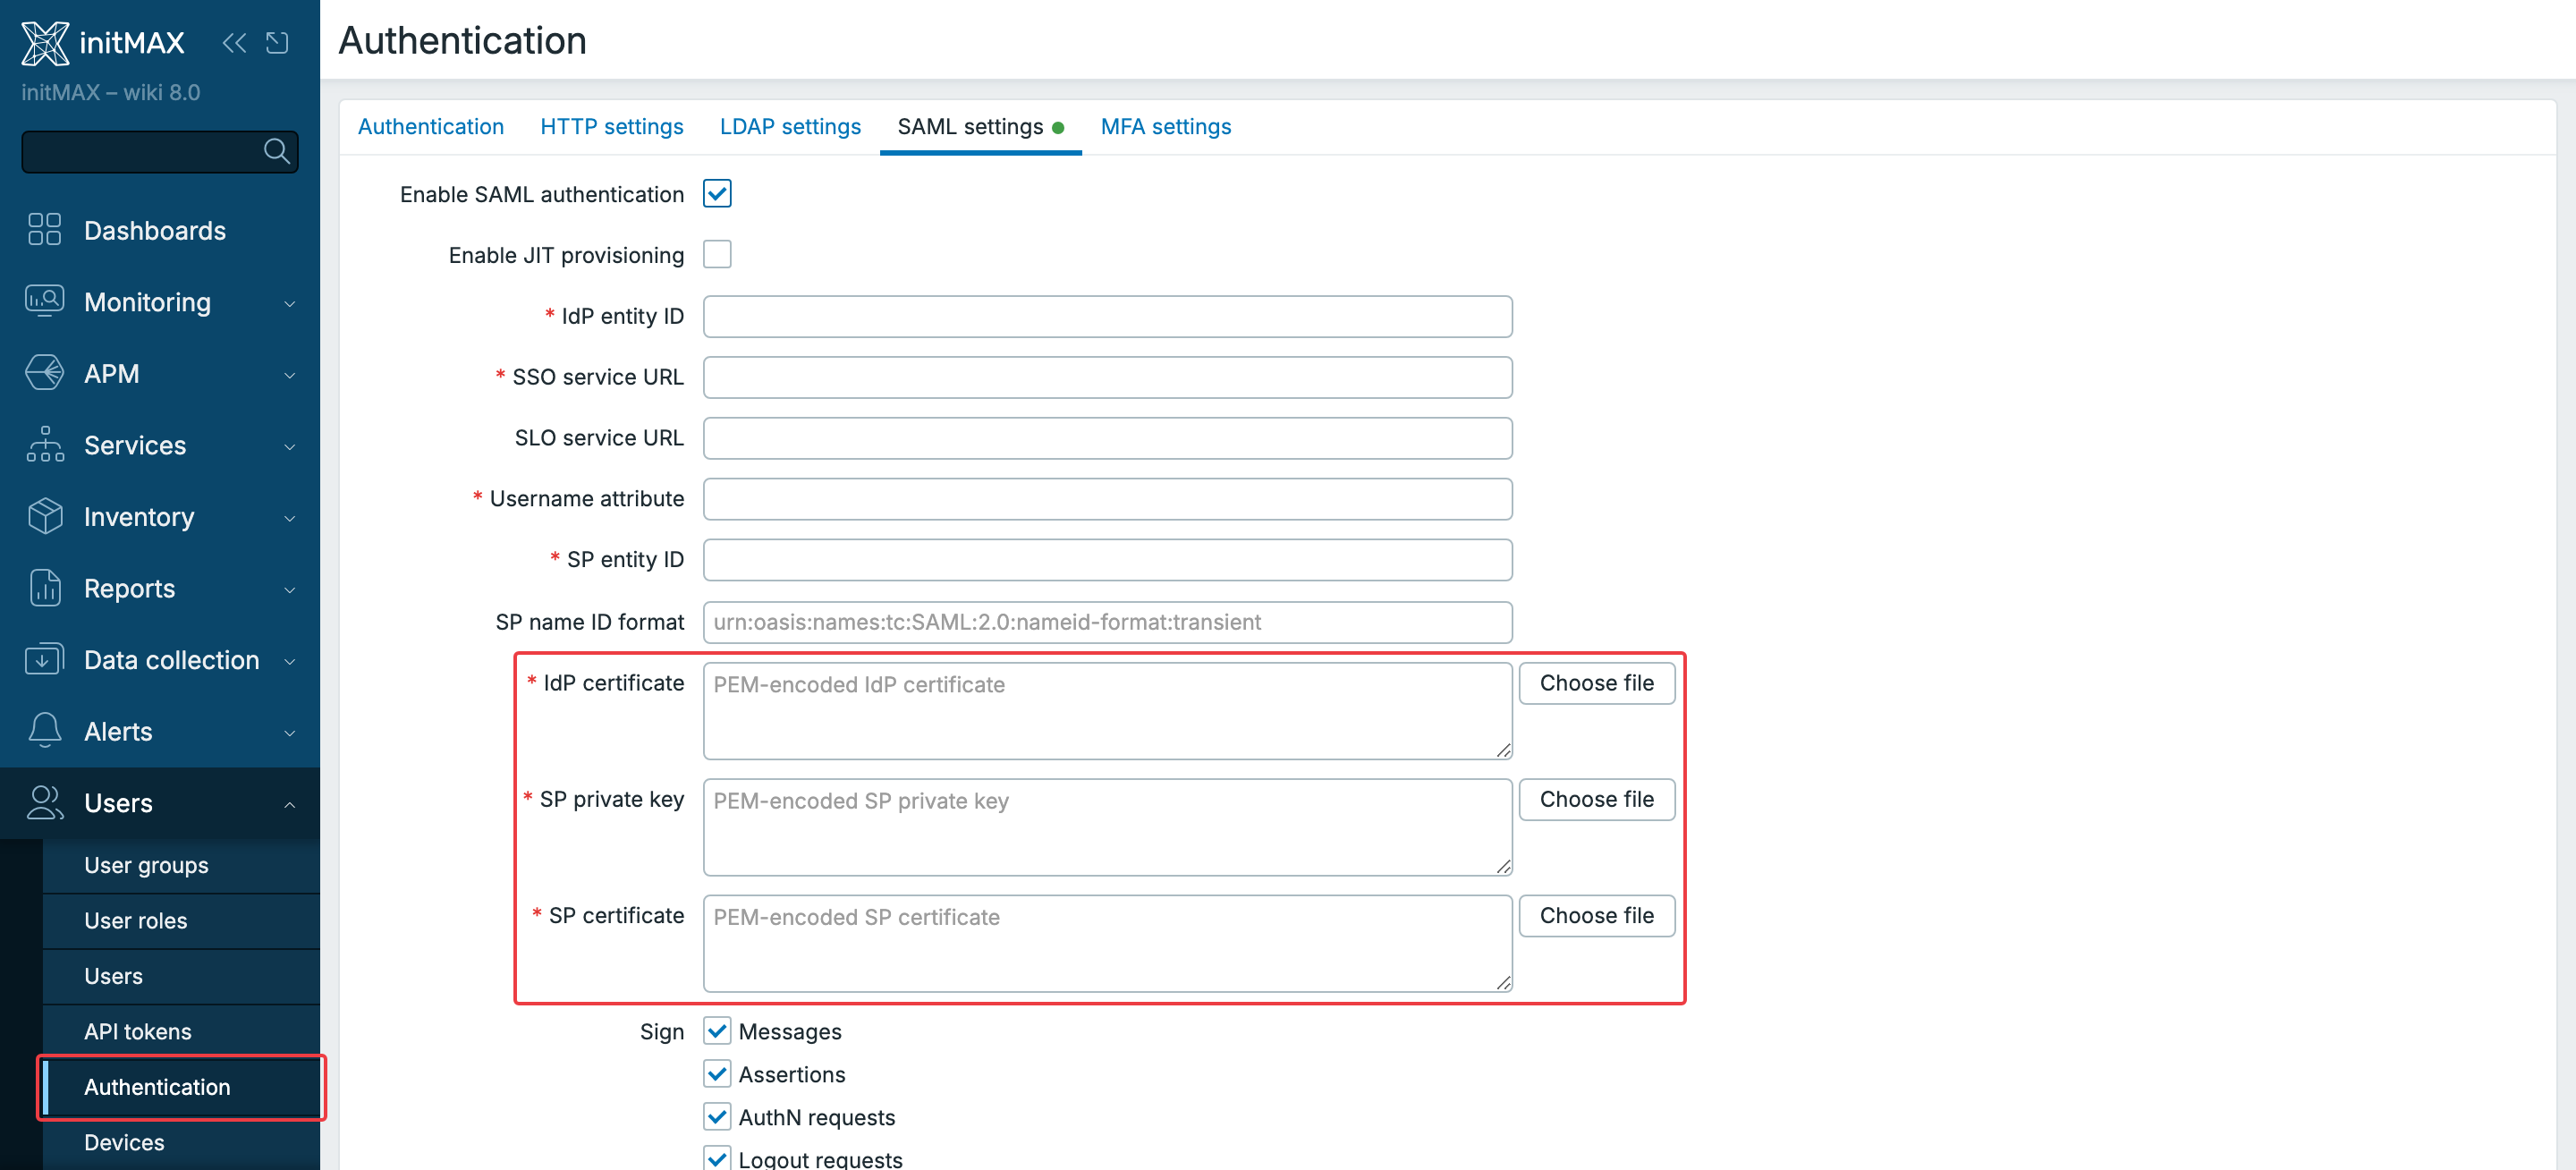
Ukládání SAML certifikátů přímo do databáze
Nově můžete nastavit ukládání SAML certifikátů přímo do databáze Zabbixu. Stačí v konfiguračním souboru (nejčastěji /etc/zabbix/web/zabbix.conf.php) frontendu nastavit:
$SSO['CERT_STORAGE'] = 'database';Díky tomu již nemusíte nahrávat certifikáty přímo na souborový systém serveru. Toto řešení přináší řadu výhod, zejména:
- Snadnou konfiguraci přímo z webového rozhraní,
- Jednotnou správu certifikátů v případě nasazení v režimu High Availability (HA),
- Zjednodušení administrace celého SAML nastavení.
Přehled drobných vylepšení
Operational data u triggeru podporuje až 2048 znaků. Do provozních údajů se tak vejde delší kontext problému; není to změna limitu samotného názvu eventu.
Audit log export do CSV
Audit log dostává CSV export. Je to menší změna, ale v praxi velmi užitečná. U větších instalací se auditní záznamy často předávají mimo Zabbix, archivují se, porovnávají nebo se používají při kontrole změn. Přímý export snižuje potřebu ručního kopírování nebo dodatečných skriptů.
Bezpečnější výchozí nastavení pro trapper itemy
Zabbix doplňuje výchozí hodnotu pro Allowed hosts u trapper itemů a přidává globální makro {$TRAPPER.ALLOWED_HOSTS}. To pomůže hlavně u šablon, importů a hromadné správy, kde je lepší mít jednotný a snadno upravitelný výchozí režim místo ručního doplňování na mnoha místech.
Nové klíče agenta net.if.get a vfs.dev.get
Agent dostává dva nové klíče pro discovery: net.if.get vrátí síťová rozhraní a vfs.dev.get bloková zařízení (Linux a AIX) jako jeden JSON se všemi atributy, bez skládání z několika položek. Šablony Linux a AIX by Zabbix agent jsou na ně už přepsané a hodí se i pro vlastní LLD pravidla.
vfs.fs.get navíc dostává parametry mode a mountpoint pro výběr režimu výstupu a konkrétního přípojného bodu. Šablony operačních systémů jej používají pro sběr filesystemů; z jednoho JSON výstupu lze získat data pro discovery i navazující závislé položky.
DNS přes c-ares s cache a failoverem
Server, proxy i agent umí DNS dotazy řešit knihovnou c-ares s cache a failoverem mezi resolvery (volba při buildu, funguje i pro agenta na Windows). Výpadek nebo zpomalení jednoho DNS serveru už nezastaví polling hostů zadaných jménem.
Cache engine ID u SNMPv3
SNMPv3 si po prvním zjištění cachuje engine ID zařízení a nepotřebuje tak před každým dotazem úvodní výměnu. U velkých SNMP sítí to znamená znatelně méně paketů a rychlejší polling.
SNMP: Retries a makra pro Max repetition count
Na SNMP rozhraní přibývá Retries pro počet opakování nativních bulk požadavků. Max repetition count nově přijímá uživatelská makra. Chování pollingu tak můžete přizpůsobit pomalejším nebo omezeným zařízením a velikost bulk dotazů spravovat přes makra místo ručního nastavování každého rozhraní.
Monitoring cache trendových funkcí
Interní položka zabbix[tcache,cache,paccessed] ukazuje podíl záznamů cache trendových funkcí použitých za posledních 24 hodin. Spolu s pitems a pmisses ji sbírají health šablony serveru. Health šablony serveru i proxy nově sledují také vytížení Telemetry query pollerů, což pomůže rozpoznat úzké místo při zpracování APM položek.
HTTP agent a LLD: volnější vstupy
HTTP agent přijme v těle požadavku i formálně nevalidní JSON nebo XML, discovery pravidlo typu HTTP agent má volbu převodu odpovědi na JSON a LLD makra se resolvují i ve vnořeném JSONu v prototypech. VMware položky *.alarms.get vracejí detaily entit a skutečné jméno hosta.
Agent 2: Oracle přes TLS, Ceph jako loadable plugin
Oracle plugin agenta 2 podporuje TCPS (TLS), Ceph plugin je nově loadable a MySQL plugin používá SHOW REPLICA STATUS vedle staršího SHOW SLAVE STATUS, takže funguje i na aktuálních verzích MySQL.
HTTP přesměrování a profilování agenta 2
Klíče web.page.get, web.page.perf a web.page.regexp mají nový volitelný parametr redirect_limit, který řídí počet následovaných HTTP přesměrování. Agent 2 zároveň přidává pprof profiler pro diagnostiku spotřeby CPU a paměti; jde o nástroj pro hledání provozních problémů agenta, ne o profilování aplikací v APM.
Nové funkce jsonpath, xmlxpath, contains a substring
Historické a makro funkce dostávají jsonpath() a xmlxpath() pro vytažení hodnoty z JSON nebo XML obsahu, contains() a substring() pro práci s textem. JSONPath a XMLXPath v trigger výrazech pracují s řetězcovými typy položek (Character, Text a Log). Nový úložný typ JSON tím nezískává přímou podporu triggerů; potřebné hodnoty lze dále získat preprocessingem do závislých položek.
Diagnostika preprocessingu a stránka po přihlášení
Server a proxy poskytují podrobnější diagnostický výstup preprocessingu, který pomůže při hledání úzkých míst ve zpracování položek. V uživatelské roli lze také vynutit stránku po přihlášení, například společný provozní dashboard. Výchozí pohled týmu tak nemusí záviset na osobním nastavení každého uživatele.
Inline validace formulářů
Prakticky každý formulář ve frontendu prošel přepisem na inline validaci: chyby se ukážou u pole hned, ne až po odeslání. Discovery pravidla a host prototypy se otevírají v modálním okně jako zbytek konfigurace, přibyl odkaz Skip to main content pro čtečky a klávesnici a filtr tagů v Problems přišel o nadbytečné přepínače (prázdný seznam tagů = všechny tagy).
Inverze hodnot v grafu
Widget Graph má u datové sady volbu Invert values: metrika se vykreslí zrcadlově pod osou, takže se do jednoho grafu vejde příchozí a odchozí provoz nebo čtení a zápis disku bez překrývání.
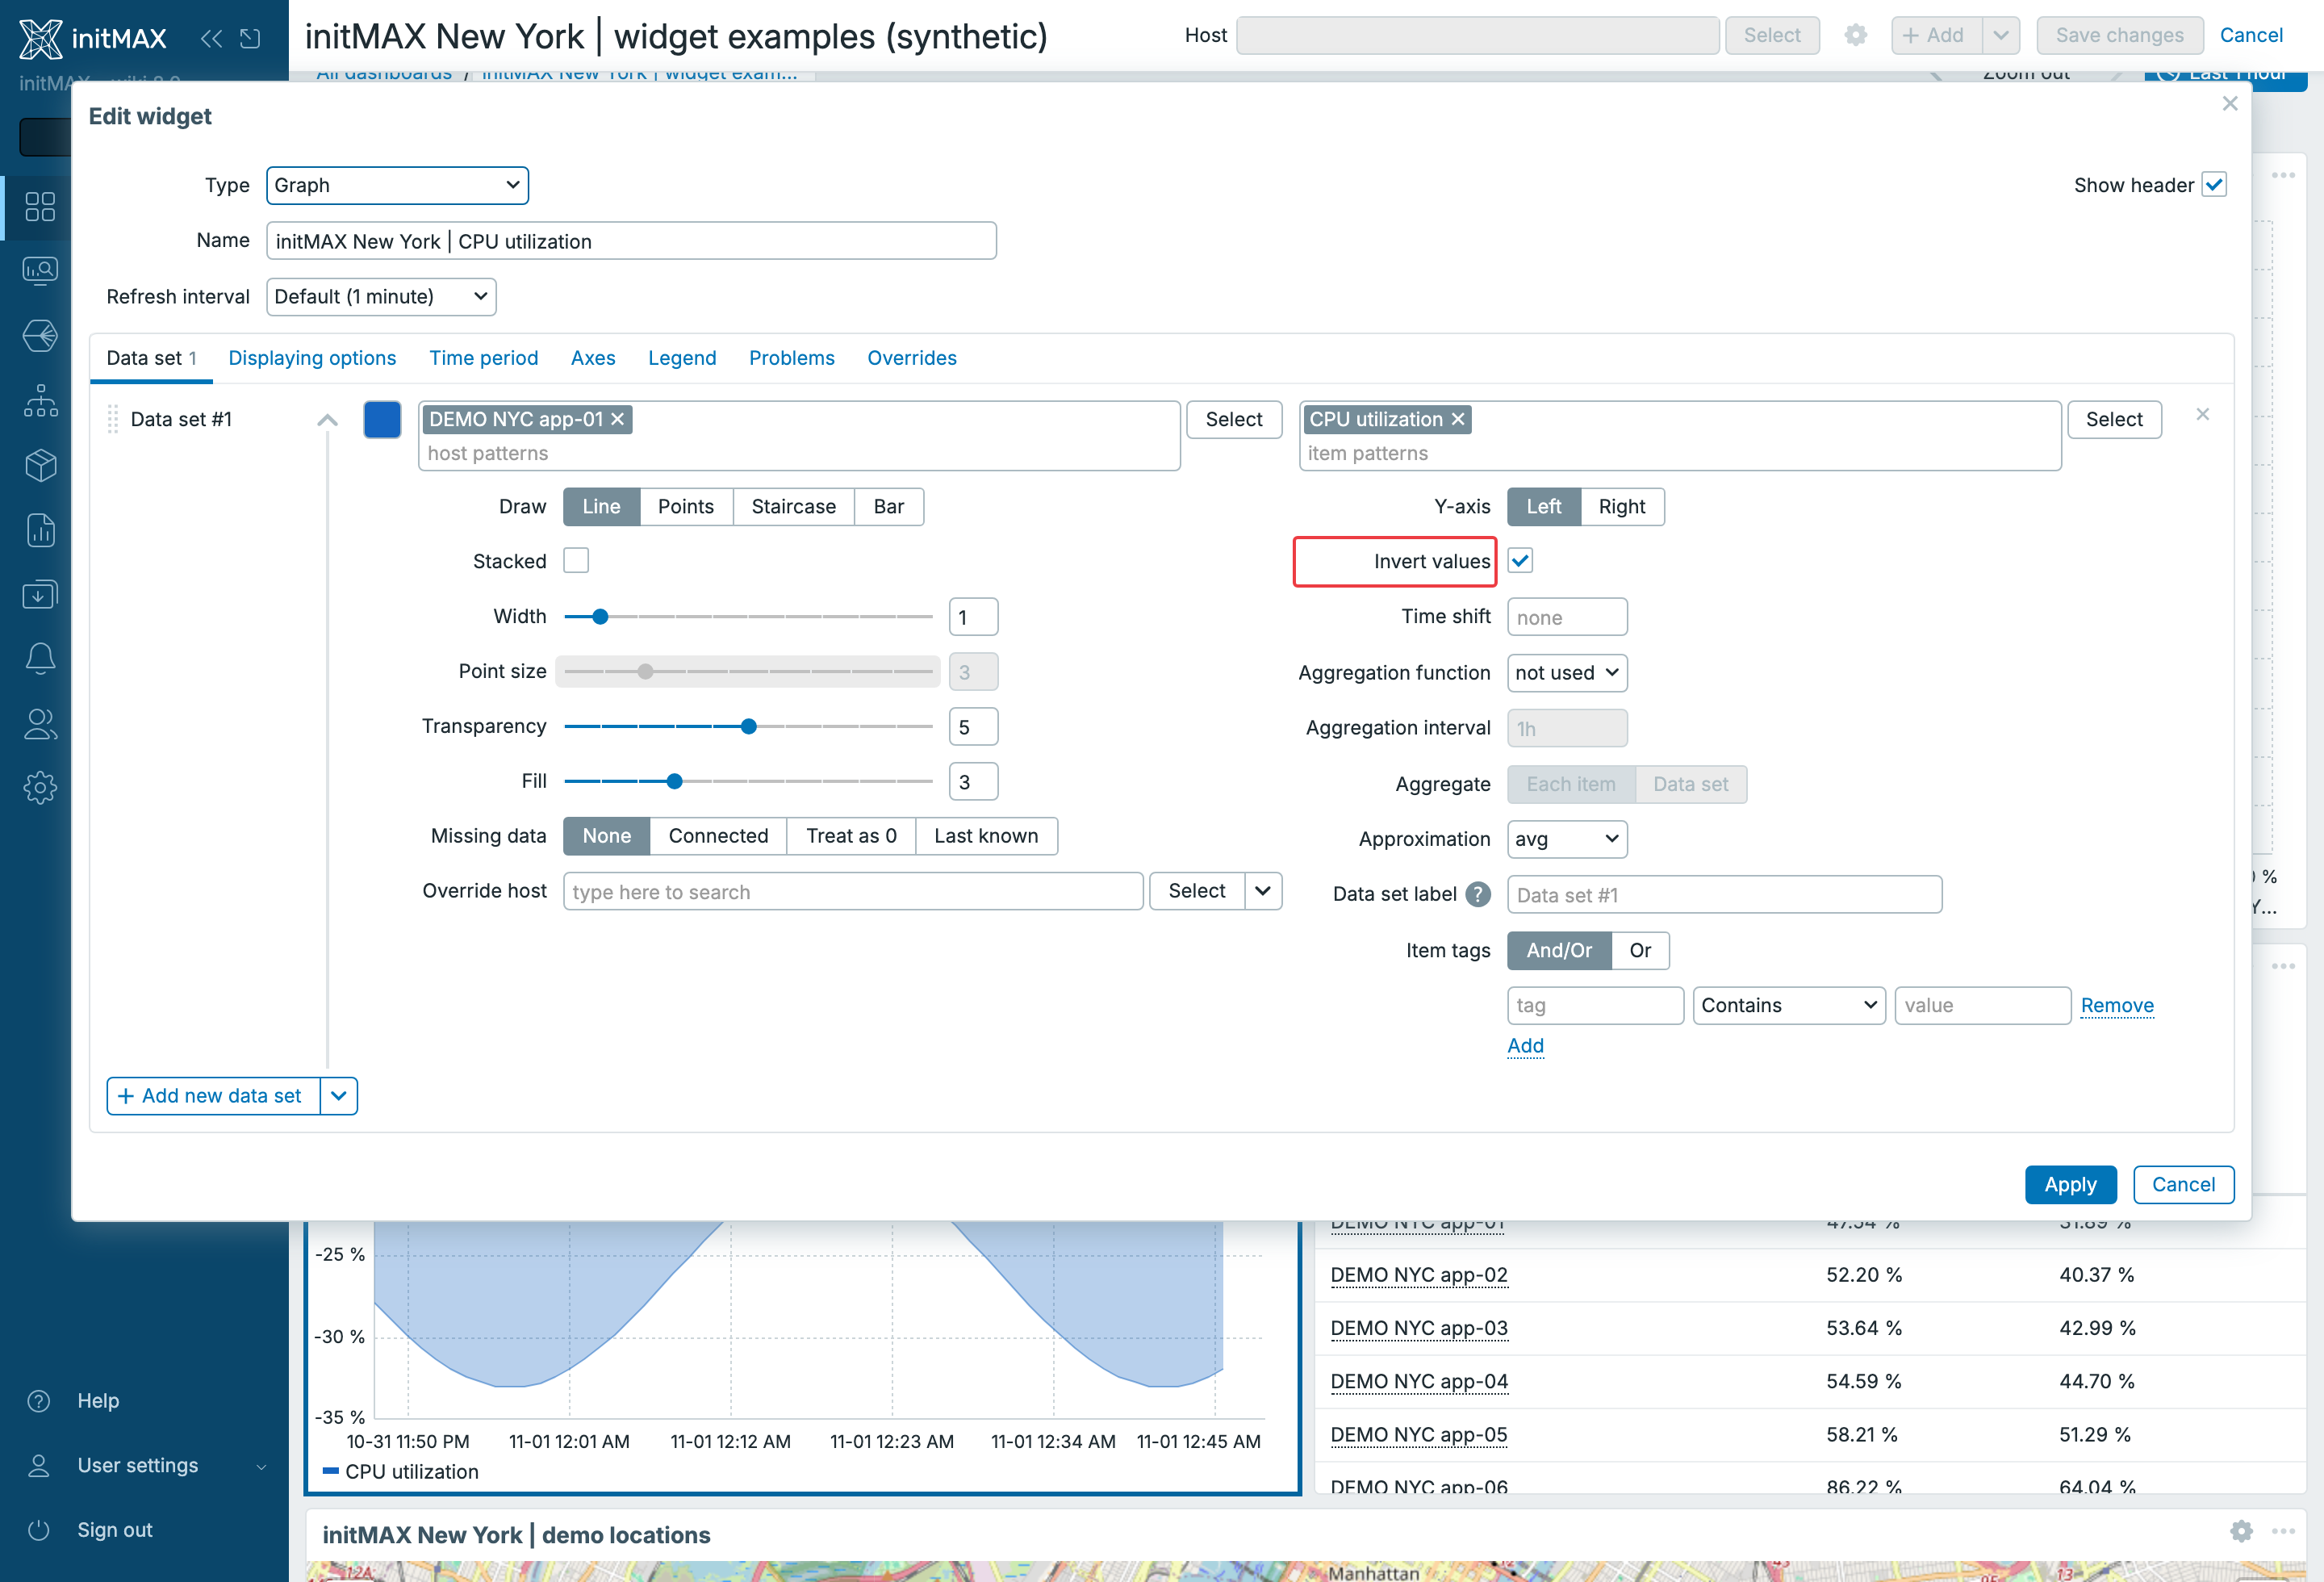
Patterny položek ve widgetu Top items
Sloupce widgetu Top items přijímají patterny názvů položek místo výběru konkrétních položek. Například Checkout:* zahrne položky, jejichž název začíná Checkout:, napříč vybranými hosty. Pattern se vztahuje k názvu, nikoli ke klíči položky. Výběr můžete dále omezit tagy položek a nastavit řazení i počet zobrazených položek.
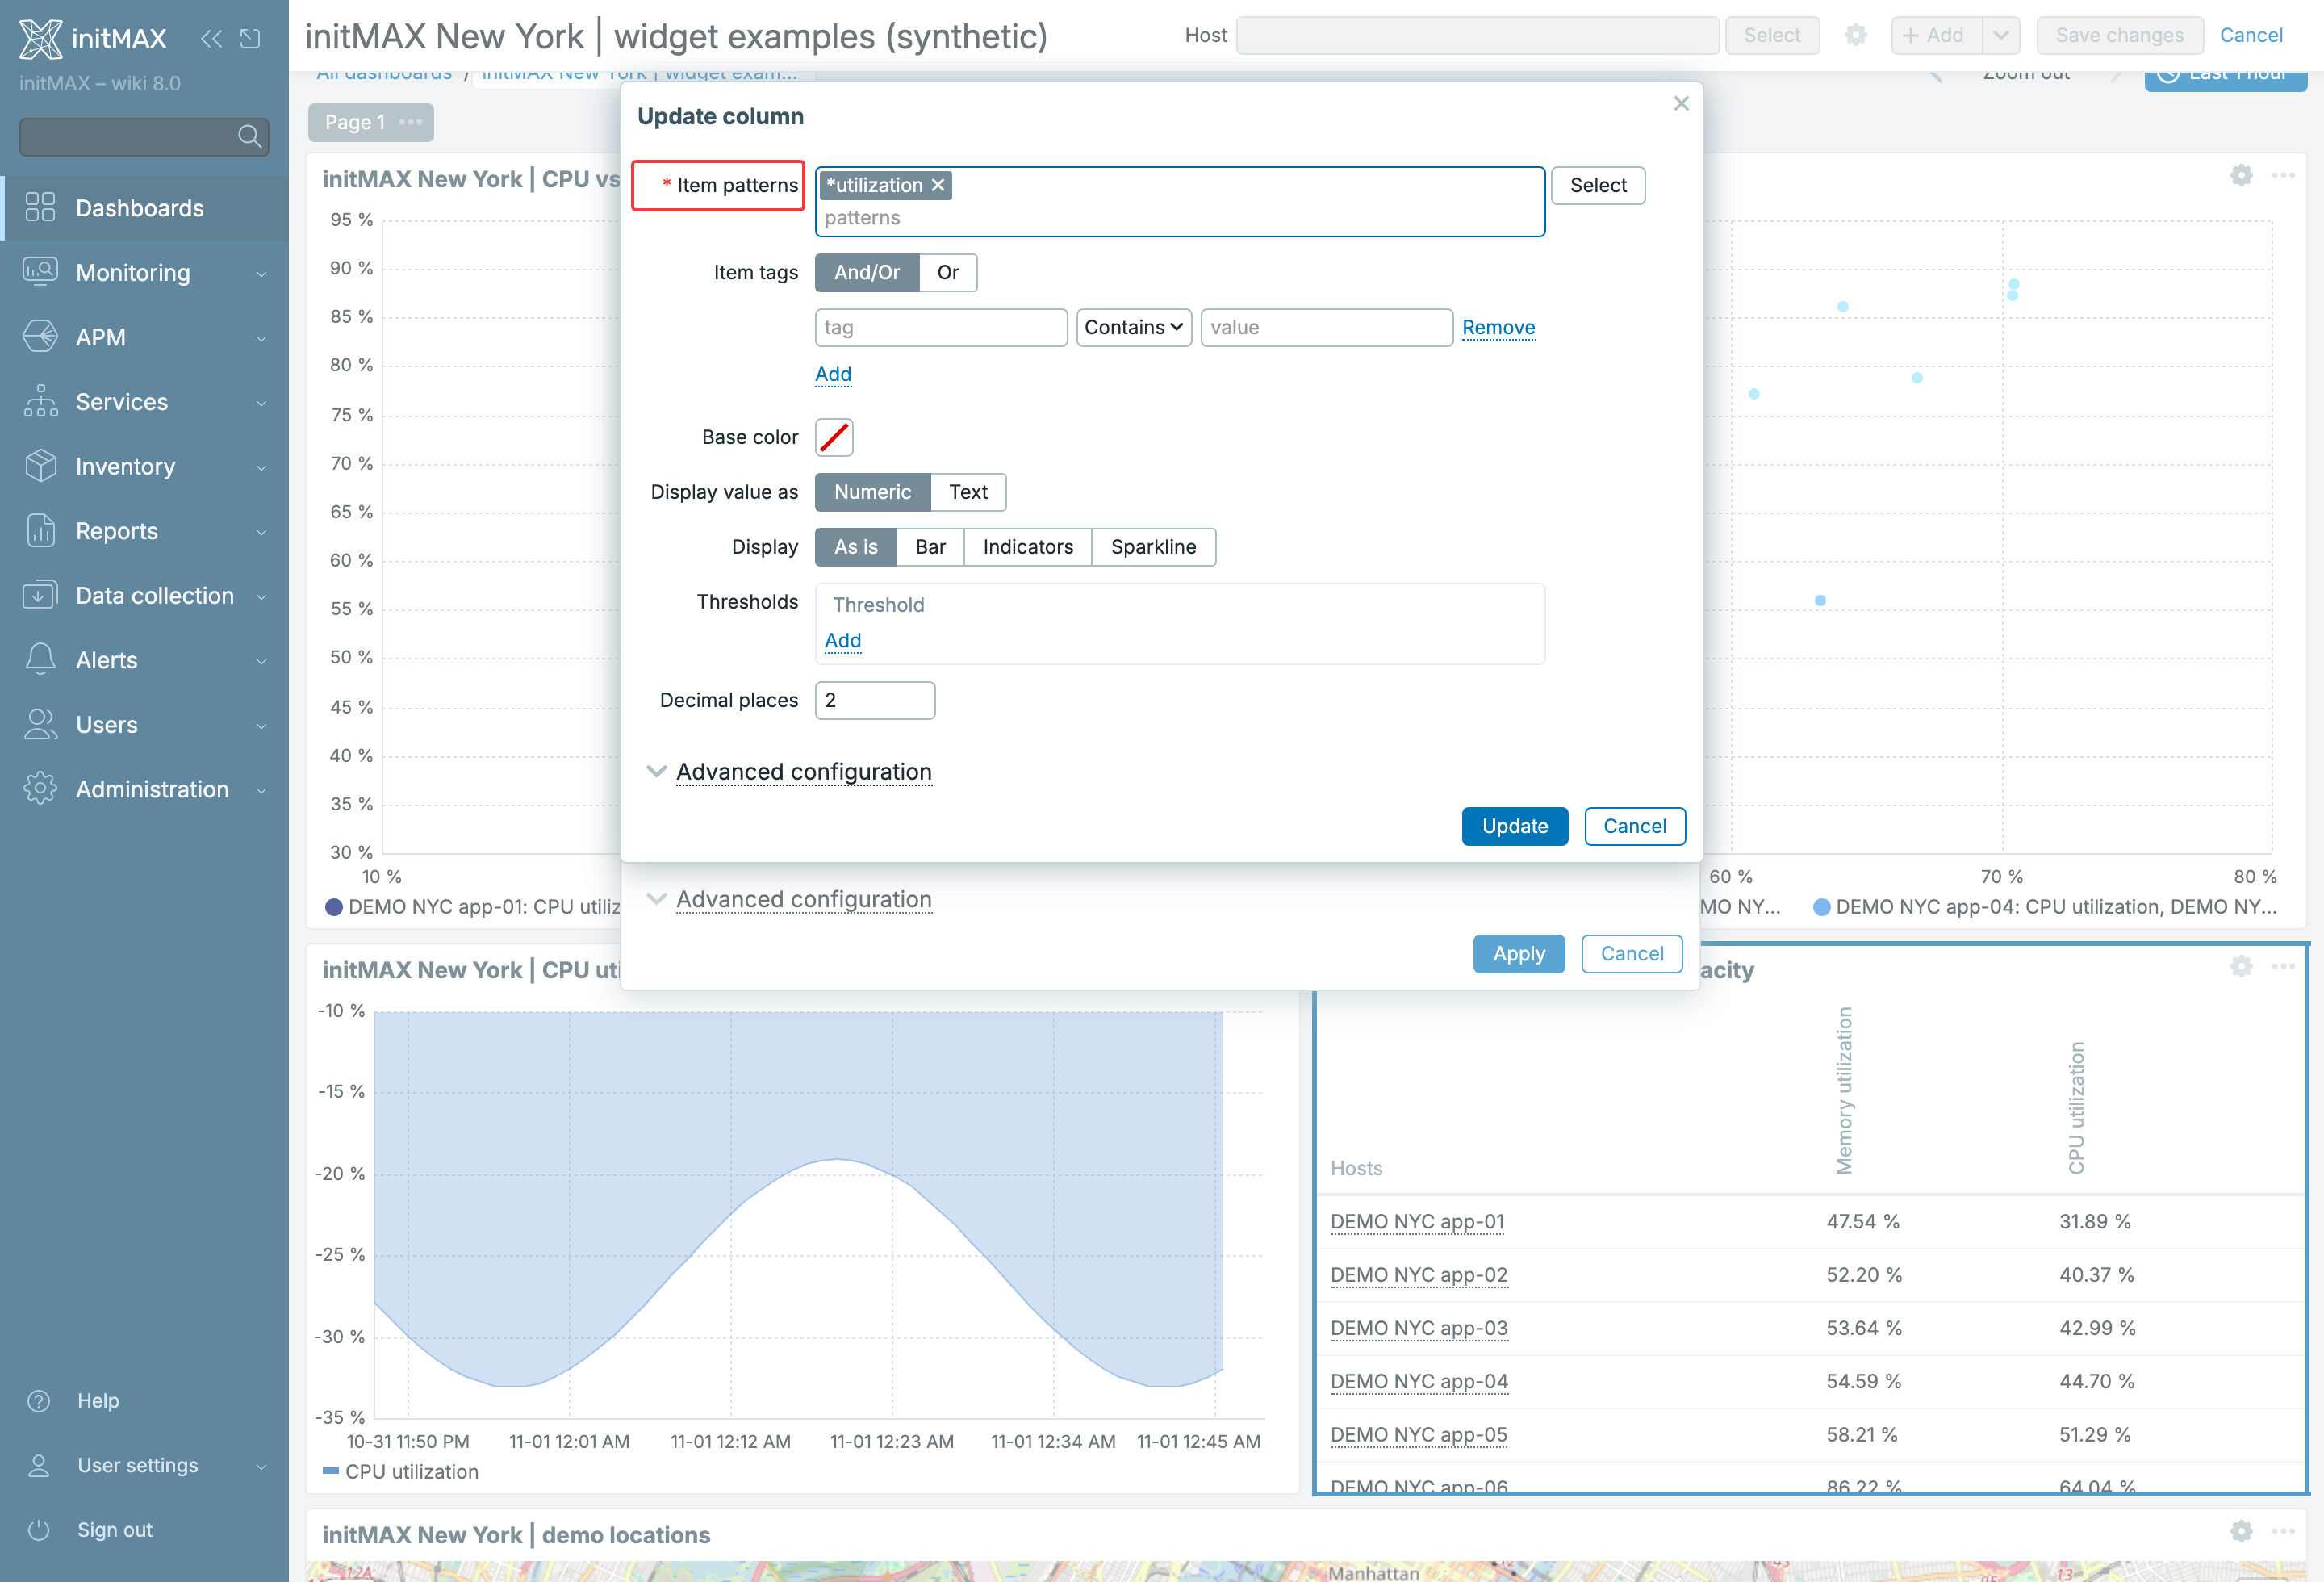
Slideshow dashboardu vypnutá ve výchozím stavu
Nově vytvořené dashboardy mají Start slideshow vypnuté a slideshow se dá zapnout parametrem v URL (&slideshow=on). Hodí se pro sdílené odkazy na obrazovky v dohledovém centru, kde má jeden odkaz rotovat a druhý stát.
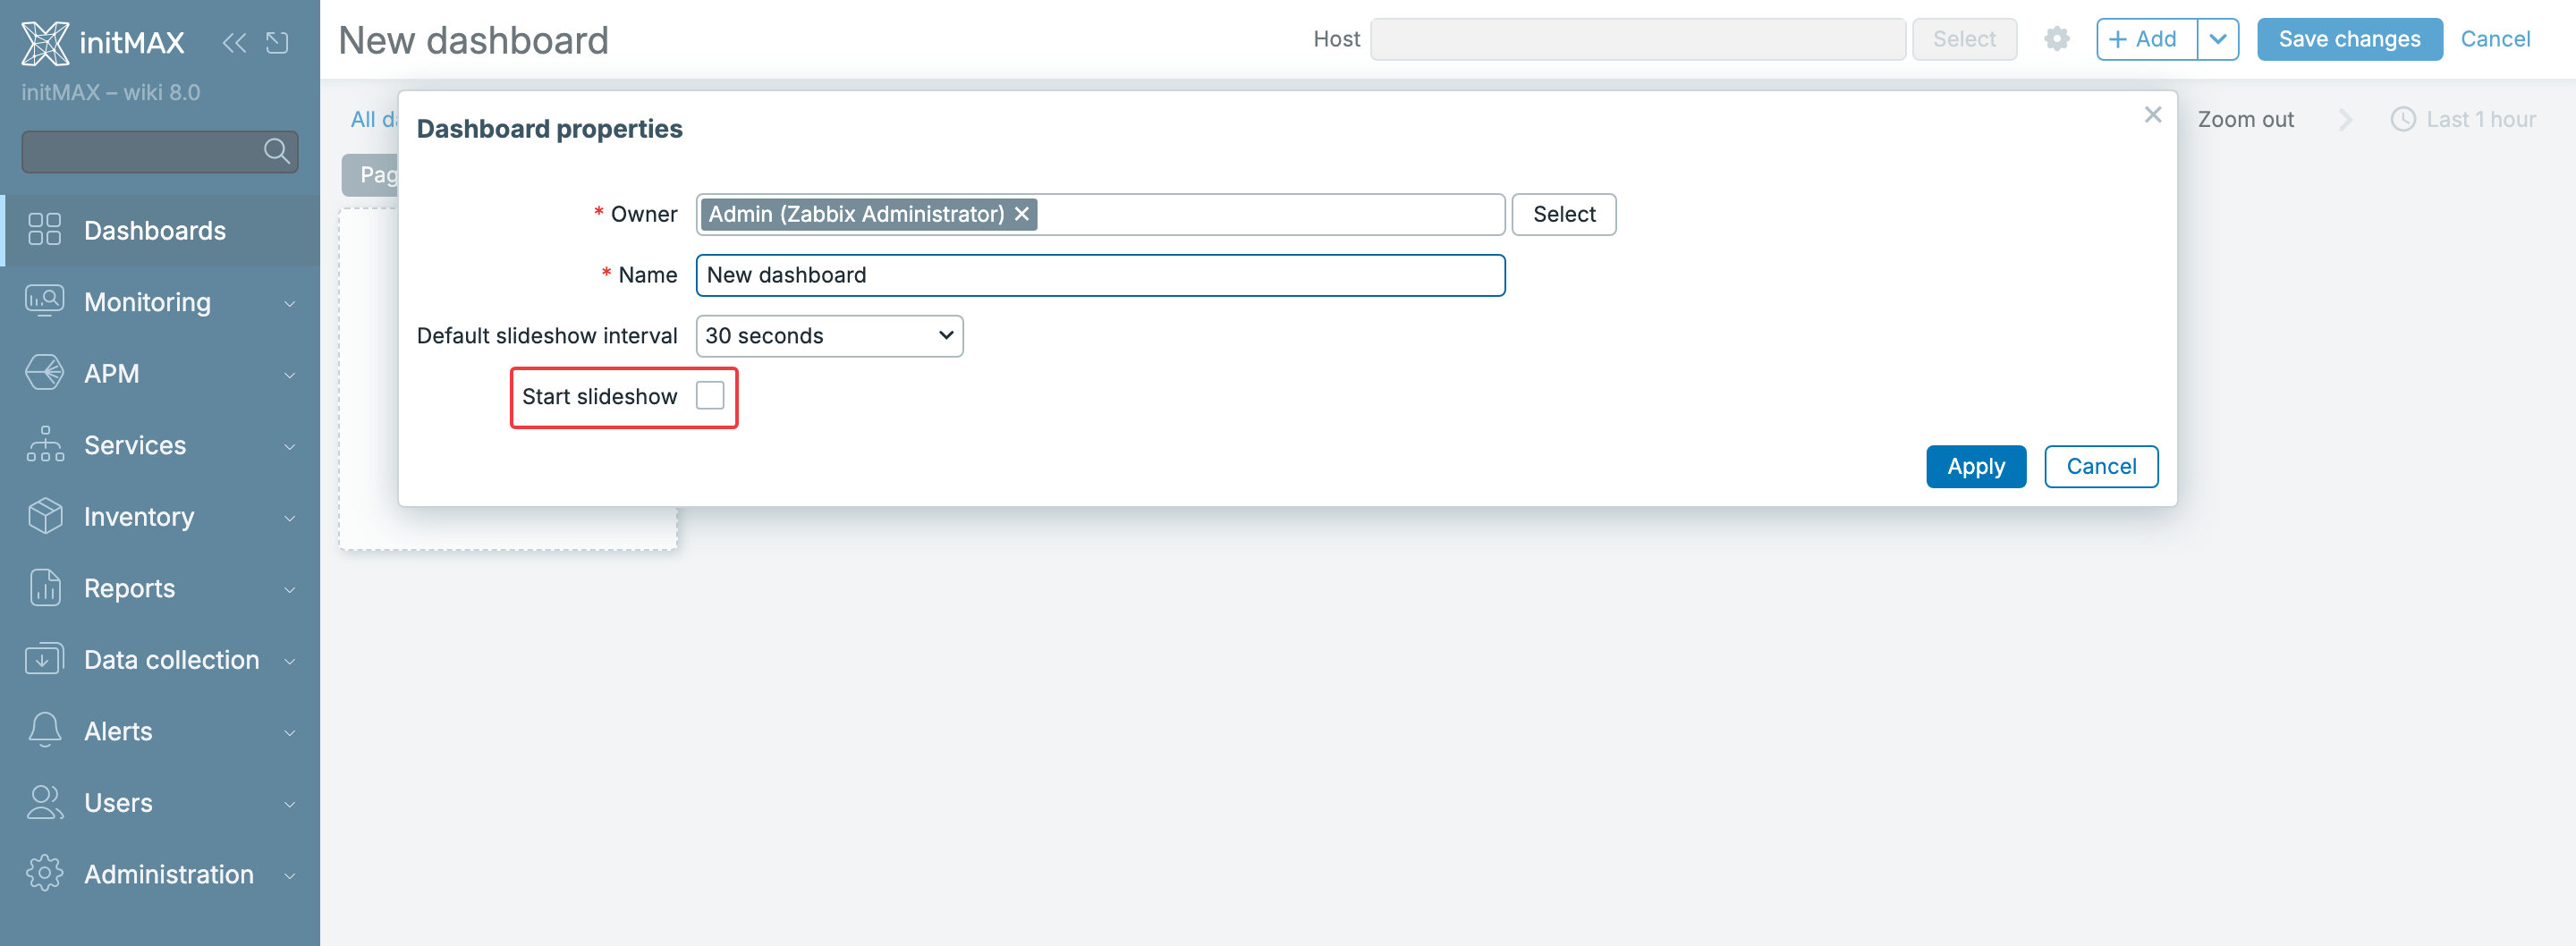
Import a export globálních regulárních výrazů
Globální regulární výrazy mají Import a Export ve stejném YAML/JSON/XML formátu jako šablony, takže je lze verzovat a přenášet mezi instancemi stejně jako zbytek konfigurace.
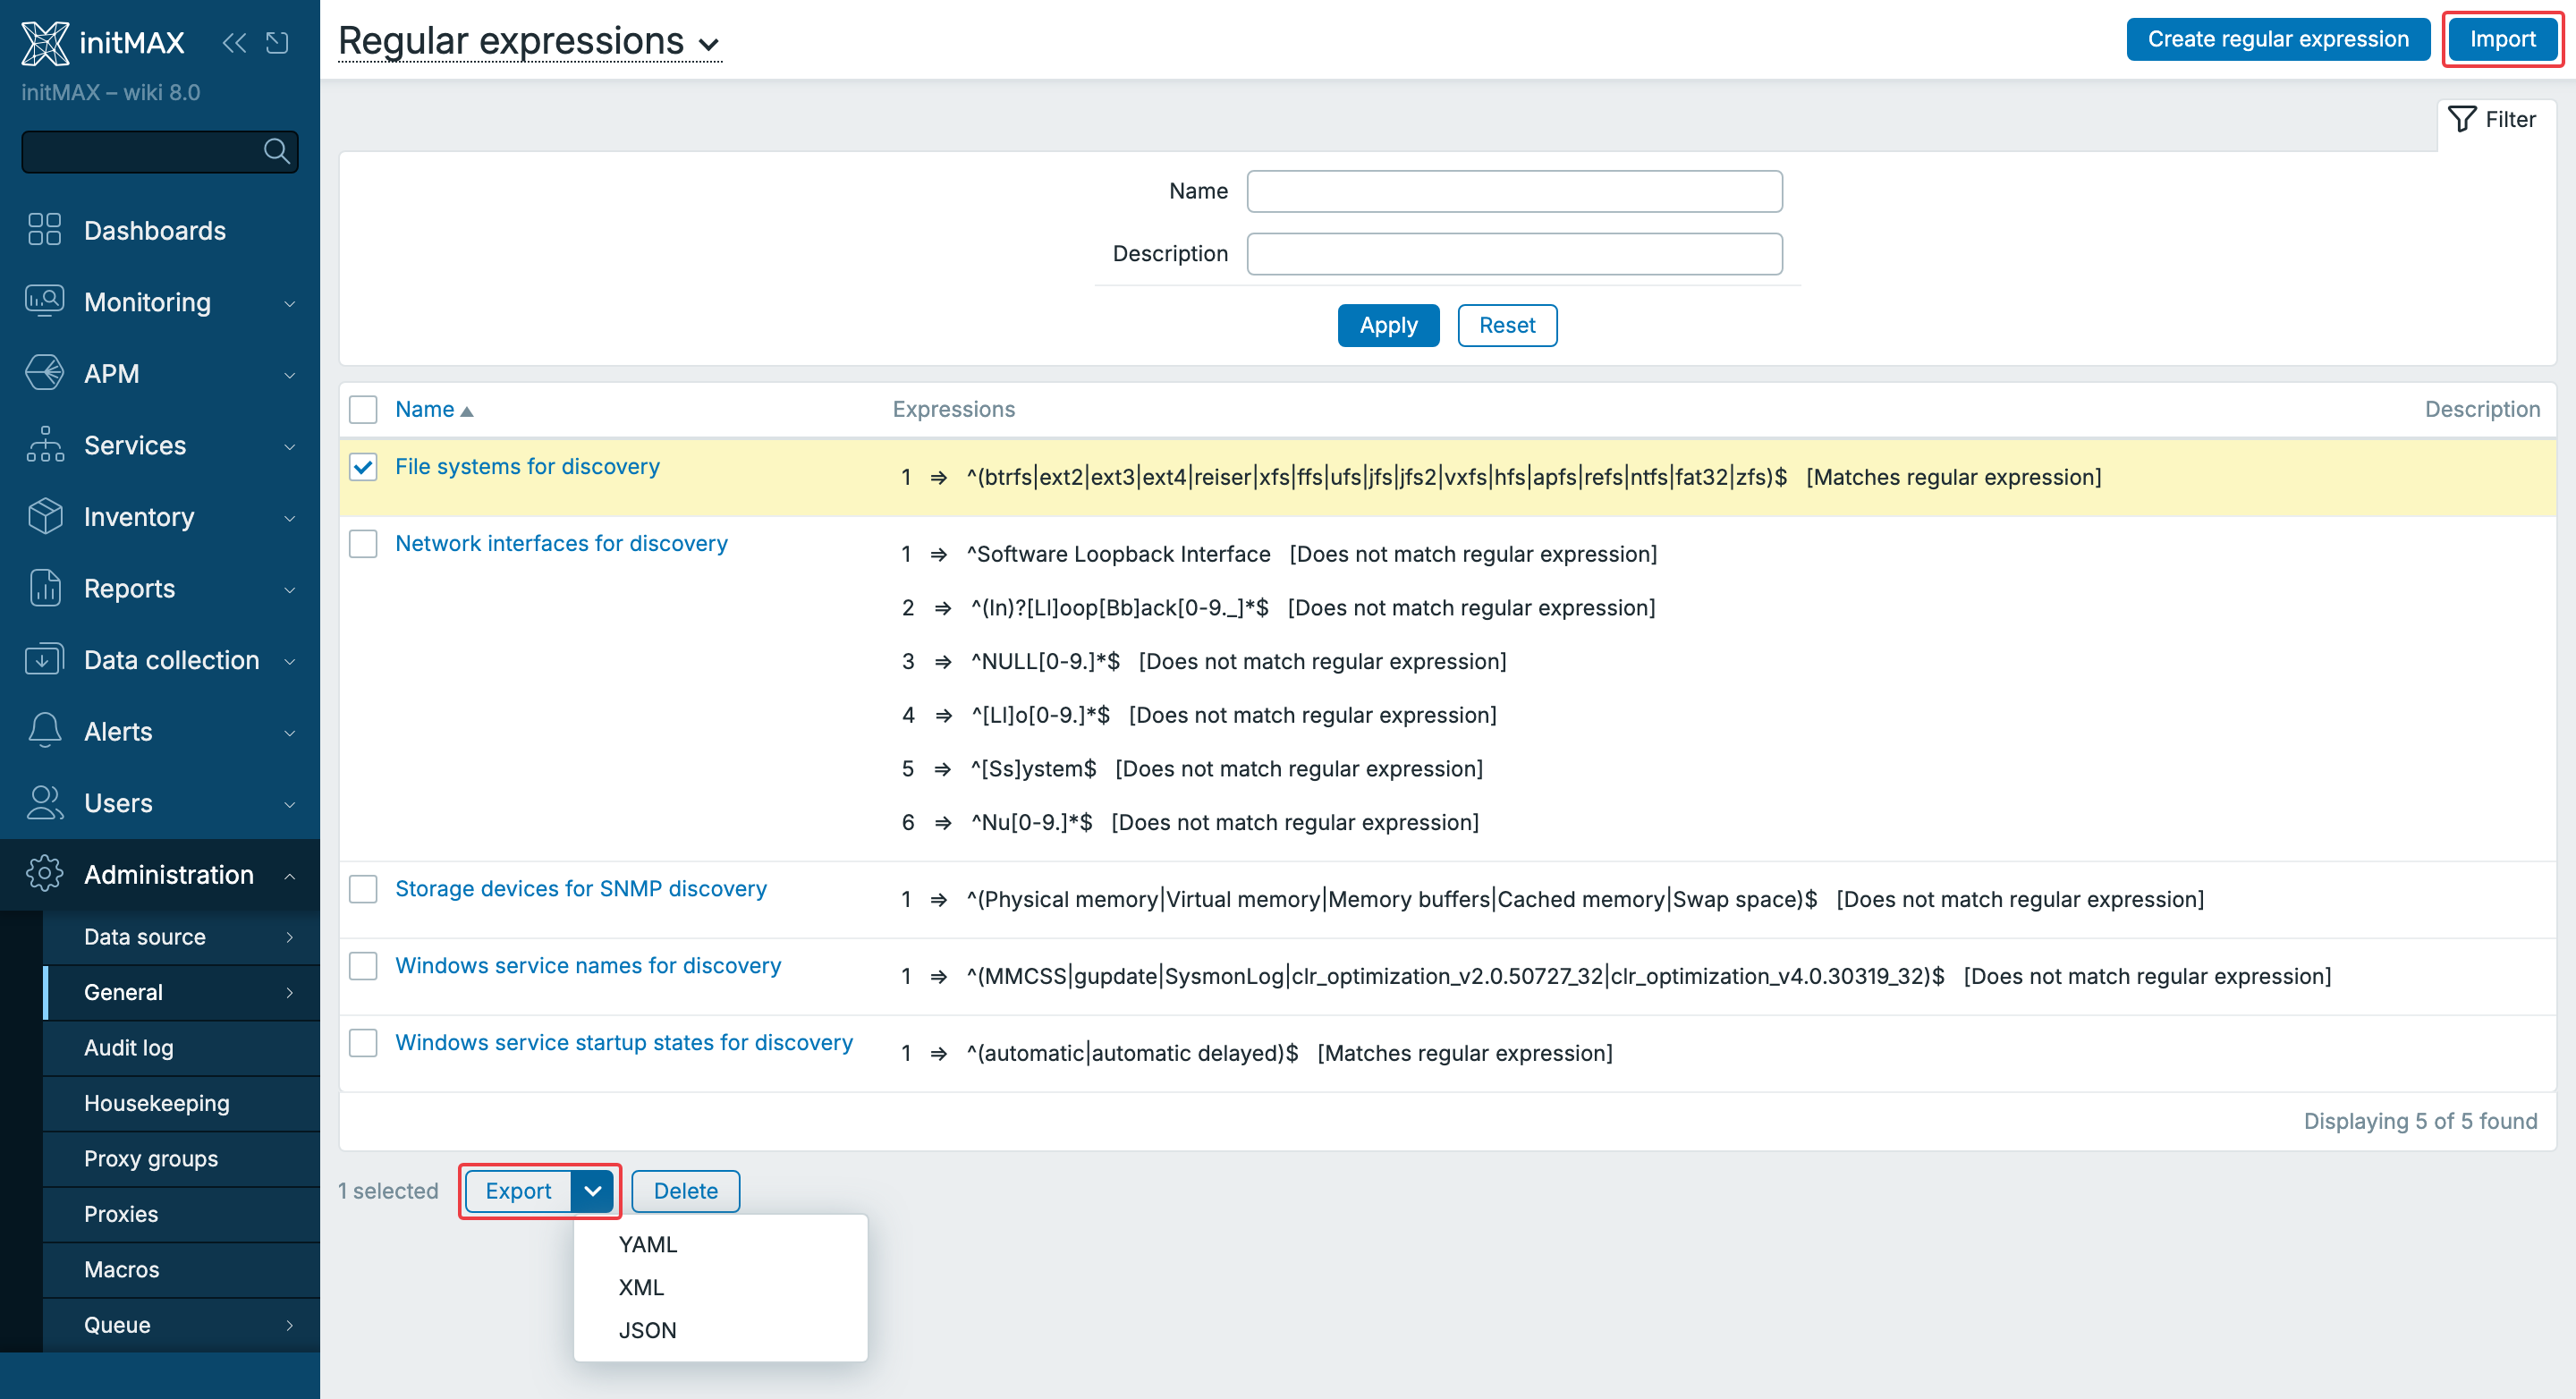
Create proxy in Cloud a menu Subscriptions
Stránka proxy dostala tlačítko Create proxy in Cloud pro instalace propojené se Zabbix Cloud a v menu nápovědy nahradila zastaralou položku Support položka Subscriptions.
E-mailová vlákna pro problém a recovery
E-maily ze Zabbixu mají hlavičku Message-ID a správně vyplněné In-Reply-To, takže se problém a jeho recovery v poštovním klientovi sbalí do jednoho vlákna. Makro {EVENT.RECOVERY.TAGS} se nově resolvuje i při ručním uzavření problému.
Housekeeper: mazání událostí a odložené mazání
Housekeeper při smazání triggeru odstraní i jeho události, ne jen problémy, a mazání velkých objemů historie po smazání položek běží přes tabulku odložených úloh, takže samotné smazání položky v UI nečeká na databázi.
Na co si dát pozor při upgradu
Upgrade nejprve ověřte na kopii databáze a konfigurace; kromě dostupnosti ověřte integrace, vlastní moduly a očekávané chování rolí. APM vyžaduje další provozní komponenty jen tehdy, když tuto funkci chcete používat. Verze komponent uvedené níže odpovídají podporovanému rozsahu Zabbixu 8.0, nikoli doporučení používat starší nepodporovanou databázi.
Minimální verze
Podporované rozsahy jsou PHP 8.2–8.5, MySQL a Percona 8.4–9.7, MariaDB 10.11–12.3, PostgreSQL 15–18 a TimescaleDB 2.20–2.29. Jde o podporované verze, ne o spodní technický limit, při kterém se server ještě spustí. Volitelný ClickHouse backend pro běžnou historii položek má rozsah 26.3–26.9; toto nastavení je oddělené od telemetrického úložiště APM. Pro produkci vybírejte podporované stabilní verze a ověřte také vzájemnou kompatibilitu PostgreSQL a TimescaleDB.
Odstraněné API metody
Odstraňují se metody host.massupdate, template.massupdate, hostgroup.massupdate, templategroup.massupdate a hostinterface.replacehostinterfaces. Pro hromadné změny hostů, šablon a skupin použijte jejich aktuální API. U hostinterface.* zůstává veřejně dostupná pouze hostinterface.get; hostinterface.update není náhradou. Zápisy síťových rozhraní je třeba převést na podporované operace host API s polem interfaces a zachovat ID existujících rozhraní. Nové role mají přístup k API vypnutý.
Odstraněná makra
Končí dlouho deprecated {ACK.DATE}, {ACK.TIME}, {ACK.MESSAGE}, {EVENT.ACK.HISTORY}, {IPADDRESS}, {HOSTNAME}, {TRIGGER.KEY}, {TRIGGER.COMMENT}, {STATUS}, {PROFILE.*} a {USER.ALIAS}. Před upgradem projděte media typy, akce a skripty a nahraďte je aktuálními ekvivalenty ({EVENT.UPDATE.*}, {HOST.IP}, {HOST.HOST}, {ITEM.KEY}, {TRIGGER.DESCRIPTION}, {TRIGGER.STATUS}, {INVENTORY.*}, {USER.USERNAME}).
Odstranění se týká i číslovaných variant {HOSTNAME1} až {HOSTNAME9} a {IPADDRESS1} až {IPADDRESS9}. U názvu hosta používejte {HOST.HOST}, nikoli {HOST.NAME}: první makro vrací technické jméno, druhé zobrazovaný název. Historii aktualizací události získáte pomocí {EVENT.UPDATE.HISTORY} místo {EVENT.ACK.HISTORY}.
Protokoly
Odstraněna je podpora legacy textového a XML protokolu z dob před Zabbixem 1.6. Prověřte velmi staré agenty a vlastní sendery; pro běžné instalace s aktuálním Zabbix protokolem nejde o změnu formátu odesílaných hodnot.
Minimální kompatibilní verze klasického Zabbix agenta se tím posouvá z 1.4 na 1.6. Nejde o změnu minima agenta 2, který je podporovaný od řady 4.4.
Nové a aktualizované šablony
Vedle nových integrací přibývají šablony pro OpenTelemetry. Umožňují začít s hotovými položkami, discovery a triggery místo skládání každého telemetrického dotazu ručně.
Existující šablony se upgradem Zabbixu automaticky nepřepíšou. Nové verze je potřeba naimportovat a porovnat s vlastními úpravami. HTTP šablony nyní standardně ověřují TLS certifikát cíle; u interní certifikační autority nejprve vyřešte její důvěryhodnost. Aktualizované OS šablony s vfs.fs.get[short] a vfs.fs.get[full,{#FSNAME}] vyžadují Zabbix agenta 8.0 nebo novějšího.
Nové šablony:
- OpenTelemetry: Generic OpenTelemetry by OTLP (obecný přehled traces, metrik a logů), Proxmox VE by OTLP (metriky virtualizačních uzlů), Envoy Proxy by OTLP (traces a logy proxy), OpenRouter traces by OTLP (průběh a chybovost požadavků na modely).
- Cloud a náklady: AWS Backup Vault by HTTP, Oracle Cloud Costs by HTTP, GCP Cost Monitoring by HTTP, GCP Cloud Storage Bucket by HTTP, GCP Cloud Run Service by HTTP, GCP Application Load Balancer by HTTP, Oracle Cloud Load Balancer by HTTP, Azure Container Apps by HTTP, Azure Sentinel by HTTP
- Databáze: MariaDB by Zabbix agent / agent active / by ODBC, Percona by Zabbix agent / agent active / by ODBC
- Kontejnery a virtualizace: Kubernetes Cluster by HTTP, Podman by Zabbix agent / agent active / by HTTP, Microsoft Hyper-V Failover Cluster by SSH a Microsoft Hyper-V Standalone by SSH
- Aplikace a AI: OpenAI Platform by HTTP, Claude API by HTTP, GitHub organization by HTTP (včetně Copilotu), GLPI by HTTP
- Síť: Aruba CX 8300s by SNMP, Cisco Secure Firewall Threat Defense by HTTP, Ciena 3906 by SNMP, Stormshield SNS by SNMP, Vyatta Virtual Router by SNMP, Ribbon SBC Edge / SWe Core / SWe CE by HTTP, VeloCloud SD-WAN Edge by HTTP, Huawei AR600 by SNMP, Cradlepoint NCM v2 by HTTP a Cradlepoint NCM v2 device by HTTP
- Ostatní: Domain RDAP by HTTP, webhook pro IBM Maximo (zakládání service requestů)
Aktualizované šablony:
- AIX, FreeBSD, HP-UX, Linux, macOS, OpenBSD, Solaris a Windows: sběr filesystemů přes
vfs.fs.get; Linux navíc nové dashboardy,net.if.getavfs.dev.get, AIX sběr blokových zařízení přesvfs.dev.get. - MySQL by Zabbix agent a by ODBC (nové metriky, discovery tabulek a replik, nové dashboardy, podpora nové syntaxe), PostgreSQL by Zabbix agent a by ODBC
- Proxmox VE by HTTP (nested LLD, mapování SMART statusu), VMware (discovery alarmů), Veeam Backup & Replication a Veeam Backup Enterprise Manager by HTTP (aktualizace pro Veeam 13.1).
- Microsoft 365 reports by HTTP a GitHub organization by HTTP (Copilot), GitHub repository by HTTP
- Zabbix server health (cache trendových funkcí) a health šablony serveru i proxy (vytížení Telemetry query pollerů).
- SNMP šablony (lepší trigger na uptime zařízení), Cisco (regex verze), Meraki (mapování stavů, nový trigger)
- AWS Cost Explorer a Azure Cost Management by HTTP (nové dashboardy), společné multicloud dashboardy pro virtuální stroje i náklady.
- Redis by Zabbix agent 2 (makra pro autentizaci), Ceph by Zabbix agent 2 (native connection mode)
- Nextcloud by HTTP, NetApp AFF A700 by HTTP, MSSQL, RabbitMQ (drobné opravy)
- Aktualizované dashboardy: Kubernetes Cluster a Node by HTTP, Podman by HTTP a Proxmox VE by HTTP. Zabbix server health má přepracovaný přehled stavu serveru a jeho procesů. Linux by SNMP upravuje discovery filtry EtherLike-MIB.
Windows by Zabbix agent a agent active rozšiřují monitoring o naplánované úlohy, profily Windows Firewallu a svazky chráněné BitLockerem. Linux by Prom a Linux by SNMP mají také upravené dashboardy.
Zabbix ke stažení a další užitečné odkazy
- Zabbix 8.0 LTS ke stažení: oficiální balíčky Zabbixu.
- Sestavení ze zdrojů: zdrojové balíčky Zabbixu.
- Dokumentace novinek: What’s new in Zabbix 8.0.
Jako oficiální partneři a velcí fanoušci Zabbix platformy jsme schopni vám poskytnout služby ze všech oblastí Zabbix monitoringu na té nejvyšší úrovni. Pokud by vás zajímala živá ukázka instalací Zabbixu u našich zákazníků, rádi vám ukážeme Zabbix v praxi.